


亚马逊销量与排名的幂函数关系解析
通过数学模型精准预估产品排名,优化运营策略
在亚马逊平台,销量是影响产品排名的核心因素之一,但并非唯一决定因素。本文基于幂函数模型,深入剖析销量与排名之间的数学关系,帮助卖家更科学地制定运营目标。

研究该关系需一定的数学基础,理解困难者可直接参考后续结论应用。
要估算日出10单对应的产品排名,需掌握两个关键参数:第一名的日订单量,以及整体订单量的分布规律。
第一名订单量通常可通过历史数据获取,多取某时间段的平均值。而订单分布规律则体现为“集中”或“分散”特征:部分类目头部集中、尾部稀疏;另一些则分布较为均匀。
这一分布特性通过“分布系数k”量化。k值越大,订单越向头部集中,后续商家销量下降快但排名降幅小;k值越小,订单分布越分散,销量递减缓慢但排名迅速下滑,符合幂函数特性(见上图)。
分布系数k的合理取值范围一般为0.5–1.2,多数场景下0.8–1.0更为贴近实际。k值可结合头部商家订单占比进行反向推估,但不可直接等同于占比数值。
设第一名日销量为N,排名第r的商家销量为n,则销量与排名的关系可用如下幂函数表示:

由此可推导出核心计算公式:
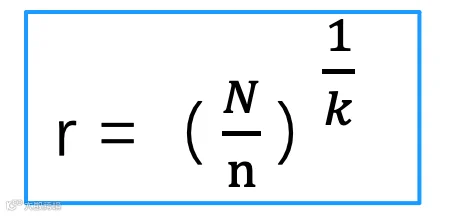

以日销量10单为例,假设分布系数k=0.8:
- 当第一名日销150单时,排名约在40–45名;
- 当第一名日销100单时,排名约在15–20名;
- 当第一名日销50单时,排名约在7–8名。
k值的影响机制如下:
k值越大,表示类目集中度高,少量订单即可获得较高排名;k值越小,说明分布分散,相同销量对应的排名更低。
继续以第一名日销150单为例:
- 若k=1(高度集中),日销10单可排至第15名左右;
- 若k=0.5(高度分散),日销10单排名将跌至约第225名。
运营启示:
相同销量在不同集中度的类目中,排名差异显著。高集中度类目中,少量订单即可进入前列;低集中度类目则需更大销量支撑相同排名。
以两个细分类目A和B为例:
假设A类目k值较高(集中),B类目k值较低(分散),两款产品在各自类目均位列第10名。
由于A类目分母更大,达到第10名所需销量n更小;而B类目因分布分散,需更高销量才能维持相同排名。
因此,在高集中度类目中,更容易以较低销量实现高排名。
实际运营中,应结合具体类目的订单分布动态调整k值,但该幂函数模型可作为通用估算框架,辅助销量目标设定与排名预测。