


杨植麟迟到了一会儿,穿着有褶皱的黑色T恤,拿起麦当劳汉堡匆忙啃了几口。此刻是2025年7月底,Kimi K2模型发布不久。
距离上一次访谈,已经过去一年半。2024年1月,我第一次在一间暗沉并伴有空调嗡嗡声的会议室见到杨植麟。那年3月,我发表了《月之暗面杨植麟复盘大模型创业这一年:向延绵而未知的雪山前进》。当时,他32岁,刚成立一年的大模型公司引起关注。
作为学术背景与大语言模型高度契合的创始人,很快,他获得了名望,争议也接踵而至。
此后一年,他几乎不再参加访谈或活动,仿佛将自己封锁。2025年初,DeepSeek达到了全球极致的声望。公司内部,员工难以察觉他的情绪波动,只发现,他把飞书名后缀加上了“时间的朋友”。
2025年7月,Kimi K2模型发布,这家公司才重回公众视野。它是一个基于MoE架构的开源编程和Agentic大语言模型。形象来说,模型借助编程能力走出封闭的“缸中之脑”,长出了“手”,开始操控外部数字世界。《自然》杂志甚至用“又一个DeepSeek时刻”来形容。
在过去一年的舆论风暴与创业起伏中,杨植麟反复阅读了英国物理学家David Deutsch的书《The Beginning of Infinity》(无穷的开始),书中两句话深刻影响了他——“问题是不可避免的”,“问题是可以被解决的”。
在他看来,人类文明就是不断征服问题、拓展知识边界的过程。一个问题解决完,会生出更多新问题,研究的空间由此开阔,知识的边界得以延伸。
“这也正是它有意思的地方——你总有新问题去解决,而每当解决一个问题,技术就能再往上攀登几百米。也许有一天会发现,这座雪山没有尽头——我不知道——我希望它一直没有尽头。The Beginning of Infinity的意思,就是这样:它是一座无限的山。”
这是一段“人与AI”、“登山者与山峰”、“人类个体与机器系统”之间相互征服的故事。
只是如今,杨植麟还在山腰,风雪未停。
以下是对杨植麟的访谈节选(作者进行了语言优化。)
我们同步推出了本集的视频和播客,视频在Bilibili上线,播客在小宇宙、苹果Podcast、Spotify上线。请搜索账号:张小珺商业访谈录。
如果你喜爱我们的内容,请关注/收藏我们 。你的喜爱对我们来说,真的很重要。

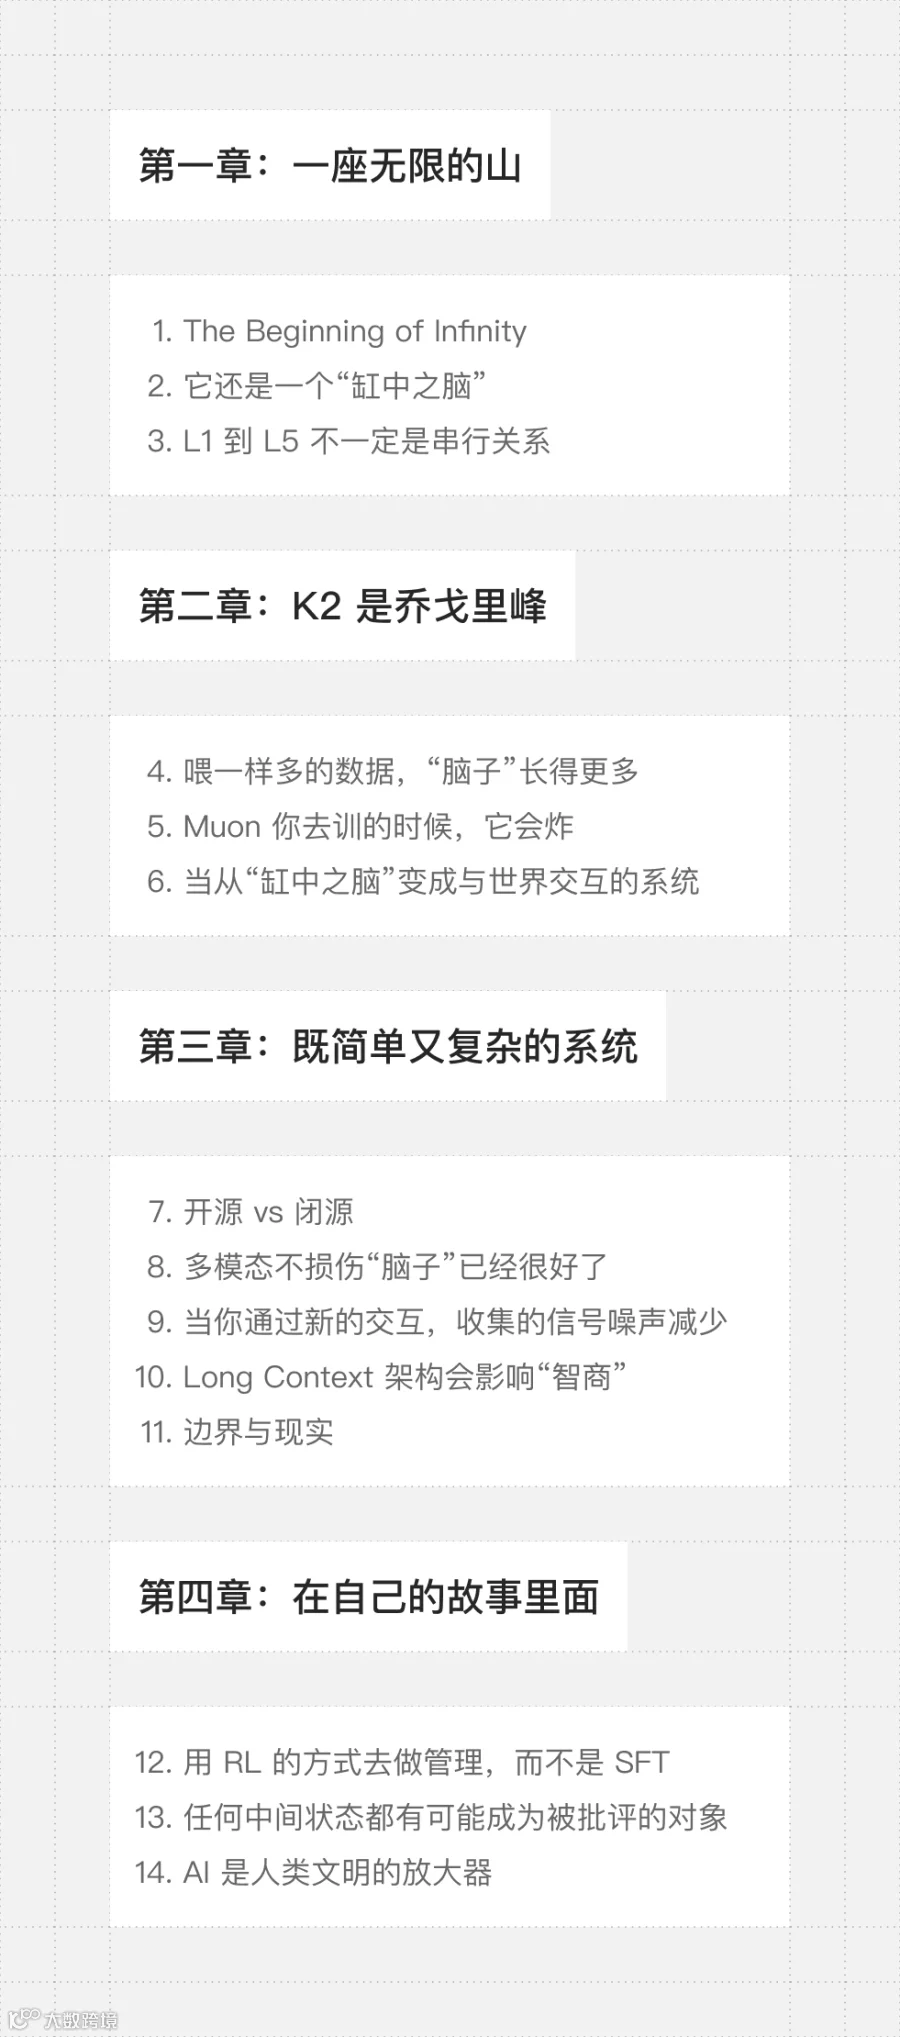
第一章 一座无限的山
01 The Beginning of Infinity
张小珺:在你创业第一年结束的时候,2024年我们访谈标题是《向延绵而未知的雪山前进》。现在又过了一年,站在此刻,2025年7月,你最新的感受是怎样的?
杨植麟:你刚刚提到这个词,我感觉好像过了很久……AI一天,人间一年。AI的一年我不知道是人间多少天。确实很多东西发生了变化,但你说的“雪山的感觉”,倒是差不太多的。
往山顶,我们又走了一段距离。
张小珺:现在行进到哪里了?
杨植麟:站在现在看,模型的进步挺大——两年前写一篇文章写不太明白,现在不光可以写很好的文章,还能连续工作几小时,帮你完成一个很复杂的代码任务。两年前很难想象。
在爬雪山的过程中,解锁了一些新的场景,大概知道中间这条路是什么样;但同时,在往上的过程中,你还是观察到差不多的景象——接下来,仍然会有很多未知的技术问题要去解决。
张小珺:在四下都是大雪的山峰上,你是更清晰了,还是更迷惘了?
杨植麟:肯定会有很多东西变得更清楚。两年前各种强化学习(RL,Reinforcement Learning)的范式该怎么做,怎么让模型有更强的推理能力,或更强的Agentic(智能体式)能力,没那么清楚。当时更多关注模型的预训练(Pre-Training)怎么做得更好,怎么用RLHF(Reinforcement Learning from Human Feedback,人类反馈强化学习)提升对话体验。
但现在有一些问题得到了答案,同时这些答案又展开,带来了新的别的问题。
现在虽然可以做强化学习,但它最终还是依赖一个很好的评估或验证。你让模型去做一道数学题,或者做一些有test case(测试样例)编程任务,可能做得比较好。但如果让它去做一个更复杂的端到端任务,有时很难找到一个评估或衡量方式。所以,这个系统会产生新的问题。
这有点像我最近在看的一本书,叫The Beginning of Infinity(无穷的开始),我看了好几遍。他说,有两句话可以刻在石头上:一句是“问题是不可避免的”,另一句是“问题是可以解决的”。

-
《无穷的开始》(The Beginning of Infinity)是物理学家David Deutsch撰写的一本科普哲学著作。 -
书中观点:科学知识和理性探究能带来无限的进步和理解,世界上的问题无穷无尽,但绝大多数问题都可以通过理性思考和科学方法得到解决。知识的增长无界限,科学探索是一个不断解决问题、产生新问题的过程,这是人类文明不断前进的动力。
你可以认为,启蒙运动前,这个社会是静态的。大家不追求创新,你会用很多神秘主义解释所看到的现象,但这些解释并不是好的解释。比如,你看到天上打雷,会觉得雷公在发怒;你看到冬天下雪,会说某个神心情不好——整个社会结构静态,只有极少数人在真正做科学研究或知识创造。
但启蒙运动之后,社会变成动态的,新的知识不断被创造。每当你解决一个问题,就会带来新的问题。问题是源源不断,因为你的知识边界在拓展,你就会遇到新的问题。
现在做AI研发也恰好处于这样的状态。你解决了强化学习的一些问题,接下来就遇到评估、衡量、验证这些问题,又需要我们寻找新的答案。
但这也正是它有意思的地方——你总是会有新的问题去解决,而每当你解决一个问题,技术就能再往上再攀登几百米。
也许有一天会发现,这座雪山没有尽头——我不知道——我希望它一直没有尽头。
The Beginning of Infinity的意思就是这样:
它是一座无限的山。
02 它还是一个“缸中之脑”
张小珺:我们回望一下,过去一年全球大模型在你脑海中最重要的几件事是什么?有哪些是人工智能范式级的变化?
杨植麟:一个是,长思考的推理模型(Reasoning Model),以o1作为第一个做出来的代表。本质上,它通过让模型在过程中做很多尝试和反思,反思是其中重点。
反思是两种能力:一种是提出新的猜想,一种是验证猜想。
你可以理解为:模型在解决问题的过程中,会不断提出新的猜想,这个猜想会得到自我验证。比如,它提出这个猜想之后,要判断是对是错,需要具备一定的验证能力。虽然你不是显式地训练一个验证模型,但它在推理过程中隐式地进行了验证。它对这个问题做了多次猜想和验证,最后得到一个答案。
这大大提升了模型的能力。你本来只能做一次,直接给出一个答案,这个答案可能对,也可能错,你没有这个过程。但现在你可以不断提出猜想去验证,相当于等价尝试了好几次。
你可以把Pass@k变成Pass@1,本质是这样的道理。
Pass@k是用于评估大模型的一种指标,表示模型在一次任务中生成k个候选答案时,至少有一个答案正确的概率。
这跟人做科研或解题的过程很像,不断提出新的猜想,然后验证它。
张小珺:是一个自由探索的过程,而不是一个线性的过程。
杨植麟:它有效的工作方式,很多时候还是比较线性。如果不考虑并行采样,假设做的是串行采样,它就是线性过程。
你每次提出新的猜想,这个猜想可能基于之前的猜想,甚至是你已经否定过的猜想,再提出一个新的猜想。它会接近更线性的过程。
现在你也可以把线性过程和并行策略搭配,比如同时采样很多个,结合了并行和串行两种方式。最近也有一些paper讲串行采样上限更高,这跟我们实验结论相关。
上面说的是一种范式,但它还是一个“缸中之脑”(brain in a vat),并不需要跟外界交互。
张小珺:缸中之脑?
杨植麟:想象一个鱼缸,你把一个脑子放在里面,跟外界没有联系。它只是在自己大脑里面想,一直想,不需要跟外界产生任何交互,就能解一道题。
但有另一个很重要的范式,就是基于多轮的Agent(智能体)强化学习范式,或者通过强化学习技术训练出来的Agentic模型,它的特点是会跟外界做很多交互。
比如我边思考边去做一些操作,可能做很多轮操作,一会儿调用一个搜索,一会儿使用一下浏览器,一会儿写几行代码,通过多轮解决一个问题。
它就不再是“缸中之脑”,是跟外界有交互的——我的下一步行为,是根据交互中得到的反馈,和外界给我的新状态的更新有关系。
但这两个东西都指向了同一个东西,是:test-time scaling(测试时扩展)。意思是,可以在测试时,或者在推理时,做到更好的规模化。
比如之前做Chat(聊天),更多是单轮地输出一个结果:我让你写一篇文章,你就写一篇文章;我再让你润色一下,你又输出几百个token(词元),这个token数量是很少的。但不管是基于长思考的强化学习,还是Agent的强化学习,本质上都是一种在预测时对token进行规模化扩展的方式。
你不管是把轮数打得更多,还是在每一轮有更多思考的token,都是一种规模化token的方法,让你能完成更复杂的任务。
这也伴随完成时间更长。你现在花几小时去做一件复杂的事,过程中不需要人工参与。比如,把一个代码仓库克隆下来,翻译成另一种新语言,调试、测试,把所有bug(漏洞)修复,让它能正常运行。这样的工作可以端到端完成,得益于测试时计算(test-time)的规模化。
还有一个很有意思的趋势是,现在有更多模型公司去做“一方的Agent产品”。
-
“一方的Agent产品”指:模型公司自己下场做产品,自己控制上下文环境、工具接口、prompt结构等,也就是自己当“使用方”,而不是只给别人提供模型API。
杨植麟:对,它本质做的是逆向工程这个模型的训练过程。因为模型训练过程也是通过各种手段——你可以认为Anthropic在内部(in-house)的环境、工具、脚手架,可能训练出这样一个模型,但它没有直接开放给你。
你通过逆向,更接近拟合它的分布——到底用什么工具效果会好?到底用什么样的System Prompt(系统提示)效果会好?到底用什么样的Context Engineering(上下文工程)效果会好?这是一个逆向的过程。
但你会发现,如果模型公司去做“一方的产品”,逻辑完全不一样。
你不再需要这个逆向的过程,更多是正向的做法。我先把这些工具设计好,我的Context Engineering(上下文工程)的方法都设计好,我就在这个环境里训练这个模型,所以模型天然在你的环境里表现更好。
这是两种不同思路,但第二种思路上限也许更高。
你可以更好整合工具和模型。模型如果有些地方解决不好,你可以调整工具设计,把它设计得更好,同时又可以端到端训练。这也是在开发方式一个比较大的变量。
张小珺:让大家比较好理解。第一种你说的脚手架,就是像Manus这种开发方式;第二种是你们这样的端到端训练模型的方式。
杨植麟:对。当然,我们现在在“一方产品”投入还不算特别多,是以模型为主线。但Claude Code或ChatGPT Agent,就是“一方的产品”,应该也会是一个很大趋势。
后面就看“一方”和“三方”产品怎么配合,在生态里会是什么样的状态。
张小珺:说到主线,OpenAI设置了从L1到L5的分级,我一直很好奇它背后的内在逻辑。
L1是Chatbot(聊天机器人),L2是Reasoner(推理者),L3是Agent(智能体),L4是Innovator(创新者),L5是Organizer(组织者)。
为什么是在有了Chatbot和Reasoner之后才有Agent?为什么接下来又是Innovator和Organizer?这个顺序在能力结构上是怎样递进的?
杨植麟:它是能力一步一步的依赖。Agent的(L3)上限取决于,你有很强的Reasoning(L2、推理)能力,但并不是必须先有Reasoning。
假设我们把技术发展的顺序稍微换一下,你先做出来Agent能力,再去做狭义的Reasoning,就是long CoT(长链式思维)的Reasoning,可能也是成立的。
你可以认为Claude的路线就是bet(押注)这一点:它在Reasoning上做得不是特别多,但在Agent上做得非常好。这背后是不同技术路径的bet(押注)。但最终你绕不开,如果你想往山顶再多爬几步,这两个能力都要有,只是时间问题。
所以,他们并不一定是互相依赖的。不是非得先做Reasoning再做Agent。但要做到最好的Agent,就必须把Reasoning也做到最好。而有了Agent的能力,就可以去做后面的一些事。
为什么说下一阶段(L4)是Innovation(创新)?这里面最关键的是:模型什么时候能参与模型本身的开发?只有当模型参与到开发过程,才能解锁真正的Innovator(创新者)阶段。
我们希望K2能参与到K3的开发,如果你没有Agentic能力,很难做到这件事。但当你具备了Agentic能力,它就可以提出一些新的想法,做对应的实验,分析实验结果,得出结论,迭代下一版想法,或者优化某个Infra(基础设施)性能。这些都依赖很强的Agentic能力才能做。
Innovation(L4、创新)和Organization(L5、组织)也不一定是完全线性的关系,有的也是并行的。我们已经看到这样的趋势——
比如说,当你有了一个Agent,就可以拓展成Multi-Agent System(多智能体系统)。你可以从一个Agent fork(分叉)出很多不同的Agents,让它们去做不同的事情。有些是串行的,有些是并行的,然后再合并,再拆分成不同的task(任务)。可能有的写测试,有的写文档,有的设计软件框架,有各自的分工。
-
Multi-Agent System(多智能体系统):由多个相互独立但可以协作或竞争的智能体组成的系统。 -
多智能体系统可以表现为多个由语言模型驱动的Agent在一个环境中协作、对话、解决任务,例如:一个Agent负责规划(planner),一个负责执行(executor),另一个监督结果(evaluator)。多个Agent扮演不同专家角色,围绕一个复杂问题展开“思辨式”讨论。
所以它不一定是线性关系,可能两个(L4和L5)同时发生。
但Reasoning(L2)和Agent(L3),可能是Innovation(L4)和Organization(L5)的前提。
张小珺:Innovation(L4)的标志是模型自我迭代,那Organization(L5)呢?
杨植麟:比较简单的一个思考是,它会是一个 Multi-Agent(多智能体)系统。
当然,你怎么把Multi-Agent系统很好地做端到端训练,不要过拟合到某几种Agent类型,让它有更好的泛化性,比较有挑战。
张小珺:Organization是模型的“雪山封顶”吗?
杨植麟:也不是,可能它真的就没有顶。
张小珺:所以你把L1到L5的分级当作一个什么样的刻度?
杨植麟:它是几个重要的技术milestone(里程碑),但它并不一定是串行关系。它不是我们预期某一个能力被解决之后,才去解决下面的问题。
比如Reasoning。如果你真的要解决开放性推理问题,就需要做很强的Innovation,提出新的模型架构,而这又对推理能力提出了更高要求。本质上,是用L4的方法去解决L2的问题,把L2做得更好。
这几个能力,随着时间推移,会持续变得更好。
不过,你在里面有不同技术bet,会让你短期路径出现一些区别。这些短期路径的区别也会有影响——因为你面对的是动态的市场。
张小珺:以前我们会固化认为终点是AGI,今天的终点不是AGI了,那么AGI是什么?
杨植麟:AGI不是某一级台阶,你爬到了这级台阶,突然一夜之间达到AGI。而是说:它是一个方向。
今天在很多领域,你可以认为已经AGI了,做得比99%人类更好。很多数学或编程竞赛,按现在的提升速度,预想很快有很多问题被充分解决。
AGI有两个层面:一方面技术一直在提升;另一方面是技术对人类社会的影响。后者是一个更长周期的事情,也是AGI的一部分。
这有点像蒸汽机产生后,社会变化需要几十、几百年去消化。一些工作变得不再必要,但会产生新的工作。每个人变成“超人”,可以做更多事情。社会的工作方式和运行效率会发生巨大变化。
虽然我们用“登月”(Moonshot)命名公司,但它跟登月有区别。登月是你站上月球那一刻,可以号称“我达到了”。而AI很难在某个时间突然喊出口号,说“我们此时此刻实现了AGI”。
你一直在往上爬。
甚至,过一段时间之后,不一定是你自己在爬,是你用AI在爬。现在我们让K2做数据处理、模型分析、模型训练,以前都要人工做,以后慢慢交给模型做——它像一个放大器,帮你更好地攀登这座山。
张小珺:如果雪山是无尽的,你追求的是什么?
杨植麟:就是攀登的过程。
你原来在山底下,现在又往上提升了一点,能看到的景色不一样。
它是一个动态进化的过程。

第二章 K2是乔戈里峰
04 喂一样多的数据,“脑子”长得更多
张小珺:我们来复盘一下,你创业这两年的关键决策。2023到2024年你的关键决策是——在23年2月决定了创业、开始融资、组建团队;到了下半年,Kimi上线了、bet了长文本。
2024到2025年,这一年你的几个关键决策是什么?
杨植麟:很重要的一点是,技术上我们从以预训练和SFT(Supervised Fine-Tuning,监督微调)为重点研发范式,转变成以预训练和强化学习为重点的方式。这就需要做很多事——不管是人才的储备,还是研发方式的改变。
另一点是,从对话到Agent是一个重要范式转变,很大程度影响我们的实际工作方式。
张小珺:过去半年你们推出了K1.5和K2,它们分别对Kimi意味着什么?
杨植麟:K1.5更多是强化学习技术的验证。
张小珺:追赶o1?
杨植麟:对,我们比较早在这个技术路线投入,得到一些结果,看背后的技术到底怎么做。
当时我们发现不太需要太多的process reward(过程奖励),或者value function(价值函数),甚至它们在训练过程中还有一些副作用。
我们发现,你可能直接用端到端的reward(奖励信号),就能把训练做得非常好。这在早期还不是非常明确。这个过程中,我们积累了一些强化学习的基建,还有一些算法的know-how(诀窍)。
K2的重点有几个:一是我们希望它是一个非常好的基础模型(Base Model)。如果你想有更好的Base Model,就要去看现在整个领域预训练的瓶颈在哪。
我们发现高质量数据的增长确实很缓慢,多模态数据又无法很好提升文本本身的“智商”,你可以认为高质量数据接近一个常数。这种情况下,我们希望能最大化地使用每一份数据,就是所谓的token efficiency(token效率)。
你希望在吃下一样多数据的情况下,脑子能长得更多,你能得到更多智能。
这里和之前的思路不太一样。你现在假设在训练系统做很多性能优化,让训练更快,这当然有价值。但训得更快本身,并不能提升智能上限,因为token数量还是那么多。你训得更快,只是更短时间完成训练,但模型效果不一定变好,这是训练效率或compute efficiency(计算效率)上的优化。
之前有人做过这方面,我们现在更希望提升token efficiency,把一份数据当成几份用。
我们很关注,比如Muon优化器。它很有意思,对token efficiency提升很大。像Adam优化器用了10年,大部分的模型训练都会用Adam,但它的token efficiency并不够好。
Muon优化器不是把每个元素独立考虑,而是把一个矩阵的参数整体考虑它们之间的dependency(依赖关系)。通过这种方式,获得更好的学习效率——你学同样一份数据,能学到更多智能。
我们早期的实验,如果在compute optimal(计算最优)的情况下,基本会有两倍提升。也就是,你学一份数据,相当于用Adam学两份数据。
假设你有30T的高质量token,等价于你现在有60T的高质量token。
张小珺:但它实际还是那么多数据啊。
杨植麟:它学了之后,脑子会长得更快。因为学习效率更高,优化器更好,吸收得更快。
你喂它一样多的数据,它吸收得更好,压缩率会涨得更快,loss(损失)会降得更快。
张小珺:Muon优化器是你们原创吗?
杨植麟:Muon优化器是Keller Jordan(一位计算机科学家和机器学习工程师,于2024年12月加入OpenAI)提出的一个东西,我们在他的基础上做了很多优化,使它能适配并训练非常大规模的语言模型。
我们之前有一个Moonlight的工作,让它能够第一次在一定规模的语言模型上训练。后来在进一步规模化的过程中,发现了很多新的坑,比如max logit(最大logit值,观察训练是否正常的一个指标)可能会出现爆炸的问题。
这个问题在小规模实验中很难发现,但在大规模训练时会遇到。于是我们提出了一些新的方法,比如clipping(截断)技术,让它在非常大规模的情况下,仍然能很好地训练。
这非常重要——因为token数量有限,你希望每一份token能产生更大价值。
张小珺:我读了你们的技术报告,你们尝试已有模型改写现有数据,生成新的语料,具体的改写策略是什么样的?——这个在报告里没有提。
杨植麟:我们会对数据做很多Rephrase(改写)操作。比如你有30T token,但其中高质量数据更少,可能只有几十b或者几百b级别(百亿到千亿级参数量)。你希望这些高质量数据能被很好地利用,我们对这些数据做了一些改写,让它们更好地被模型吸收,并且有更好的泛化能力。
主要思想是,如果你同一份数据学很多次,它可能泛化不一定那么好,有一些过拟合问题。我们希望通过改写,让它有一定程度的泛化。
具体改写方式有非常多种,我们找到一种在实验里效果比较好的。
张小珺:哪种?
杨植麟:这个空间也很大,有非常多的研究机会。
张小珺:你怎么看待一种观点——“改写和扩充其实没用,能够写出来知识,说明知识本身就在里面,没有新知识,除非改写的时候用到其他方法。”
杨植麟:这是一个很好的问题,确实跟改写方式有关系。理论上,还是看你有没有新的熵的输入。它对改写方式有一些要求。但我们现在也不一定用了最好的改写方式,有很多探索的空间。
回到刚讲的点,K2这个模型,一方面是希望它成为一个好的Base Model。我们很希望提升它的token efficiency,这些是我们对应的设计,包括通过更大的稀疏度去加更多的参数。
那它的token efficiency也会更高,因为你参数多了之后,虽然学一样多的数据,但你会吸收得更好。反正通过实验可以验证,确实有更好的token efficiency。
第二是我们希望它有好的Agentic能力。你通过各种强化学习,或者对工具和环境的模拟,让它能有比较好的泛化性。
对于一个Agentic模型来讲,现在最大挑战是在模型的泛化上。
因为现在的RL技术,局限性在于,不管是训练任务还是评价指标,很多时候都是单点。比如你就训SWE-bench同分布的数据,它就提升SWE-bench,是很确定的东西。但是你的指标提升上去之后,并不意味着模型的泛化会变得更好。
SWE-bench(ICLR 2024) 是一个用于评估大模型在真实软件工程任务中表现的基准测试集。
我们也在尝试去解决一部分泛化问题。不希望过拟合到某一些工具,或者过拟合到某一些环境,或者过拟合到某一些具体任务上。这些任务可能是很好的观测,但我们不希望过拟合它。
这个问题在Agent训练更严重。相比于对话模型,Agent的泛化是一个更大挑战。
张小珺:Agentic能力现在更多在Post-Train阶段训练,为什么不在Pre-Train阶段去训?
杨植麟:这个也是接下来我们想探索的东西。
张小珺:这有可能提高泛化性吗?
杨植麟:取决于你的做法,比如数据分布是不是足够广泛,有没有很好的方法评估。
现在整体的评估,是阻碍Agent模型变得更泛化的重要瓶颈。你会慢慢观察到,现在Agent能用的Benchmark(基准测试)不是非常多。你在那些Benchmark上观察到一个分数,很多时候它并不是对这个能力的反映,比较片面。这是大家要去想办法解决的问题。
有一种潜在思路,我们需要用更AI native(原生人工智能)的方式去训练AI。我们希望让模型参与到更多训练过程。比如,如果你的AI能做很好的alignment research(对齐研究),它理论上会有更好的泛化,不仅只是在优化一些单点任务。
今天Agent还不像对话有这么好的泛化性——接下来雪山上几百个台阶,有可能是这个。
张小珺:听起来K1.5是跟着OpenAI跑,K2是在抢跑。
杨植麟:我们借鉴了很多技术上的方向,但也希望有一些自己的创新。
至少在公开资料,我们是第一个使用非Adam的,或者基于矩阵正交化的方式,去用新的优化器,在这么大规模的模型上去训练。这是一个创新点。
我们在一些Agent数据的做法,至少在公开可查资料里也是比较早去做的。
很有意思的是,当你在雪山上越往上爬,你会发现空间是在变大。因为现在你完成同一个任务用到的token在变多,问题复杂度变得更复杂。
就像刚刚讲的:问题不可避免,但问题总可以被解决。