

Facebook提出新型卷积神经网络机器翻译模型,速度提升9倍
基于完全卷积架构的神经机器翻译系统在准确率和效率上均超越传统循环网络
作者:Jonas Gehring、Michael Auli、David Grangier、Denis Yarats、Yann N. Dauphin
机器之心编译
参与:吴攀、微胖、蒋思源
继谷歌在神经机器翻译领域取得突破后,Facebook AI Research(FAIR)团队提出一种全新的基于卷积神经网络(CNN)的翻译架构,在翻译准确率和计算效率方面均实现显著提升。该方法不仅在多个语言对上刷新了BLEU评分纪录,更将翻译速度提升至传统循环神经网络(RNN)的九倍。相关源代码与训练模型已通过GitHub开源,项目名为fairseq[1]。
论文地址:https://s3.amazonaws.com/fairseq/papers/convolutional-sequence-to-sequence-learning.pdf
GitHub项目地址:https://github.com/facebookresearch/fairseq
语言翻译是实现全球化信息互通的关键技术。为提升翻译质量与效率,FAIR团队研发出完全基于卷积神经网络的序列到序列学习模型。该模型在标准测试集上超越了此前基于深度LSTM的最优结果,并在GPU和CPU环境下实现近一个数量级的速度提升[1]。
为何选择卷积神经网络?
尽管循环神经网络(RNN)长期以来主导自然语言处理任务,但其按序处理单词的机制限制了并行计算能力,难以充分发挥现代GPU的硬件优势。而卷积神经网络(CNN)可同时处理整个输入序列,实现高度并行化运算,显著提升计算效率。此外,CNN采用分层结构,更易于捕捉文本中的复杂语义关系[1]。
早期尝试中,CNN在翻译任务上的表现不及RNN。FAIR团队通过优化模型设计,成功克服这一局限,使CNN在保持高准确率的同时具备卓越的计算效率,为支持全球数千种语言的翻译系统提供了可行性基础[1]。
性能突破:准确率与速度双提升
实验结果显示,该CNN模型在WMT 2014英语-法语翻译任务中比此前最佳系统高出1.5 BLEU,在英语-德语任务中提升0.5 BLEU,英语-罗马尼亚语任务中提升达1.8 BLEU。更重要的是,其推理速度达到强基准RNN系统的约九倍[1]。
由于CNN架构本身的高度并行性,未来还可结合量化、知识蒸馏等加速技术进一步优化性能,展现出巨大的应用潜力[1]。
关键技术:多跳注意与门控机制
该模型引入“多跳注意”(multi-hop attention)机制,模仿人类翻译时反复回看原句的行为。网络可在生成目标词时多次“回瞥”源句子,各次注意操作相互关联,从而更精准地捕捉语义结构。例如,首次关注动词后,后续注意力可自动聚焦于相关助动词[1]。
门控机制则用于控制神经网络中的信息流动。它能根据上下文动态决定哪些信息应被强化或概括,提升翻译连贯性与准确性。该设计结合门控线性单元(GLU),简化了梯度传播过程,有助于训练深层模型[1]。

如图所示,编码器使用CNN为每个源语言词生成向量表示;解码器在每一步通过注意机制“回瞥”源句,确定最相关的下一个目标词。绿色连线强度反映注意力权重,两层解码器结构支持多层次语义理解[1]。
研究摘要:卷积序列到序列学习
论文提出一种完全基于卷积神经网络的序列到序列学习架构。相较于循环模型,该方法在训练过程中可对所有元素并行计算,优化更为高效,且非线性变换数量固定,不受输入长度影响。通过引入门控线性单元和每层独立的注意模块,模型在WMT'14英-德和英-法翻译任务上的准确率均超过深度LSTM基准,同时在GPU与CPU上实现数量级级速度提升[1]。
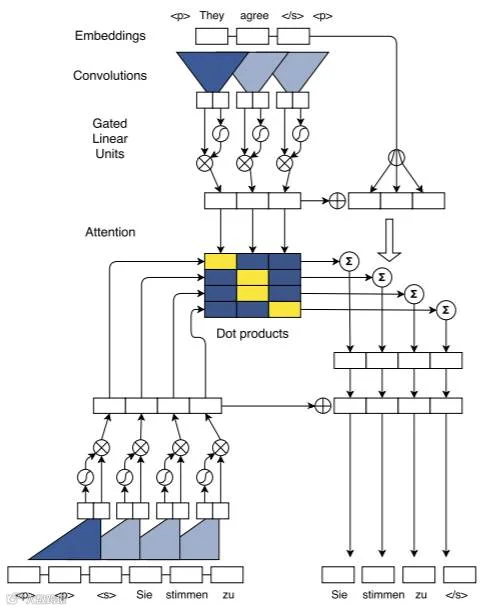
图1展示了批处理训练过程:英语源句经编码器处理后,同时计算多个德语目标词的注意力分布。注意机制由解码器上下文表征与编码器表征的点积实现,并通过门控线性单元融合条件输入以预测目标词[1]。