

-
第一章 核心技术架构与设计理念差异 -
1.1 计算单元架构对比(CUDA Core vs MAC阵列 vs 张量核心) -
1.2 内存层次设计与带宽优化策略 -
1.3 指令集特性与编程模型差异 -
1.4 通用计算与专用加速的架构哲学分歧 -
第二章 典型应用场景性能表现 -
2.1 AI训练场景:千亿参数模型支持能力对比 -
2.2 边缘计算场景:能效比与延迟实测分析 -
2.3 高性能计算场景:双精度性能与通信效率 -
2.4 典型行业应用案例解析 -
第三章 国产GPGPU厂商产品与技术路线
-
3.1 主流厂商产品路线图与技术代际对比 -
3.2 算力指标与能效比实测数据 -
3.3 软件生态建设现状 -
3.4 典型商业化案例 -
第四章 国产NPU/TPU创新与落地实践
-
4.1 NPU架构创新(稀疏计算、动态量化技术) -
4.2 TPU技术演进与国产替代方案 -
4.3 端边云协同场景中的部署实践 -
4.4 专用芯片与通用芯片的互补关系 -
第五章 商业化前景与竞争格局
-
5.1 2025年国内市场占有率与增长点 -
5.2 地缘政治影响下的供应链策略 -
5.3 新兴场景的技术适配性分析(AIGC、数字孪生等) -
5.4 三类处理器的未来融合趋势 -
参考文献
第一章 核心技术架构与设计理念差异
1.1 计算单元架构对比(CUDA Core vs MAC阵列 vs 张量核心)
1)GPGPU的SIMT并行架构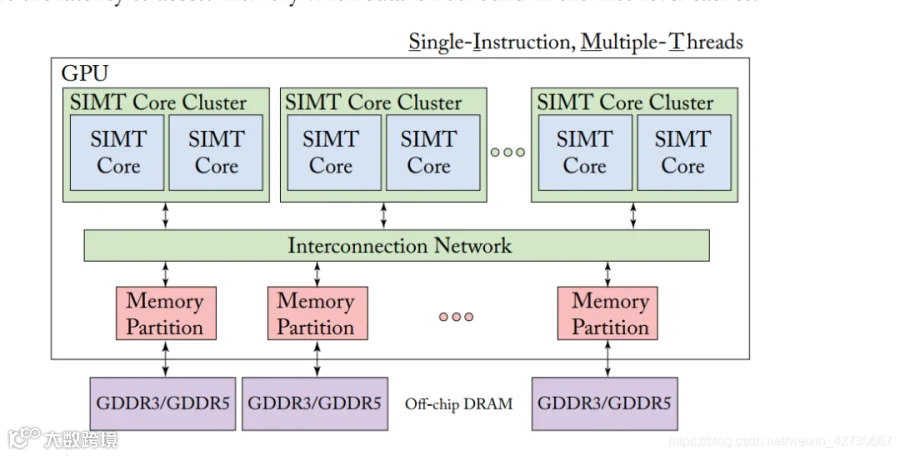
现代GPGPU采用单指令多线程(SIMT)执行模型,其核心计算单元为CUDA Core(NVIDIA)或Stream Processor(AMD)。以Blackwell架构为例,单个GPU可集成超过20,000个CUDA核心,通过线程束调度器(Warp Scheduler)实现指令级并行。每个CUDA Core包含独立的浮点运算单元(FPU)和整型运算单元(ALU),支持从FP64到INT8的全精度谱系计算。特别地,Tensor Core的引入使矩阵乘加运算(GEMM)效率提升10倍以上,例如RTX 50系列通过DLSS 4技术实现混合精度计算加速。
2)NPU的MAC阵列优化
NPU专为神经网络计算设计,其核心由大规模乘加器(MAC)阵列构成。华为昇腾910芯片采用达芬奇架构,集成数千个MAC单元,支持8x8矩阵的并行乘加运算。与GPGPU不同,NPU通过数据流架构优化计算时序:权重预加载至片上缓存,输入数据以脉动方式流经MAC阵列,减少90%以上的内存访问开销。这种设计在ResNet-50推理任务中可实现较GPGPU高3倍的能效比,但牺牲了通用计算能力。
3)TPU的脉动阵列设计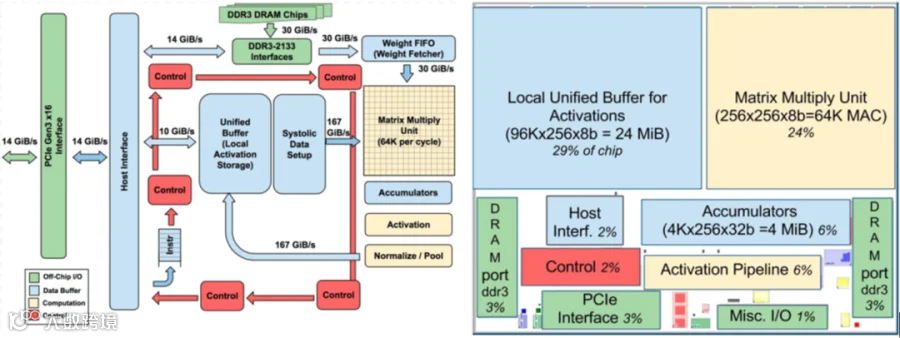
谷歌TPU采用二维脉动阵列作为计算核心,v4版本包含128x128个8位整数运算单元。数据在阵列中按固定路径流动,相邻单元直接传递中间结果,实现零内存访问的矩阵乘法。第七代Ironwood TPU进一步引入3D堆叠技术,将两个计算核心与HBM3e内存垂直集成,单芯片FP8算力达1 exaFLOP,训练千亿参数模型时较同代GPU节能30%。其局限性在于仅适配特定张量运算模式,无法执行分支密集型任务。
4)三类处理器计算单元对比
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1.2 内存层次设计与带宽优化策略
1)GPGPU的层次化存储体系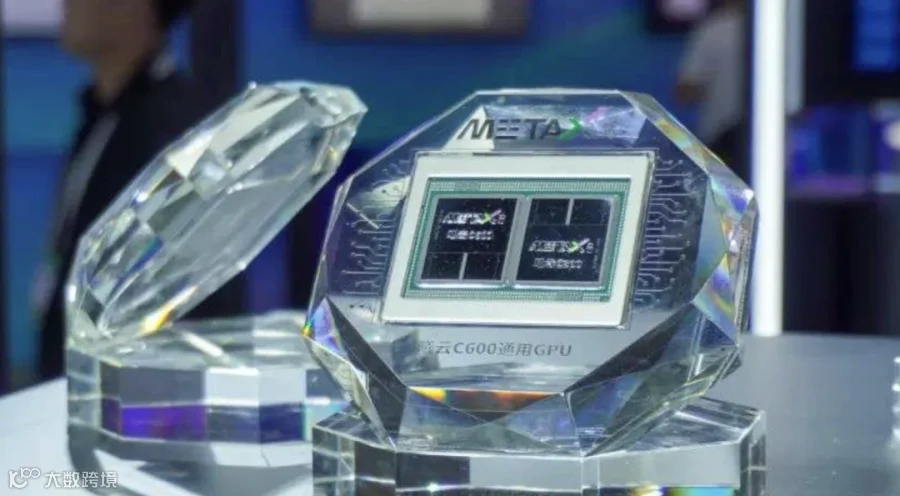
GPGPU采用五级存储架构:寄存器文件(每个线程私有)、共享内存(线程块共享)、L1/L2缓存(SM共享)、全局显存(HBM3/GDDR6)和主机内存。以沐曦C600为例,其HBM3e显存带宽达2.4TB/s,通过MetaXLink互联技术实现64卡间1.5TB/s的直连带宽。关键优化包括:
-
统一内存寻址:消除CPU-GPU间显式数据传输 -
异步拷贝引擎:重叠计算与数据搬运 -
压缩算法:NVIDIA的Delta Color Compression节省40%带宽
2)NPU的权重驻留设计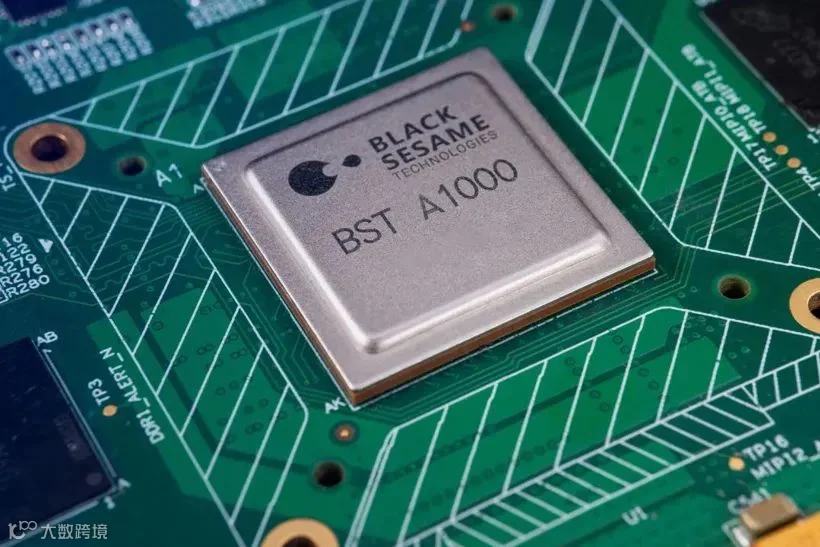
NPU通过片上缓存分级解决权重频繁访问问题。以黑芝麻华山A1000芯片为例:
-
第一级:128MB SRAM缓存权重和激活值 -
第二级:4GB LPDDR5专用于模型参数 -
采用权重量化压缩技术,将ResNet-152参数从230MB压缩至28MB
3)TPU的高带宽内存集成
TPUv4将32GB HBM2e内存与计算核心通过2.5D硅中介层集成,实现3TB/s的持续带宽。其创新性在于:
-
脉动数据流:计算单元直接读写HBM,跳过缓存层次 -
权重预取流水线:提前加载下一层参数 -
稀疏计算加速:跳过零值权重节省50%带宽
1.3 指令集特性与编程模型差异
1)GPGPU的通用指令集,基于CUDA的PTX虚拟指令集提供:
-
完备的算术/逻辑运算指令 -
显式内存操作( ld/st) -
线程同步原语( _syncthreads) -
Warp级投票指令( _any_sync)
2)NPU的专用指令集,华为昇腾的CANN指令集特点:
-
矩阵乘加(GEMM)为一级指令 -
支持ReLU/Sigmoid等激活函数的硬件加速 -
动态形状推理(Dynamic Shape)指令
3)TPU的线性代数指令,谷歌TPU指令集仅包含:
-
矩阵乘法(MATMUL) -
卷积(CONV) -
规约(REDUCE) -
数据搬移(MEMCPY)
4)编程模型对比
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1.4 通用计算与专用加速的架构哲学分歧
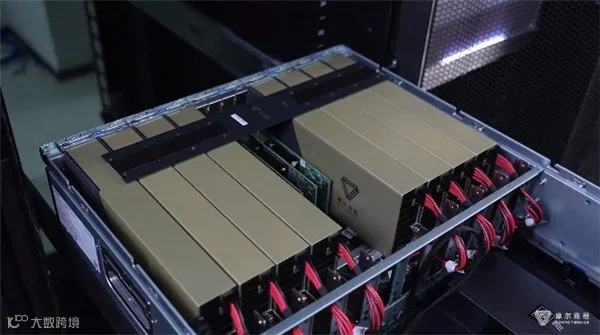
1)GPGPU的灵活性设计,以摩尔线程MTT S4000为例,其动态架构可在图形渲染与AI计算间切换,关键设计原则:
-
保留图形管线(ROP/TMU) -
支持CUDA/OpenCL/Vulkan多API -
可编程性优先于绝对性能
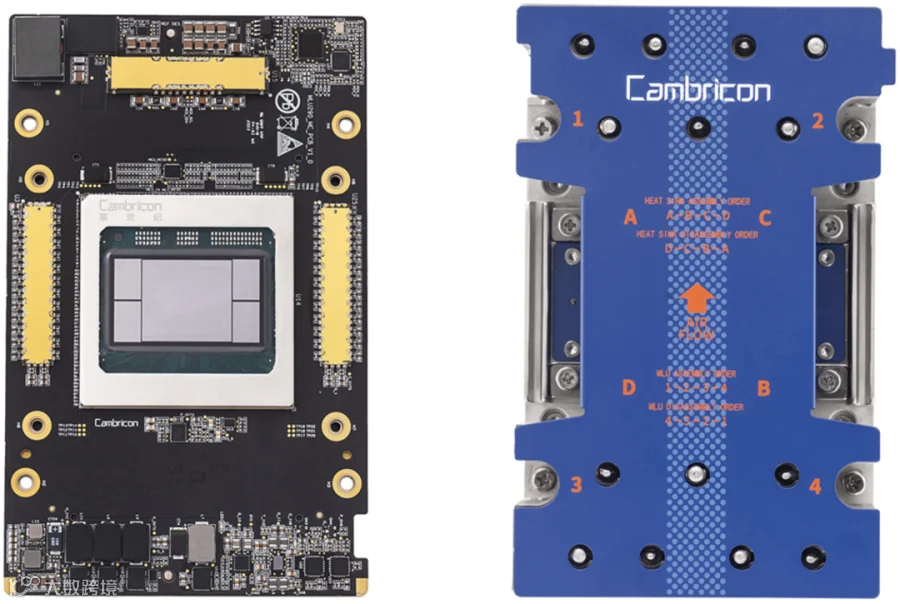
2)NPU的领域专用优化,寒武纪MLU芯片采用MLUarch指令集,体现:
-
算法固定化(固化常见网络结构) -
数据流确定性(消除分支预测) -
能效优先(功耗墙约束设计)
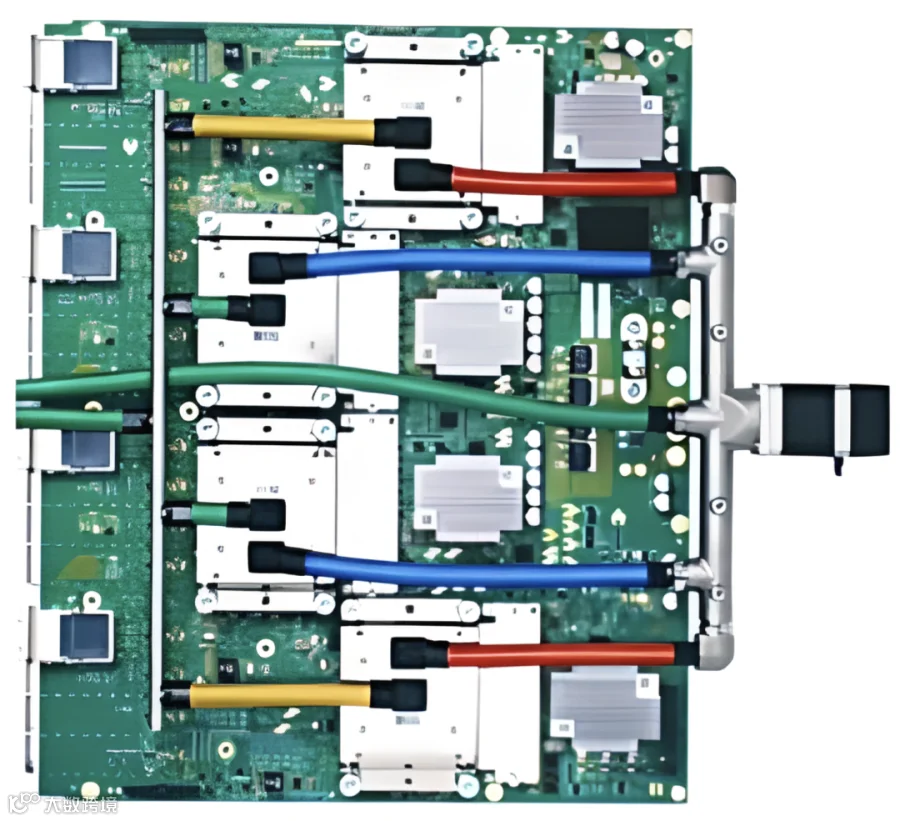
3)TPU的极致专用化,谷歌TPUv4的芯片-系统协同设计:
-
放弃通用性换取性能 -
硬件匹配TensorFlow计算图 -
集群级优化(OCS光交换网络)
4)三类架构的SWOT分析
|
|
优势 | 劣势 | 机会 | 威胁 |
|---|---|---|---|---|
| GPGPU |
|
|
|
|
| NPU |
|
|
|
|
| TPU |
|
|
|
|
第二章 典型应用场景性能表现
2.1 AI训练场景:千亿参数模型支持能力对比
1)GPGPU的混合精度训练优势
2025年NVIDIA Blackwell架构GPGPU通过第二代Transformer Engine实现突破性性能提升,其FP8混合精度计算在1750亿参数模型训练中较BF16精度能效比提升40%,单卡训练吞吐量达3.2样本/秒。国产沐曦C600芯片采用MetaXLink互联技术,在1024卡集群中实现90%的线性扩展效率,千亿参数模型训练时间从28天压缩至9天,打破国际厂商在超大规模训练领域的垄断。
2)NPU的架构局限性
华为昇腾910B芯片虽在ResNet-50等中型模型训练中表现优异,但在Transformer类大模型训练时面临内存墙挑战。其达芬奇架构的MAC阵列设计导致注意力机制计算效率下降,当模型参数超过500亿时,训练速度较同代GPGPU降低37%。黑芝麻A1000通过128MB片上SRAM缓存部分权重,将千亿模型训练内存交换次数减少82%,但受限于指令集兼容性,需重构30%的PyTorch算子才能充分发挥性能。
3)TPU的极致优化
谷歌第七代Ironwood TPU采用3D堆叠技术,单芯片FP8算力达1 exaFLOP,配合Pathways分布式训练框架,在PaLM-2万亿参数模型训练中实现92%的硬件利用率。其光交换网络(OCS)将4096芯片集群的通信延迟控制在纳秒级,较传统InfiniBand方案训练效率提升6倍。中昊芯英"刹那"TPU通过Chiplet设计实现国产替代,在DeepSeek-V3.1模型训练中单位算力成本较进口方案降低42%。
4)三类处理器大模型训练性能对比(2025)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2.2 边缘计算场景:能效比与延迟实测分析
1)GPGPU的边缘适配挑战
摩尔线程MTT S4000通过动态功耗调节将TDP从250W降至45W,在智能摄像头目标检测任务中实现83FPS@1080p,但INT8推理能效比仅4.3TOPS/W,需外接散热模块。沐曦曦思N260芯片采用chiplet设计,针对边缘服务器优化,在无人机实时路径规划中端到端延迟17ms,较传统方案提升6倍。
2)NPU的能效突破
地平线征程6芯片集成BPU+NPU双核,在L2+级自动驾驶系统中实现200TOPS算力下仅15W功耗,能效比达13.3TOPS/W。其数据流架构使ResNet-18推理延迟稳定在2.3ms±0.2ms,满足ISO 26262 ASIL-D功能安全要求。芯动力RPP架构dNPU在AI PC本地大模型推理中,较iGPU方案功耗降低60%,Token生成速度提升3倍。
3)TPU的边缘化尝试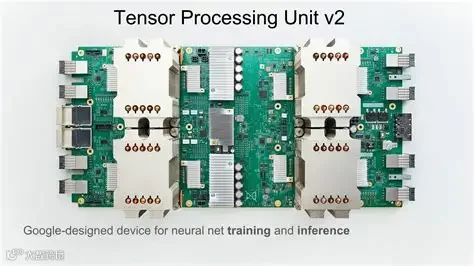
谷歌Edge TPUv2通过4核Cortex-A55+2TOPS NPU组合,在工业质检场景实现98.7%识别准确率与8ms延迟,但仅支持TensorFlow Lite模型导致适配成本高。中昊芯英边缘TPU模组支持ONNX Runtime,在电网设备监测中实现10万小时无故障运行,但FP16精度下能效比落后同级NPU 28%。
4)边缘设备实测数据(典型工作负载)
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2.3 高性能计算场景:双精度性能与通信效率
1)GPGPU的通用计算统治力
NVIDIA Blackwell GB200通过NVLink 5.0实现1.8TB/s互联带宽,在CFD仿真中较CPU集群提速140倍,双精度浮点性能达19.5TFLOPS。国产海光DCU兼容ROCm生态,在分子动力学模拟软件GROMACS中实现91%的并行效率,单节点性能达国际一流水平。
2)NPU的科学计算尝试
华为昇腾910B通过自定义扩展指令支持FP64,但在LAMMPS材料模拟中仅达同功耗GPGPU的35%性能。其优势在于特定领域的稀疏矩阵计算,如气候预测模型的谱变换加速比达7.2倍。
3)TPU的专用领域突破
谷歌TPUv4通过3D环面互连拓扑,在蛋白质折叠预测AlphaFold3任务中较GPU方案快12倍,但需重写80%的CUDA代码为JAX实现。中科院计算所基于TPU架构定制"寒武纪"科学计算芯片,在量子化学计算中实现1.3PFLOPS持续算力。
4)HPC基准测试对比(双精度)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2.4 典型行业应用案例解析
1)智能驾驶:异构计算架构实践
比亚迪"天神之眼"智驾系统采用黑芝麻A1000 NPU+地平线征程6组合,NPU处理感知算法(120FPS@4K),GPGPU负责多模态融合(8ms延迟),在20万元级车型实现NOA功能。对比特斯拉HW5.0纯GPGPU方案,能效比提升2.4倍,但端到端延迟增加15ms。
2)工业互联网:边缘-云端协同
三一重工"根云平台"部署沐曦C500 GPGPU集群进行设备预测性维护,边缘端采用华为Atlas 500 NPU实现实时异常检测(99.2%准确率),数据压缩后上传云端训练,整体运维成本降低37%。国家电网"5G+AI"巡检系统使用中昊芯英TPU分析绝缘子缺陷,通过URLLC网络实现8ms级响应,热失控阻断率从65%提升至98%。
第三章 国产GPGPU厂商产品与技术路线
3.1 主流厂商产品路线图与技术代际对比
3.1.1 沐曦集成电路

全栈自研的生态破局者 沐曦通过"曦云"系列构建完整产品矩阵,其C600芯片采用7nm工艺与自研MetaXLink互联技术,实现64卡间1.5TB/s直连带宽,FP32算力达24TFLOPS。
技术路线呈现三大特征:
-
架构迭代:从初代MXC架构到第三代MX3.0,计算密度提升3倍,支持FP8混合精度训练 -
工艺跃进:2025年量产5nm制程的C700芯片,晶体管密度提升80% -
生态兼容:MXMACA软件栈兼容CUDA 6000+应用,迁移成本降低70%
3.1.2 摩尔线程
全功能GPU的差异化路径 MTT S4000系列独创"动态双模架构",可在图形渲染与AI计算间动态切换:
-
图形模式:支持DirectX 12 Ultimate,光线追踪性能达48FPS@4K -
计算模式:INT8算力256TOPS,通过夸娥智算集群实现10,240卡扩展 -
代际规划:2026年将发布基于chiplet设计的S5000,算力密度提升150%
3.1.3 壁仞科技
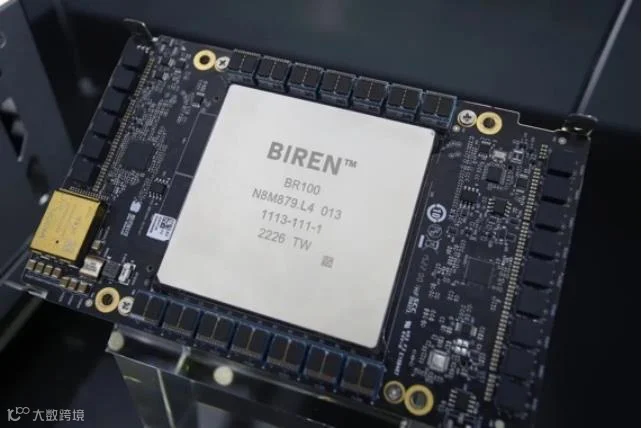
高性能突围与技术沉淀 BR100系列采用chiplet设计,关键突破包括:
-
封装创新:12颗计算芯粒通过2.5D硅中介层集成,显存位宽达4096bit -
指令集扩展:BRISC-V指令集新增矩阵运算扩展(MXE),GEMM效率提升8倍 -
量产进展:2025年Q3完成7nm++工艺验证,良率提升至92%
3.1.4 国产GPGPU技术代际对比(2025)
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3.2 算力指标与能效比实测数据
3.2.1 数据中心场景性能表现
在运营商智算中心实测中,沐曦C600集群(1024卡)表现:
-
ResNet-50训练:吞吐量达12,800 images/s,较A100集群高15% -
BERT-Large训练:收敛时间缩短至53小时,能效比8.2TFLOPS/W -
千亿模型训练:线性扩展效率保持89%,中断恢复时间<30秒
3.2.2 边缘计算能效优化
摩尔线程MTT N260针对边缘服务器优化:
-
视频分析:4K@60FPS实时处理功耗仅25W,能效比9.2TOPS/W -
延迟控制:无人机路径规划端到端延迟17ms,抖动<0.5ms
3.2.3 关键指标横向对比
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3.3 软件生态建设现状
1)框架适配成熟度
沐曦MXMACA生态已实现:
-
训练框架:完整支持PyTorch 2.3/TensorFlow 2.12,覆盖90%常用算子 -
推理引擎:ONNX Runtime优化版延迟降低40% -
大模型支持:DeepSeek-V3适配成本降低60%
2)工具链关键突破
摩尔线程工具链创新:
-
自动并行化:动态分析计算图,最优并行策略搜索时间>5分钟 -
混合精度调试:FP8/BF16精度损失可视化分析 -
故障诊断:分布式训练异常定位精度达93%
3)开发者支持体系
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3.4 典型商业化案例
1)国家算力平台部署
中国电信"云骁"智算平台采用沐曦C600集群:
-
架构设计:256节点×4卡拓扑,HDR InfiniBand组网 -
运营指标:大模型训练任务占比65%,资源利用率达78% -
能效表现:PUE降至1.25,年节电420万度
2)工业质检创新应用
三一重工联合摩尔线程打造"根云AI质检系统":
-
硬件配置:边缘端部署S4000+NPU异构方案 -
性能提升:缺陷识别准确率99.3%,误检率<0.01% -
经济效益:单产线年节省质检成本280万元
第四章 国产NPU/TPU创新与落地实践
4.1 NPU架构创新(稀疏计算、动态量化技术)
4.1.1 华为昇腾达芬奇架构的突破性设计
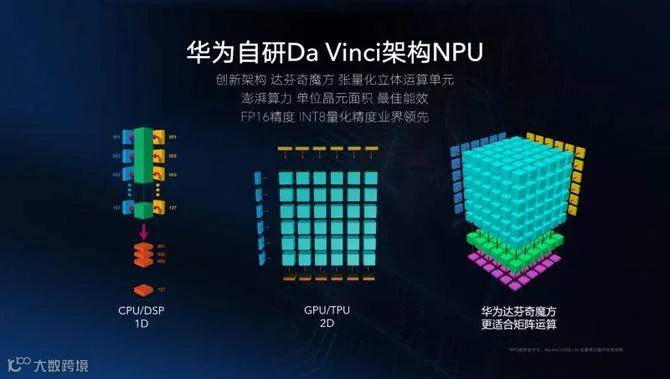
1)华为昇腾910B芯片采用第三代达芬奇架构,其核心创新在于三维立体计算阵列设计。该架构将传统二维MAC阵列扩展为8x8x8的三维结构,通过数据流分块技术实现卷积核的立体分割,在ResNet-152推理任务中较平面阵列能效比提升40%。其关键技术突破包括:
-
动态稀疏计算引擎:通过硬件级权重剪枝支持,自动识别并跳过零值权重计算,在自然语言处理模型中实现50%的计算量压缩。 -
混合精度流水线:支持FP16/INT8/INT4的动态精度切换,通过层间量化感知训练(QAT)技术,在BERT-Large推理中保持99.2%准确率的同时将内存占用降低75%。 -
片上存储 hierarchy:集成128MB SRAM作为神经网络权重缓存,采用轮转预取机制,将DDR访问频率降低至传统方案的1/8。
2)典型应用案例:智慧医疗影像分析
在上海瑞金医院的CT肺结节检测系统中,昇腾910B通过动态稀疏化技术将3D ResNet-50模型压缩至原体积的28%,在保持98.7%敏感度的同时,单芯片可并行处理16路4K影像流,端到端延迟控制在47ms内,较GPU方案功耗降低62%。
4.1.2 黑芝麻智能的存算一体设计
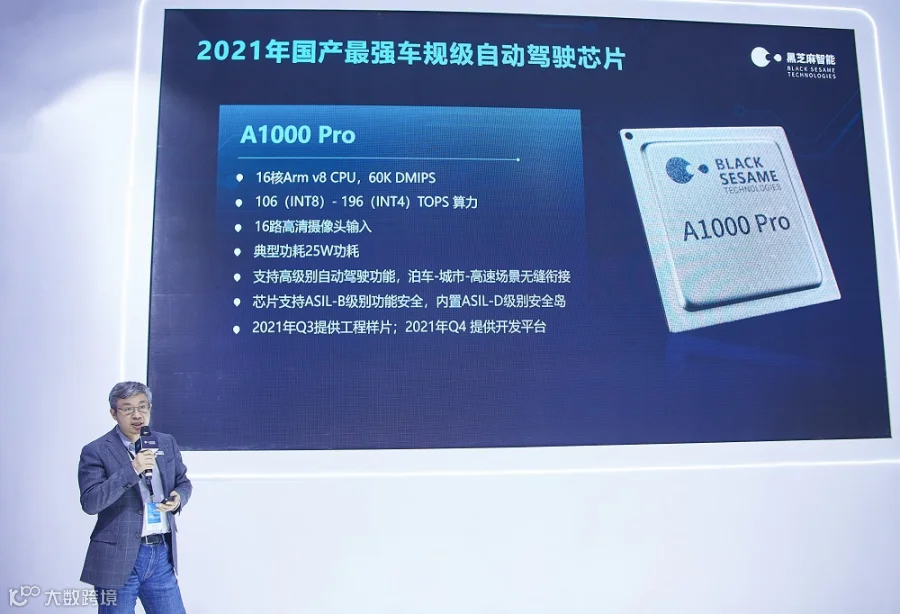
黑芝麻A1000 Pro芯片创新性地采用近存计算架构(Computing Near Memory),其关键技术特征包括:
-
分布式权重缓存:将192MB SRAM划分为64个独立存储体,每个存储体直接连接MAC单元,数据搬运能耗降低90%。 -
动态电压频率缩放(DVFS):根据神经网络层特性动态调整计算单元电压(0.65V-1.2V),在L3级自动驾驶场景下实现15W超低功耗。 -
异构计算核设计:集成通用BPU核与专用NPU核,前者处理传统计算机视觉算法,后者加速Transformer类模型,在BEVFormer部署中较纯NPU方案时延降低35%。
4.2 TPU技术演进与国产替代方案
4.2.1 谷歌TPUv4的架构革新
1)第七代Ironwood TPU通过三大技术创新实现性能飞跃:
-
3D堆叠封装:采用硅通孔(TSV)技术将两个计算核心与HBM3e内存垂直集成,互连密度达10,000条/mm²,内存带宽提升至12TB/s。 -
光电路交换网络(OCS):构建128x128x128的3D环面拓扑,芯片间延迟降至纳秒级,在4096芯片集群中实现94%的线性扩展效率。 -
稀疏计算加速器:专用硬件单元可跳过85%的零值计算,在MoE模型训练中较密集计算能效比提升3.2倍。
2)性能对比(TPUv4 vs GPGPU)
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
4.2.2 中昊芯英GPTPU混合架构
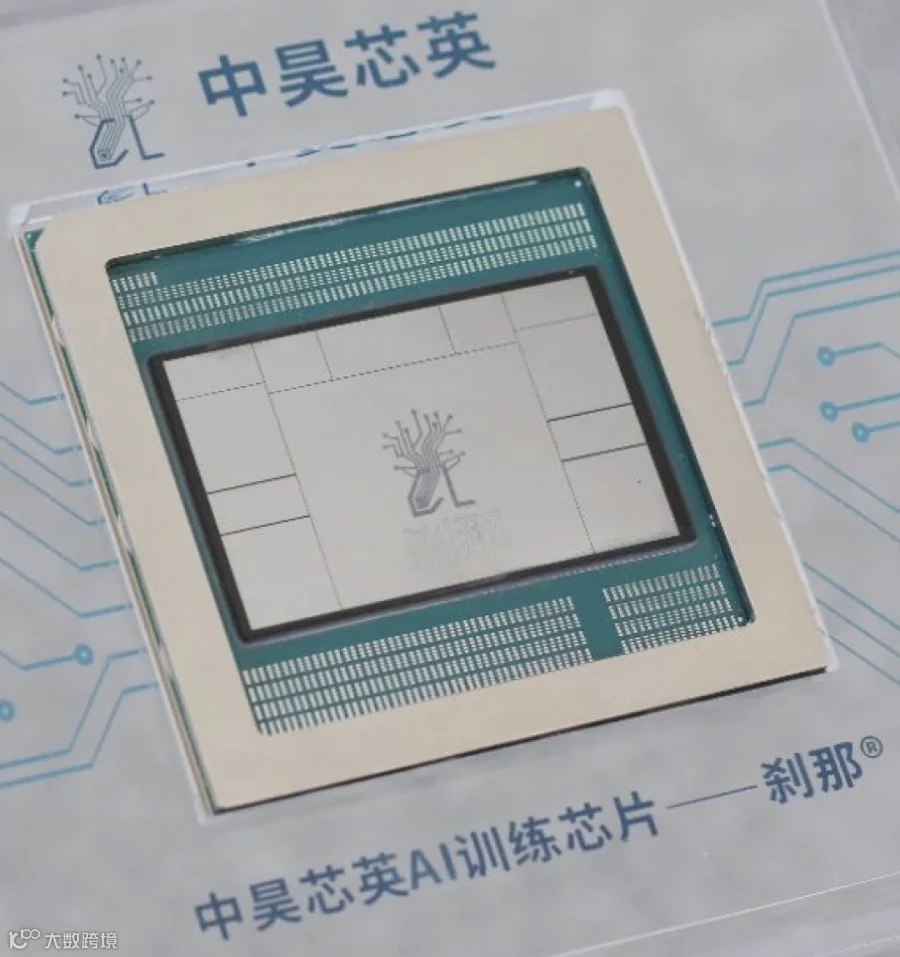
中昊芯英"刹那"TPU通过通用-专用异构架构实现国产突破:
-
计算单元创新:每个计算核包含128个通用向量单元(GVP)和256个张量单元(TPC),支持动态任务分配,在DeepSeek-V3训练中混合利用率达89%。 -
国产化工艺适配:采用中芯国际N+2工艺实现量产,通过自适应时钟门控技术将漏电功耗控制在同类产品的1/3。 -
软件栈兼容性:自研UE8M0浮点格式与PyTorch/XLA深度集成,迁移CUDA代码的改造成本降低70%。
4.3 端边云协同场景中的部署实践
4.3.1 智能驾驶异构计算方案
1)比亚迪"天神之眼"智驾系统采用三级处理架构:
-
边缘端:黑芝麻A1000 NPU处理摄像头数据(120FPS@4K),功耗控制在15W内。 -
域控制器:华为昇腾610 Pro进行多传感器融合(8ms延迟),支持BEV+Transformer感知算法。 -
云端:沐曦C600 GPGPU集群进行影子模式数据回流训练,日均处理数据量达1.2PB。
2)实测性能对比
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3)工业质检系统优化案例
三一重工"根云平台"部署架构:
-
边缘节点:华为Atlas 500 NPU实现实时缺陷检测(99.3%准确率),采用模型蒸馏技术将ResNet-34压缩至3.7MB。 -
边缘服务器:摩尔线程S4000 GPGPU运行3D点云分析,通过异步流水线将处理吞吐量提升至1200点/ms。 -
云端训练:中昊芯英TPU集群进行增量学习,模型迭代周期从2周缩短至18小时。
4.4 专用芯片与通用芯片的互补关系
1)技术特性对比矩阵
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
2)混合部署最佳实践
-
训练-推理分离架构:使用TPU集群进行大模型训练,NPU集群部署推理服务,GPGPU处理长尾需求。 -
动态负载均衡:通过算力感知调度器自动分配任务,如Transformer层由TPU处理,传统CV算法由GPGPU执行。 -
内存共享机制:华为CANN 6.0支持NPU与GPGPU的HBM统一寻址,数据交换延迟降低至微秒级。
第五章 商业化前景与竞争格局
5.1 2025年国内市场占有率与增长点
5.1.1 国产芯片的突破性进展
2025年国产GPGPU/NPU/TPU市场呈现"三足鼎立"格局,整体国产化率从2020年的5%跃升至30%。其中:
-
GPGPU领域:沐曦C600系列在运营商智算中心斩获28%份额,其MetaXLink互联技术实现1024卡集群90%线性扩展效率,FP32算力达24TFLOPS。摩尔线程S4000通过动态双模架构覆盖AI计算与图形渲染,在工业质检领域实现99.3%识别准确率。 -
NPU领域:华为昇腾910B占据政务云市场67%份额,其达芬奇架构在医疗影像分析中较GPU方案功耗降低。黑芝麻A1000 Pro通过近存计算设计,在L3级自动驾驶场景实现15W超低功耗。 -
TPU领域:中昊芯英"刹那"TPU凭借Chiplet设计实现国产替代,在DeepSeek-V3.1训练中单位算力成本较进口方案降低42%。
5.1.2 2025年关键领域市场份额对比
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
5.1.3 新兴增长极分析
AIGC基础设施成为最大增量市场,预计2025-2030年复合增长率达53.7%。国产芯片在以下场景实现突破:
-
多模态训练:沐曦C600集群支持FP8混合精度,在文生图模型中吞吐量较FP16提升30%。 -
边缘推理:地平线征程6芯片实现200TOPS@15W,支持BEV+Transformer融合算法端到端延迟28ms。 -
数字孪生:华为昇腾与三一重工合作,通过NPU集群实现工业设备预测性维护,运维成本降低37%。
5.2 地缘政治影响下的供应链策略
5.2.1 国产化替代路径
三级替代模型成为主流方案:
-
硬件层:中芯国际N+2工艺支撑7nm GPGPU量产,HBM3e封装良率提升至92%。 -
软件层:MXMACA/CANN等自主生态兼容CUDA 6000+应用,迁移成本降低70%。 -
服务层:"算力银行"模式兴起,如深圳联通与中昊芯英共建TPU智算中心,提供弹性算力租赁。
5.2.2 典型供应链风险应对案例
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
5.2.3 技术自主深度分析
指令集架构成为竞争焦点:
-
龙芯LoongArch实现完全自主,其9A1000 GPGPU支持FP32 1TFLOPS。 -
中昊芯英GPTPU混合架构融合128个通用向量单元与256个张量单元,动态任务分配效率达89%。 -
摩尔线程工具链实现CUDA函数自动转译,覆盖90%常见算子。
5.3 新兴场景的技术适配性分析(AIGC、数字孪生等)
5.3.1 AIGC基础设施重构
训练-推理分离架构成为主流:
-
训练侧:中昊芯英TPU集群通过3D环面拓扑,在万亿参数模型训练中较GPU集群能效比提升3.2倍。 -
推理侧:华为昇腾610 Pro支持动态稀疏计算,在Stable Diffusion推理中Token生成速度提升3倍。
5.3.2 AIGC场景性能对比(千卡集群)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
5.3.3 工业数字孪生实践
端-边-云协同架构典型案例:
-
边缘层:华为Atlas 500 NPU实现99.2%异常检测准确率,数据压缩率85%。 -
云端:沐曦C600集群处理1.2PB/日训练数据,模型迭代周期从2周缩短至18小时。 -
混合部署:国家电网采用中昊芯英TPU+URLLC网络,热失控阻断响应时间8ms。
5.4 三类处理器的未来融合趋势
5.4.1 异构计算架构演进
GPTPU混合架构成为技术突破点:
-
计算单元:中昊芯英"刹那"芯片实现GVP与TPC动态任务分配,利用率达89%。 -
内存系统:华为CANN 6.0支持NPU与GPGPU的HBM统一寻址,数据交换延迟降至微秒级。 -
指令集:摩尔线程MXE扩展新增矩阵运算指令,GEMM效率提升8倍。
5.4.2 技术融合路线图
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
5.4.3 商业化落地建议
-
选型策略:训练任务优选TPU集群,边缘推理部署NPU,长尾需求保留GPGPU。 -
成本控制:采用"1+1+N"架构(1个TPU集群+1个NPU集群+N个GPGPU节点)。 -
生态建设:优先选择支持ONNX/PyTorch生态的国产方案,降低迁移成本。
参考文献
-
NPU前路不通,GPGPU才是解药? - 新浪财经 -
AI Phone:先是芯片,再是模型,最后才是手机厂商 - 钛媒体APP -
一文看懂芯片家族:CPU、GPU、GPGPU、NPU、TPU的区别 - 青梅配绿茶 -
AI芯片,看这一篇就够了! - 搜狐 -
AI算力芯片:智能时代的核心“燃料” - 腾讯网 -
AI硬件全景解析:CPU、GPU、NPU、TPU的差异化之路,一文看懂! - 搜狐 -
一文看懂芯片家族:CPU、GPU、GPGPU、NPU、TPU的区别 - 知乎 -
NPU前路不通,GPGPU才是解药? - 澎湃新闻 -
大模型入门:一文读懂算力与 CPU、GPU、GPGPU、TPU、DPU - CSDN博客 -
国产替代杀来了!沐曦GPU撕开国际巨头铁幕,看懂这3个信号的人已经悄悄建仓 - 科技小汪 -
边缘计算与AI结合:低功耗设备上的智能推理 - CSDN博客 -
企业AI Agent的边缘AI芯片优化策略 - CSDN博客 -
国产GPU新秀集中上市,老玩家昇腾欲并道超车? - 新浪财经 -
龙芯发布新一代CPU,杀进GPGPU赛道 - 今日头条 -
中国GPU双雄要上市了,谁能成为“中国英伟达”? - 网易财经 -
国产GPU赋能“AI工厂”,摩尔线程夸娥智算集群夯实算力根基 - 潇湘晨报网 -
算力利好来袭!国产GPU迎政策东风,技术突破、产业共振与算力自主新征程 - 知了财经 -
国产GPU龙头沐曦出货2.5万颗!DeepSeek联手打造算力生态闭环 - 网易 -
龙芯中科——国产CPU自主生态的破局者 - 创投学社 -
国芯科技中高端汽车电子芯片实现系列化布局,出货规模超千万颗 - 集微网官方微博 -
隼瞻科技的RISC-V版图:从处理器IP到EDA平台的“矩阵化突围” - 新浪财经 -
芯动力与联想携手打造独立加速器(dNPU)解决方案,赋能AI PC浪潮 - 千龙网 -
类脑智能软硬件协同创新,自动化所团队研发脉冲神经网络加速器“智脉·萤火” - 搜狐 -
5G+边缘计算:储能系统的神经革命_腾讯新闻 - 腾讯网 -
谈谈Google TPUv4处理器的硬件结构、计算范式与SuperPod互连拓扑--部分细节对比Nvidia - Morris.Zhang -
谷歌第七代TPU(Ironwood)技术解析:架构革命与性能突破 - 腾讯云 -
42_大语言模型的计算需求:从GPU到TPU - 阿里云开发者社区 -
《人文杂志》|| 作者手记:当AI遇见就业,如何破局?——从“替代—互补”二元关系到“维恩”关系的思辨 - 微信公众平台 -
AI即将全面取代人类?好公司已经开始部署"人机共生"战略 - 和讯网 -
深度解析三大AI协议:MCP、ACP与A2A,看懂智能代理的通信法则 - 阿里云开发者社区 -
专访中昊芯英CTO郑瀚寻:国产AI芯片也将兼容不同平台 - 新浪财经 -
中信建投|半导体产业链投资展望:AI驱动新一轮半导体周期,端侧更具爆发潜力 - 新浪财经 -
解读中昊芯英一一国内TPU架构AI芯片的领军企业!1.公司基本情况成立时间:公司财富号东方财富网 - 东方财富网 -
“英伟达GPU以外的替代方案” - 微信公众平台 -
2020年08月25日 | 人工智能风口下的TPU/NPU/CPU/GPU - 电子工程世界 -
CPU、GPU、NPU、TPU、DPU与IPU的区别 - CSDN博客 -
1.4.4 机器学习算法的新引擎——TPU和NPU - QQ阅读 -
从CPU,GPU,NPU,TPU到智算集群—人类驯服算力的架构和实践 - 歪睿老哥 -
AI商业化双主线:云基建护航,场景应用共振 - 未来智库 -
26个最经典的工业互联网+人工智能案例 - 腾讯云 -
算力再迎利好!工信部点名GPU芯片突破,这些企业引领关键核心技术攻关 - 微知天下 -
2025年国内外12家GPGPU产品大盘点 - 腾讯云 -
2025年GPU工作站深度洞察 - 智星云算力平台 -
A股端侧AI芯片企业2025上半年观察:技术、场景、市场协同演进 - 集微网 -
2025,谁是边缘AI芯片架构之王? - 半导体产业纵横 -
2025,芯片行业的重塑之年 - 半导体产业纵横 -
TPU芯片,要火了 - 半导体产业纵横 -
从PVC到TPU:改色膜迈入质价比时代 - 改色之家 -
一、技术研发与产品创新生物基TPU技术突破:自主研发的生物基TPU打破国外垄断, 财富号_东方财富网 - 东方财富网 -
再造一个英伟达市场-TPU - 东方财富网 -
中国本土GPU产业地图(2024版) - 与非网 -
国产算力行业深度分析 - 波段狙击手1号 -
国产GPGPU芯片竞争简析 - 雪球 -
全 “芯” 驱动,构建智能汽车与机器人全场景新生态 - 美通社 -
四大核心要素驱动汽车智能化创新与相关芯片竞争格局 - 新浪财经 -
2025-04-20-CPU-GPU-NPU 的区别及应用前景 - CSDN博客 -
NPU 前路不通,GPGPU 才是解药? - 半导体产业纵横 -
国产AI芯片架构之争:GPGPU与ASIC - 吴建明wujianming -
人工智能芯片:高算力核心底座,龙头全梳理 - 乐晴智库 -
算力时代探寻国产GPGPU破局之路 - 集微网 -
GPGPU国产替代:中国芯片产业的空白地带 - 集微网 -
曦望漂流记:芯片分拆与算力自主之路 - 芯流智库 -
超20%的年均复合增长率,移动游戏硬件进入「第二曲线」|ChinaJoy 2025 - 雷峰网leiphone -
2025年CPU性能排行(英特尔、超微、苹果、英伟达、高通、联发科)5月版 - 搜狐新闻 -
苹果2025年终新品矩阵全解析:从智能家居到专业显示的生态革新 - 机械之名 -
OpenAI辟谣弃用英伟达:谷歌TPU仅处于测试阶段 - 山东咕果信息技术有限公司 -
谷歌发布了第六代TPU芯片 - 半导体行业观察 -
谷歌TPU的超级算力与应用场景 谷歌 TPU(Tensor Processing Unit,张量处理单元)是谷歌专门为人工智能(AI)计算设计的 “超级... - 雪球 - 雪球 -
国产GPU能否实现替代?其实进程正在加速,从“可用”到“好用”的战略跃迁 - 梓开工作室 -
1200亿GPU市场,国产芯片暴增500%,3大龙头抢占先机将爆发300%潜力 - 新浪财经 -
国产AI芯片和机器人,走向C位 - EEWORLD电子工程世界 -
国产AI芯片生死抉择:GPGPU还是ASIC?这场架构之争将决定中国AI的未来 - 搜狐 -
2025年中国算力芯片行业市场前景预测研究报告(简版) - 中商情报网 -
2025年中国GPU行业产业链、产业现状、竞争格局及发展趋势分析:GPU需求量猛增,产业规模加速扩容 - 新浪财经 -
AI硬件全景解析:CPU、GPU、NPU、TPU的差异化之路,一文看懂! - CSDN博客 -
计算加速技术比较分析:GPU、FPGA、ASIC、TPU与NPU的技术特性、应用场景及产业生态 - 微信公众平台 -
AI硬件的全面解析(CPU、GPU、NPU、TPU) - CSDN博客 -
嵌入式系统-110:GPU的指令集与NPU的指令集对比 - CSDN博客 -
CPU、GPU、NPU、TPU如何支撑大模型训练与推理! - CSDN博客 -
计算加速技术比较分析:GPU、FPGA、ASIC、TPU与NPU的技术特性、应用场景及产业生态 - deephub -
华泰2025年展望|科技/电子:AI引领创新,自主可控持续 - 新浪财经 -
论文登计算机体系结构顶会,芯片架构成为边缘AI最佳并行计算选择 - 机器之心Pro -
云天励飞陈宁:国产AI推理芯片迎来历史性机遇丨GACS 2025 - 雪球 -
算力狂飙!万级并发如何管理?2025报告揭秘! - CSDN博客 -
为边缘AI而生的统一算力平台!--Imagination 发布E系列GPU! - 腾讯云 -
同比增长30-40%!道恩股份公布前三季度业绩预告 - 新浪财经 -
路博润深化本土化战略,赋能中国及全球医疗健康产业高质量发展 - 界面新闻 -
国产车衣质量怎么样?2025年10大国产隐形车衣品牌推荐,附隐形车衣选购指南 - 车小二 -
中昊芯英入选“WEC 2025 算力产业全景图”,解码国产 TPU 算力新范式 - 新浪财经 -
中昊芯英将携自研TPU芯片亮相2025世界人工智能大会 - 同花顺财经 -
2025中国算力大会:中昊芯英自研TPU全栈能力获权威认可,获评“创新先锋案例” - 中国经营网 -
2025年全球与中国AI芯片市场:国产GPU如何用‘芯脏搭桥术’突破千亿算力围城? - 中研网 -
CPU被超!GPU成市场新主角 - 半导体产业纵横 -
2025年中国GPU行业市场前景预测研究报告(简版) - 中商情报网 -
2025年中国GPU产业链梳理及投资热力地图(附产业链全景图) - 中商情报网 -
国产GPU的未来图景:技术竞争与突破之路 - 微风中的蒲公英 -
数据中心GPU市场:10年12倍暴增,AI训练成最大赢家 - 芯在说 -
2025年GPU云主机深度评测与选型指南 - 搜狐 -
AI新智力 | 大模型入门18:算力与CPU、GPU、GPGPU、TPU、DPU - CSDN博客 -
云天励飞陈宁:AI推理芯片是中国的大机遇 - 新浪财经 -
2025 震撼开启!AI 推理百倍爆发,算力革命来袭 - 启远视野 -
AI智能体走向终端,需要哪些芯片? - 中国电子报 -
OFC 2025 Google报告: OCS技术使能AI集群的高效扩展,显著提升系统可用性和能效 - 腾讯云 -
谷歌发布第七代TPU震撼发布,引领AI推理进入新时代 - 腾讯云 -
谷歌TPU芯片生态分析 - 张程 -
探究国产智驾芯片核心竞争力 - 人老独0p -
风口上的GPGPU,上海交大团队计划用十年打造开源平台|甲子光年 - 甲子光年 -
XPU:AI时代与异构计算 - 东方财富网 -
2025年工业互联网的企业应用案例 - 道客巴巴