


网页数据采集时,你是否遇到过 403 Forbidden、频繁弹出 CAPTCHA 验证,甚至更换 IP 后依然无法正常访问的情况?
这通常与网站部署的反爬虫(Anti-Bot)和安全验证机制有关。如今,网站会综合分析 IP、HTTP 请求、浏览器环境、用户行为及身份信息,识别异常自动化流量。
那么,Cloudflare、Kasada、Persona、PerimeterX 和 CAPTCHA 分别是什么?它们又是如何识别爬虫的?本文将带你了解 2026 年主流反爬虫与人机验证机制。
一、网站是如何识别爬虫的?常见的6个检测维度
网站通常不会仅依靠 IP 地址判断访问者身份,而是通过网络、请求、设备、行为及身份等多个层面进行综合检测。常见的检测维度包括:
1. 网络层检测
检查 IP 来源、网络信誉及请求频率,例如 IP 类型、ASN 归属和历史滥用记录,判断访问来源是否存在异常。
2. 协议与请求层检测
分析请求是否符合真实浏览器的通信特征,例如 TLS 握手特征、HTTP Headers 的顺序与一致性,识别异常请求。
3. 设备与浏览器层检测
检查浏览器运行环境是否完整、各项信息是否一致,例如浏览器指纹、系统语言和时区是否匹配。
4. 行为层检测
分析用户操作是否符合正常交互习惯,例如鼠标轨迹、点击节奏、页面浏览路径及请求间隔等。
5. 挑战层检测
通过人机验证判断访问者是否为真实用户,例如 CAPTCHA 图片验证码、滑块验证及无感验证等。
6. 身份层检测
针对注册、登录、支付等敏感操作,进一步验证用户身份及风险,例如身份证件核验、人脸比对和活体检测。
为了方便理解,可以将上述六个检测维度总结如下:
| 检测层面 | 检查内容 | 具体检测示例 |
| 网络层 | IP 来源与信誉、请求频率 | IP 类型、ASN 归属、历史滥用记录 |
| 协议与请求层 | 请求是否像真实浏览器发出 | TLS 握手特征、HTTP 头顺序与一致性 |
| 设备与浏览器层 | 环境是否完整且自洽 | 浏览器指纹、语言与时区是否匹配 |
| 行为层 | 操作是否像真人 | 鼠标轨迹、点击节奏、页面浏览路径 |
| 挑战层 | 是否通过人机测试 | CAPTCHA、无感验证 |
| 身份层 | 是否为真实、唯一的个人 | 证件核验、人脸比对 |
不同网站会根据业务场景组合使用上述检测方式,并非所有网站都会部署全部检测层面。
二、2026年主流反爬虫与人机验证机制解析
1. Cloudflare
是什么:Cloudflare 是全球规模最大的 CDN 与网络安全服务商之一,大量网站的流量先经过它,再到达源站。旗下的 Bot Management 负责识别机器人,Turnstile 则是它推出的 CAPTCHA 替代方案。
检查什么:
基于全球流量数据的 IP 信誉
请求特征与 TLS 指纹
浏览器环境与 JavaScript 检测结果
行为信号与机器学习评分
你看到的表现:“正在验证您是否是真人”“Checking your browser”等等待页面。Turnstile 通常在后台完成判断,只有存疑时才展示简单的交互验证。
常见场景:各类使用 Cloudflare 代理的网站,从内容站、SaaS 到电商,登录、注册、表单提交和高频访问页面尤其常见。
2. PerimeterX / HUMAN
是什么:PerimeterX 是知名的反机器人厂商,2022 年与 HUMAN Security 合并,相关产品现在归入 HUMAN 旗下,反机器人产品常被称为 HUMAN Bot Defender。不少网站页面里仍能看到 PerimeterX 的标识,所以两个名字都有人搜索。
检查什么:
设备与浏览器指纹
鼠标、触摸等行为数据
浏览器环境一致性
与 HUMAN 自身的广告与流量欺诈情报联动
你看到的表现:典型的“Press & Hold”(按住按钮)验证。它不只看你是否完成了动作,更关注按压过程中的行为特征。
常见场景:电商、票务、广告平台、金融服务等对撞库与刷单敏感的行业。
3. Kasada
是什么:Kasada 是专注反机器人的安全厂商,主打在请求阶段就完成判断,而不是依赖弹出验证码。
检查什么:
请求是否来自真实浏览器环境
客户端是否存在自动化工具的痕迹
请求特征与客户端行为是否一致
你看到的表现:多数情况下无感,用户通常看不到验证页面。判定异常时,请求可能被直接拒绝或返回错误页,而不是弹出验证码。
常见场景:电商、票务、游戏等高价值业务,以及对大规模自动化抢购、抓取比较敏感的网站。
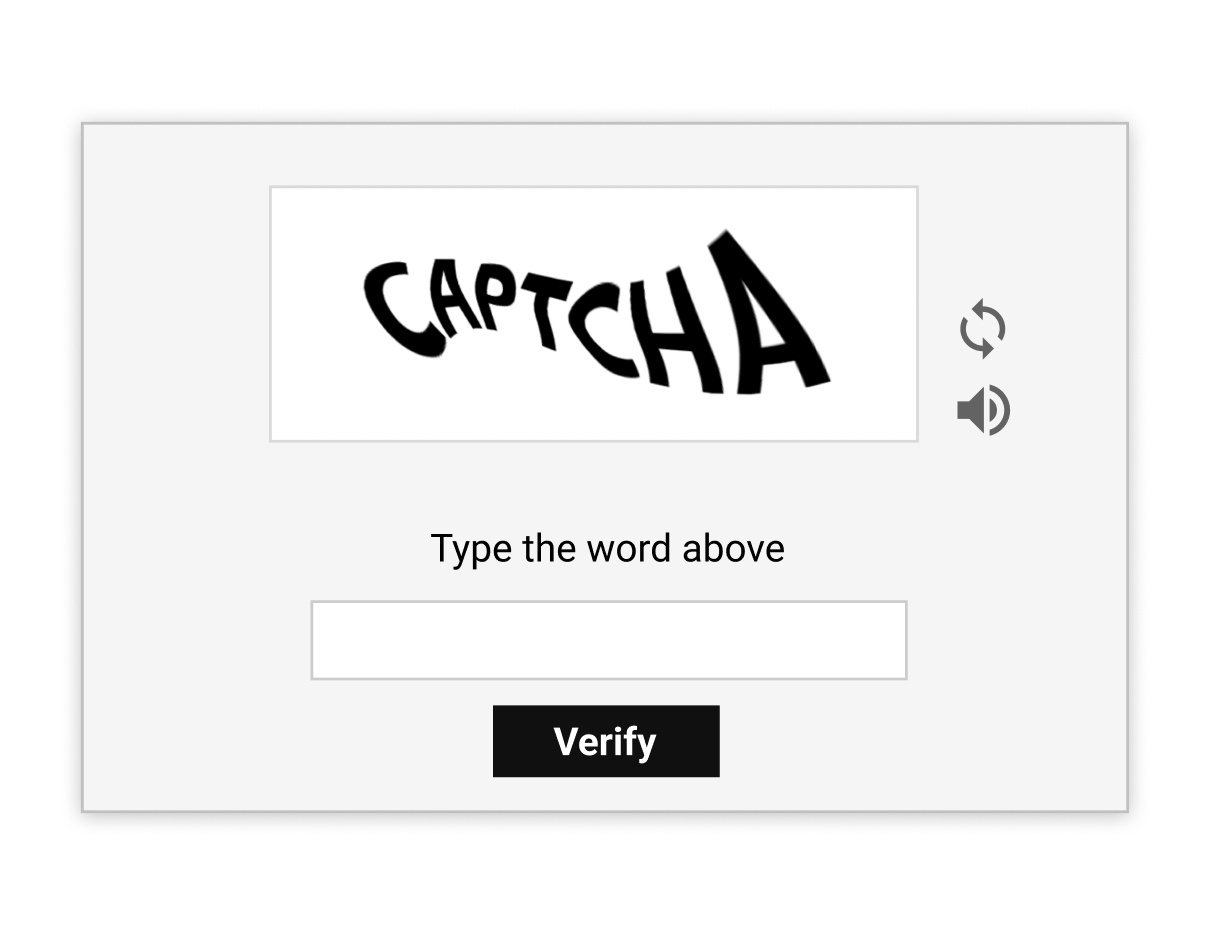
4. CAPTCHA(含 reCAPTCHA 与 Turnstile)
是什么:CAPTCHA 全称是“全自动区分计算机和人类的图灵测试”,是最早、也是最常见的人机验证形式,属于一类技术而不是某一家公司的产品。常见方案有 Google reCAPTCHA、hCaptcha 和 Cloudflare Turnstile。
检查什么:
是否能通过人机测试,如识别扭曲文字、选择图片
浏览器环境与行为评分(reCAPTCHA v3、Turnstile 等无感方案)
评分偏低时,才会升级为需要用户操作的挑战
你看到的表现:“我不是机器人”勾选框、选出所有包含红绿灯或公交车的图片,或者完全无感。现代方案越来越少依赖“解题”,转向行为与环境评分。真人有时被反复要求验证,通常是因为综合评分偏低,比如共享出口 IP、网络信誉较差或浏览器隐私设置过严。
常见场景:登录、注册、评论与表单提交、找回密码、结账页面。
5. Persona
是什么:Persona 是一家身份验证(Identity Verification)平台,属于 KYC(了解你的客户)范畴,严格来说不是反爬虫工具。Cloudflare、PerimeterX、Kasada、CAPTCHA 回答的是“这是机器人还是真人”,Persona 回答的是“这个人是不是他声称的那个人”。当行为与环境检测无法确认可信度时,部分平台会升级到身份核验。
检查什么:
证件(护照、驾照等)的真实性
自拍与证件照的人脸比对
活体检测,确认不是照片或视频冒充
你看到的表现:跳转到身份验证页面,要求上传证件并拍摄自拍。
常见场景:广告账号开户、账号被风控后的申诉、大额提现、金融与加密货币业务。
三、五种网络反爬机制有什么区别?
虽然这五种机制都与网站安全和自动化流量识别有关,但它们的定位并不完全相同。
| 机制 | 所属层面 | 主要检查什么 | 用户感知 |
| Cloudflare | 网络与综合 | IP 信誉、请求特征、浏览器环境、行为 | 等待页、偶尔验证 |
| PerimeterX / HUMAN | 行为与设备 | 指纹、操作行为、环境一致性 | Press & Hold |
| Kasada | 请求与客户端 | 自动化痕迹、请求特征 | 多数无感 |
| CAPTCHA / reCAPTCHA | 挑战 | 是否通过人机测试或行为评分 | 勾选、选图或无感 |
| Cloudflare Turnstile | 挑战(无感) | 浏览器环境与行为信号 | 多数无感 |
| Persona | 身份 | 证件、人脸、活体 | 上传证件与自拍 |
简单来说,Cloudflare、Kasada 和 HUMAN 更侧重自动化流量识别与防护;Persona 更关注用户身份和欺诈风险;CAPTCHA 则是网站常用的人机验证手段。实际部署中,这些机制也可能同时使用。
四、爬虫遇到网站反爬虫机制怎么办?
了解网站的检测机制后,在进行合法网页数据采集时,可以从请求管理、网络环境和会话管理等方面优化采集流程。
1. 合理控制请求频率
短时间内大量重复请求容易触发网站的访问限制。建议根据目标网站的访问政策,合理设置请求间隔、并发数量和任务调度机制。
同时,可以使用缓存减少重复请求,避免对同一页面进行不必要的访问。
2. 选择合适的网络环境
网络环境是网页数据采集基础设施的重要组成部分。不同地区的网站可能提供不同的内容或服务,因此需要根据实际采集需求选择合适的网络连接。
在合规授权的数据采集场景中,可以使用 IPFoxy 提供的代理IP服务,管理不同地区的网络访问需求:
动态住宅代理: 提供多地区真实住宅网络出口,适合需要公开网页的市场研究和数据采集场景。
静态住宅代理: 提供长效稳定的住宅 IP,适合需要持续稳定网络连接的业务。
需要注意,IP 地址只是网站风险评估的一个维度。更换代理 IP 并不意味着一定能够通过 Cloudflare、Kasada 等安全检测,也不能替代网站授权或身份验证。
3. 做好 Cookie 和 Session 管理
对于需要登录的网站,应按照网站提供的认证流程管理 Cookie 和 Session,避免不必要的重复登录或会话信息混用。
如果网站要求重新验证身份,应按照官方流程完成验证,不要尝试绕过安全机制。
4. 优先使用官方 API 和授权数据接口
在开展数据采集之前,建议先检查目标网站是否提供官方 API 或授权数据接口。
对于没有公开 API 的网站,也应提前了解其服务条款、robots.txt 和访问限制,合理规划采集范围及请求频率。
总结
2026 年,网站识别自动化流量的方式已经从单一的 IP 检测,逐渐发展为结合网络、浏览器、设备、行为和身份信息的多维风险评估体系。
Cloudflare、Kasada、PerimeterX、Persona 和 CAPTCHA 分别代表了不同类型的网站安全检测与验证技术。对于爬虫开发者而言,了解这些机制的工作原理,有助于更好地分析访问异常,并建立稳定、合规的数据采集流程。
与此同时,合理选择网络环境、管理访问频率和会话状态,也是提升数据采集质量的重要基础。
