

新智元报道

AI 在数学解题与代码编写领域已全面超越人类,但在面对工程师日常使用的 CAD 及仿真软件时,表现却大相径庭。
在限定 24 小时内完成曲轴设计、内存布线或涡轮叶片散热计算等任务中,表现最佳的 GPT-6 Astra 通过率仅为 37%,其余模型几乎全员挂零。


RWE-Bench:真实工程能力的试金石
10 月 27 日,Xplore AI 发布了 RWE-Bench(Real World Engineering Bench),旨在评估 AI 在真实工程场景下的能力。

该基准测试包含 20 道题目,涵盖机械(9 题)、航空航天(6 题)和电子(5 题)三大领域。所有题目均由行业资深工程师出题并提供参考答案。
评分机制摒弃了人工或 AI 主观判断,而是通过程序调用物理求解器进行逐项核查,任何一项指标不达标即判定为失败。
机械领域:曲轴设计的极限挑战
以三缸柴油机曲轴设计为例,技术简报严格规定了质量上限、应力上限、疲劳系数及曲柄销变形量等具体数值。设计需平衡配重与转速稳定性,确保在 2400 转满负荷下承受数百万次循环。

模型仅可使用 CadQuery、Gmsh、CalculiX 和 Python 等工具,独立完成建模、网格划分及有限元分析。
电子领域:FPGA 布线的毫厘之争
电子类题目要求在一块量产 FPGA 板上完成 DDR3 走线设计。板上近 300 个元件位置固定,其余线路已完成,模型需在 8 层板的剩余空隙中打通七十多条网络。

时序偏差和阻抗均有硬性限制,任意一条网络超标即导致整体失败。
航空领域:涡轮叶片的热力学计算
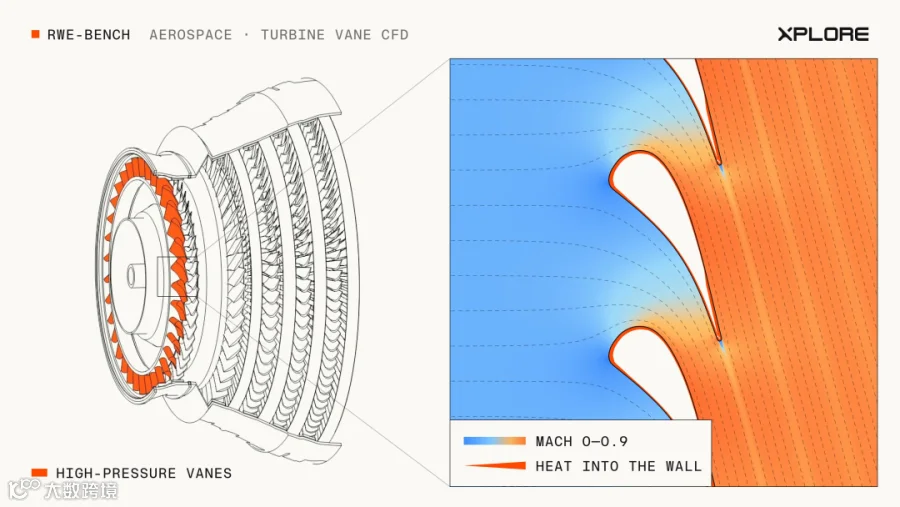
航空类题目涉及高压涡轮导向叶片的传热计算,要求从建立流道至 CFD(计算流体动力学)收敛,最终提交换热系数和总热负荷数据。
此类任务在工业界通常由具备多年经验的专业工程师承担,门槛极高。
数据背后的冷思考
1. 模型排名与性能差距
GPT-6 Astra 以 37% 的通过率位居榜首,Claude Opus 5.5 紧随其后为 29%,GPT-6.1 Sol 为 25%,Gemini 4 Argon 为 12%,Claude Fable 5.1 为 7%。其他模型在此项评测中表现不佳。

2. 答题时间暴露潜在问题
尽管每道题允许使用 24 小时,但模型平均仅在 2-3 小时内交卷,最长用时也不过 4.6 小时。相比之下,人类工程师往往需要更长时间进行反复迭代与仿真。这暗示模型可能在未充分验证的情况下便提交了错误答案。
3. 成本与性能并非正相关
GPT-6.1 Sol 单次运行成本仅 10 美元出头,而 Astra 和 Opus 5.5 约为 58 美元,分数优势并不显著。最昂贵的 Claude Fable 5.1 单次成本近 98 美元,通过率却仅为 7%。
4. 多次尝试可显著提升通过率
若允许每道题尝试 5 次,Opus 5.5 的通过率可提升至 70%,超过 Astra 的 60%。这表明通过增加计算冗余,模型解决复杂工程问题的能力仍有提升空间。
榜单争议与未来展望
样本容量与统计置信度
由于题目仅有 20 道,样本容量较小。官方数据显示,Astra 的 95% 置信区间为 30.7%-43.8%,Opus 5.5 为 21.9%-37.6%,两者存在重叠,目前尚难断定谁绝对更强。
配置一致性质疑
虽然声称所有模型均开启最高推理强度,但数据文件显示 Gemini 4 Argon 标记为“high”而非“max”。此外,最新旗舰模型 Gemini 4 Carbon 未参与本次评测。
商业利益关联
Xplore AI 主营业务包括提供 RL 训练环境及评测服务。榜单分数越低,越能凸显其专业服务的价值。尽管题目和判分方式公开,但题目难度的设定与其商业利益存在潜在关联。
未公开难题与扩展计划
有 4 道题目所有模型均未解开,具体细节未公开。Xplore 计划后续加入生物力学、土木和材料工程等领域题目,并招聘相关专业工程师。
回顾 SWE-bench 的发展历程,从最初不足 2% 的解决率到如今的高分表现,预计未来模型在 RWE-Bench 上的成绩也将快速提升。
参考资料:
编辑:马可