

·聚焦:人工智能、芯片等行业

“堆HBM”遇瓶颈:从带宽竞争转向利用率优化
过去两年,存储行业竞争核心集中于HBM,追求更高层数与更大带宽。然而,这一逻辑正触及结构性天花板。

首先是物理限制。单个GPU搭载HBM的数量和容量存在上限,堆叠层数增加导致工艺难度与成本同步上升。受限于厂区用地及良率稳定性,单纯依靠扩产缓解供需缺口的空间日益收窄。
更关键的问题在于资源利用率。数据显示,AI服务器已部署内存的有效使用率仅为50%至60%,大量容量被锁定在单台服务器内部,无法跨节点灵活调配。同时,GPU计算时间占比仅20%至30%,其余时间消耗在数据搬运与等待上。系统层面的“短缺”并非源于总容量不足,而是资源组织方式低效。
随着AI重心从训练转向推理及Agentic AI,KV Cache、长上下文读写频率显著上升。三星存储业务高管沈浩俊指出,仅靠提升内存带宽已不足以拉动系统性能,扩大容量并实现海量数据高效存取变得同等重要。单靠HBM已无法解决该问题,系统需在带宽、容量、延迟和能效之间重新分层。
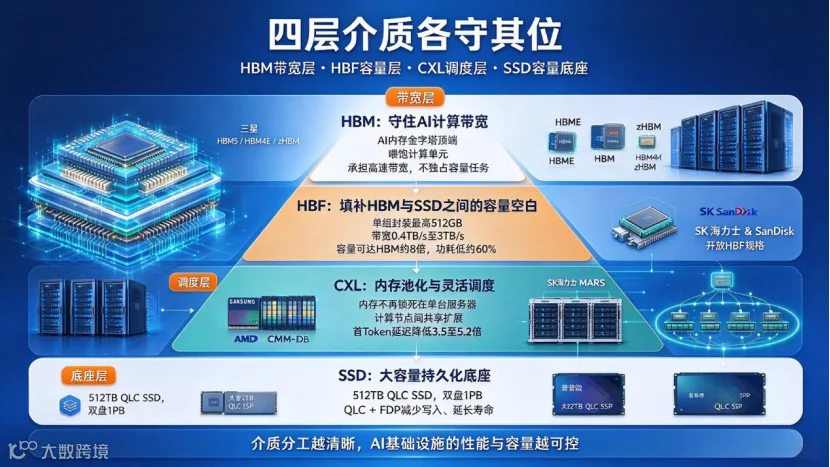
分层架构确立:四层介质各司其职
OCP 2026展示的技术路径勾勒出清晰的分层链条,不同介质在系统中扮演特定角色。
HBM坚守带宽层
HBM仍是AI内存金字塔顶端的核心。三星展出第八代HBM5及HBM4E概念模型,推进定制化HBM和zHBM技术。但其角色已从“唯一解”转变为专门的“带宽层”,主要负责喂饱计算单元,不再承担容量扩展任务。
HBF补充容量层
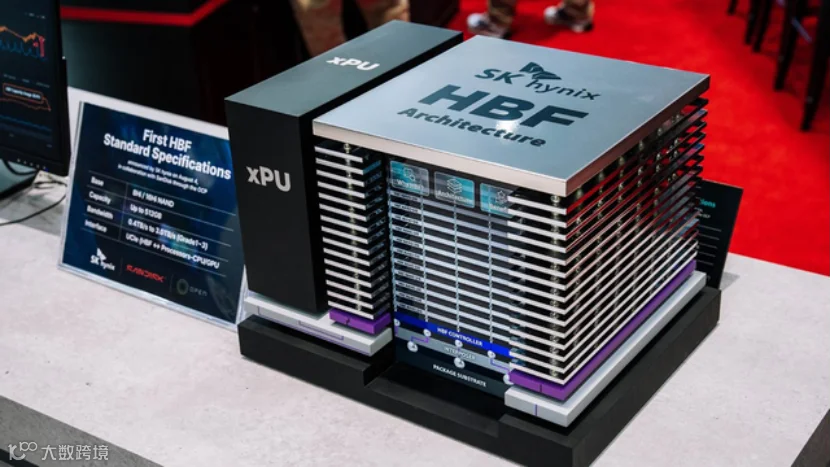
SK海力士与SanDisk发布开放式HBF技术规格,填补HBM与企业级SSD之间的层级空白。HBF单组封装容量最高512GB,带宽0.4TB/s至3TB/s,采用UCIe接口。其容量约为HBM的8倍,功耗比DRAM堆叠低约60%,旨在为温数据提供接近HBM带宽的大容量存储层。
CXL实现池化与调度
CXL技术解决了内存被锁定在单台服务器内的问题。三星与AMD联合演示了基于CXL的内存池化方案,利用CMM-D模组实现跨节点内存共享。SK海力士推出的MARS机架级架构进一步将GPU绑定内存解耦,通过CXL构建机架级共享内存池,在Agentic推理中将首Token延迟降低3.5至5.2倍。这一层的核心价值在于将内存从“独占资源”转化为“可调度资源”。
SSD夯实容量底座
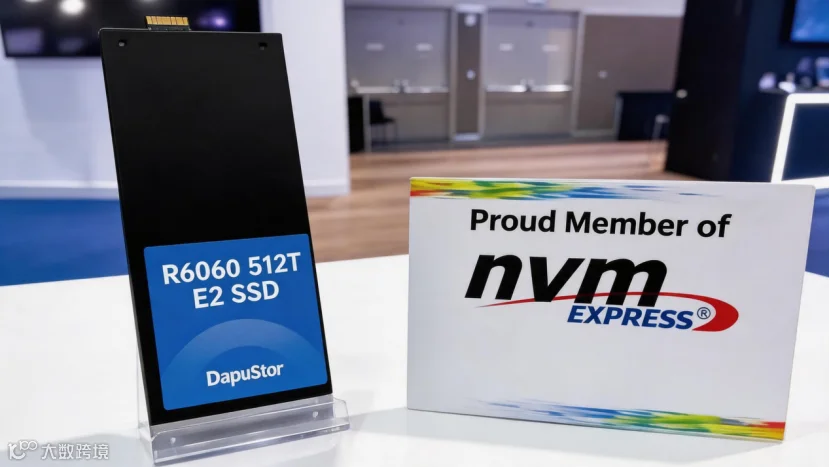
企业级SSD不再仅是冷数据仓库。大普微展示的512TB QLC SSD,双盘即可提供1PB闪存容量,面向数据湖及容量密集型AI基础设施。三星则结合QLC与FDP灵活数据放置技术,根据数据特性优化存储位置,以减少写入并延长寿命。
竞争分水岭:从“卖器件”到“交付系统”
OCP 2026显示,头部厂商已从展示单一新品转向提供多层组合的系统方案。三星与SK海力士分别提出了风格不同但方向一致的路径。
三星采取“三轴展开”策略:速度轴涵盖HBM5、定制HBM、zHBM及PIM;扩展轴依托CXL CMM-D与内存池化;持久化轴布局企业级SSD、QLC和FDP。其合作模式转变为在客户开发早期介入联合设计,利用MAX实验室验证下一代技术。
SK海力士侧重“机架级重构”。其MARS架构通过CXL池化解耦内存,结合HBF补充容量,并利用SALT-KV软件调度KV Cache。SK海力士明确“分层内存”概念:HBM负责带宽,CXL承担容量扩展与TCO优化,HBF和SSD各司其职。

两者的差异在于:三星凭借完整的器件谱系及与AMD等平台的协同验证占据优势;SK海力士则依托HBM市场约53%的份额,从系统层面重新定义内存组织方式。竞争的关键已不再是单层产品性能,而是整合介质、接口及软件调度的系统交付能力。
随着硬件分层颗粒度细化,跨层调度能力成为决定系统效率的核心变量。无论是SK海力士的SALT-KV还是三星的FDP,本质上均是通过软件干预数据放置。当硬件技术各自解决局部问题时,数据在四层介质间的流动机制由软件调度决定。
结语:OCP 2026传递的信号表明,存储厂商“只卖器件”的时代正在终结。对于采购方而言,评估AI基础设施存储能力不能仅关注HBM带宽指标。只有实现四层介质各司其职,并具备将其整合为可交付系统的能力,才能构建新的竞争壁垒。
参考资料:
全球半导体观察:《从HBM到512TB SSD,存储迎来新风向》
搜狐网:《三星公布下一代内存与存储技术,不再只卖芯片》
快科技:《你还在纠结32GB还是64GB内存:单条1TB DDR6已经公布!》