

导读
2026年10月,OpenAI发布《The Exponential Time Hypothesis is False》预印本及Lean形式化材料,声称其内部模型找到了固定宽度CNF公式精确计数的一种确定性次指数算法。真正值得科研人员关注的,不只是“AI又做出一个证明”,而是这条由低度替换、共享线性摘要、分组求和与泰勒恢复组成的技术路线,以及AI数学成果如何被公开核验。
先校准结论:发布了什么,核验到哪一步?
OpenAI于2026年10月26日公开相关材料。按官方时间线,内部模型在10月16日生成自然语言反证,10月17日完成Lean形式化。预印本的核心声明是:对每个固定的 $k\geq 2$,存在确定性算法,在多项式空间内精确计算 $k$-CNF的满足赋值数量;当 $k=3$ 时,这一结果将反驳指数时间假说(ETH)。
这里必须把三层证据分开:
01 |
已公开的 预印本、Lean文件和形式化范围说明,研究者可检查同一份材料。 |
02 |
已形式化 Lean覆盖一个次指数精确计数定理,但其时间界弱于预印本中的最强版本。 |
03 |
仍在进行核 Russell Impagliazzo、Ramamohan Paturi和Ryan Williams领导的小组负责审查与阐释。参与审查不等于为结论背书。 |
因此,截至 2026年10月30日,更严谨的表述是:OpenAI发布了可公开检查的ETH反证材料,独立学术审查仍在进行,而不是“学界已经完成最终认证”。
ETH 到底在限制什么?
从3-SAT到精确计数
3-SAT的输入是由若干子句组成的布尔公式,每个子句至多包含三个文字。例如:
$[ F=(a\lor b\lor c)\land(\neg a\lor b\lor\neg c)。 ]$
问题是:是否存在一组布尔赋值,使所有子句同时为真?若直接枚举 $n$ 个变量,需要检查 $2^n$ 种赋值。
ETH的通俗表述是:最坏情况下,3-SAT不存在 $2^{o(n)}$ 时间算法。它并不说每个实例都必须穷举,也不排除把 $2^n$ 优化为 $1.3^n$。因为
$[ 1.3n=2{(\log_2 1.3)n}\approx 2^{0.3785n}, ]$
指数仍是 $n$ 的固定正倍数,所以这还是指数时间。
相比之下,次指数时间可以写成 $2^{f(n)}$,其中
$[ \frac{f(n)}{n}\to 0。 ]$
例如 $2^{n/\sqrt{\log n}}$ 是次指数的,却仍远远慢于任何多项式。“次指数”不是“多项式”,更不是“实际问题突然变快”。
这次结果为什么强于一个SAT判定算法?
论文处理的是更难的精确计数问题:
$[\ #F=\left|{x\in{0,1}^n:F(x)=1}\right|。 ]$
只要求出 $\#F$,检查 $\#F>0$ 就能判定SAT。因此,一个次指数的精确计数算法,自然也给出了次指数的SAT判定算法。
预印本定理1.1给出的主要时间界为
$[ (n+m)^{O_k(1)}, 2^{O_k!\left(n\log\log n/\sqrt{\log n}\right)}, ]$
空间为 $(n+m)^{O_k(1)}$ 比特;当 $m\leq Dn$ 且 $D$ 固定时,指数中的 $\log\log n$ 因子还可去掉。Lean 范围说明记录的已形式化版本则是
$[ (L+1)^{O_k(1)}, 2^{O_k!\left(n(\log\log n)^2/\sqrt{\log n}\right)}, ]$
其中 $L$ 是规范输入编码的比特长度。两者都属于 $2^{o(n)}$,但不能把预印本的最强时间界与Lean已覆盖的时间界混写成同一件事。
核心机制:不是逐个找答案,而是重构求和方式
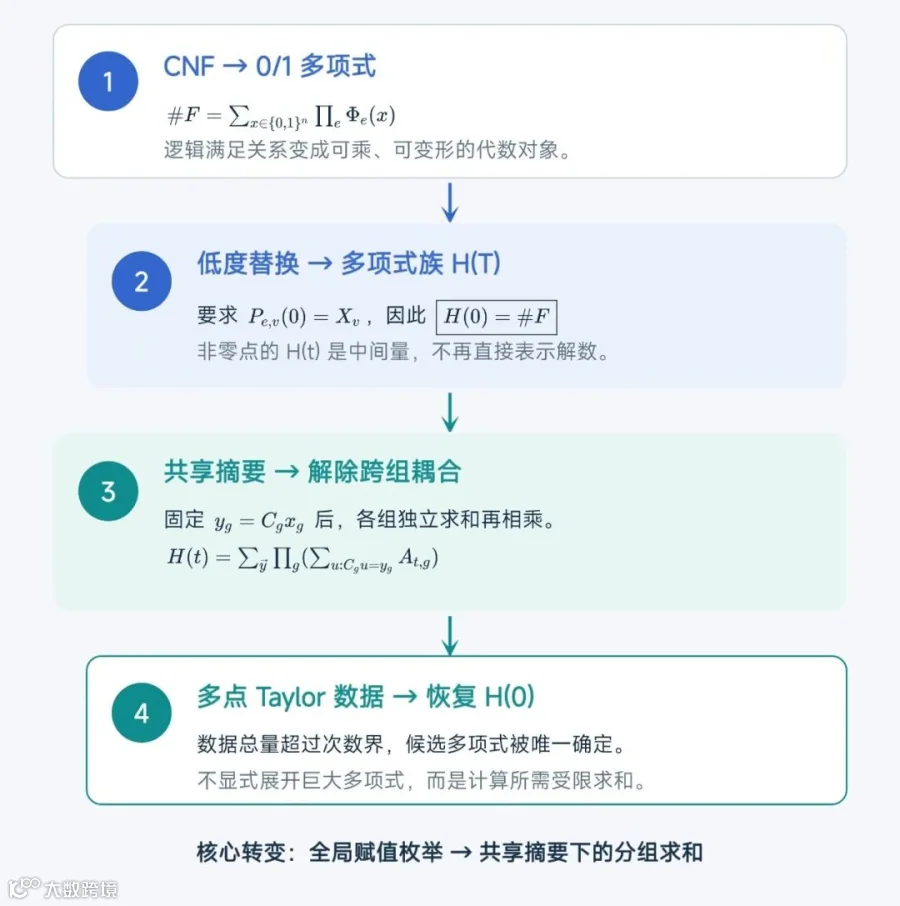
整条路线可以压缩成一句话:
把难以分解的全局布尔求和,变形为“固定少量共享摘要后,可以在小组内分别求和”的多项式族,再用插值恢复原问题的精确计数。
第一步|把子句变成0/1多项式
对正文字令 $L_{e,v}(X_v)=X_v$,对负文字令 $L_{e,v}(X_v)=1-X_v$。子句 $e$ 的满足多项式写为
$[ \Phi_e=1-\prod_{v\in I_e}(1-L_{e,v}(X_v))。 ]$
在布尔输入上,子句满足时 $\Phi_e=1$,否则为0。于是
$[\ #F=\sum_{x\in{0,1}^n}\prod_e\Phi_e(x)。 ]$
这个恒等式本身没有降低复杂度:直接计算仍需面对 $2^n$ 个赋值。它的价值是把“逻辑搜索”转化成可以变形的“代数求和”。
第二步|构造低度替换,让 T=0 保留原问题
为每个变量在子句中的每次出现,引入一个关于参数 $T$ 的线性替换形式 $\vec P_{e,v}(T)$,要求
\[
\langle\vec P_{e,v}(0),X\rangle=X_v,\qquad \deg \vec P_{e,v}\leq R。
\]
定义多项式族
\[
H(T)=\sum_{x\in\{0,1\}^n}\prod_e
\Phi_e\!\left(\langle\vec P_{e,v}(T),x\rangle\right)。
\]
因为 $T=0$ 时所有替换都恢复原变量,所以
\[
H(0)=\#F。
\]
注意:当 $t\neq0$ 时,替换后的输入不再一定是 0 或 1,$H(t)$ 也不再具有“满足赋值个数”的直接含义。它是用于恢复 $H(0)$ 的代数中间量。
第三步|用共享线性摘要压缩跨组依赖
直接分组通常失败,因为跨组子句会把不同变量组耦合在一起。论文的设计是把变量划分为小组 $S_g$,为每组配置测量矩阵 $C_g$,并定义共享摘要
$[ y_g=C_gx_g。 ]$
在选定的非零点 $t$,一个子句可以自由依赖其所属组的变量,但它对其他组的依赖必须通过对方的共享摘要 $y_g$ 表达。固定完整的摘要向量 $\vec y$ 后,各组就能独立求和:
$[ H(t)=\sum_{\vec y}\prod_{g} \left( \sum_{u:C_gu=y_g}A_{t,g}(u;\vec y) \right)。 ]$
这里,$A_{t,g}$ 是组内赋值的局部贡献。真正的变化是求和结构:
原式:枚举完整赋值,再计算全局乘积;
变形后:枚举摘要,再枚举小组内部赋值,最后把各组求和结果相乘。
这就是“共享线性摘要”降低枚举成本的关键。论文进一步通过低度替换构造,保证这种可分组结构在多个选定求值点同时成立。
第四步|不直接求 H(0),而是恢复足够多泰勒系数
设 $H$ 的次数至多约为 $3nR$。在 $Q$ 个非零点,每点取 $J=q+1$ 个泰勒系数,其中
$[ q=\left\lfloor\frac{3nR}{Q}\right\rfloor。 ]$
只要 $QJ>3nR$,这些数据就足以唯一确定 $H$:两个候选多项式之差会被所有 $((T-t)^J)$ 整除,而这个总次数已经超过候选差的可能次数,因此差只能是零多项式。最后求解有理线性系统,读出常数项 $H(0)$。
算法并不会真的展开一个巨大的多元多项式。论文引入独立的形式变量、截断到 $z^J$,再用包含—排除原理,把所需泰勒数据分解为一组受限求和;每个受限求和仍可利用共享摘要做分组计算。
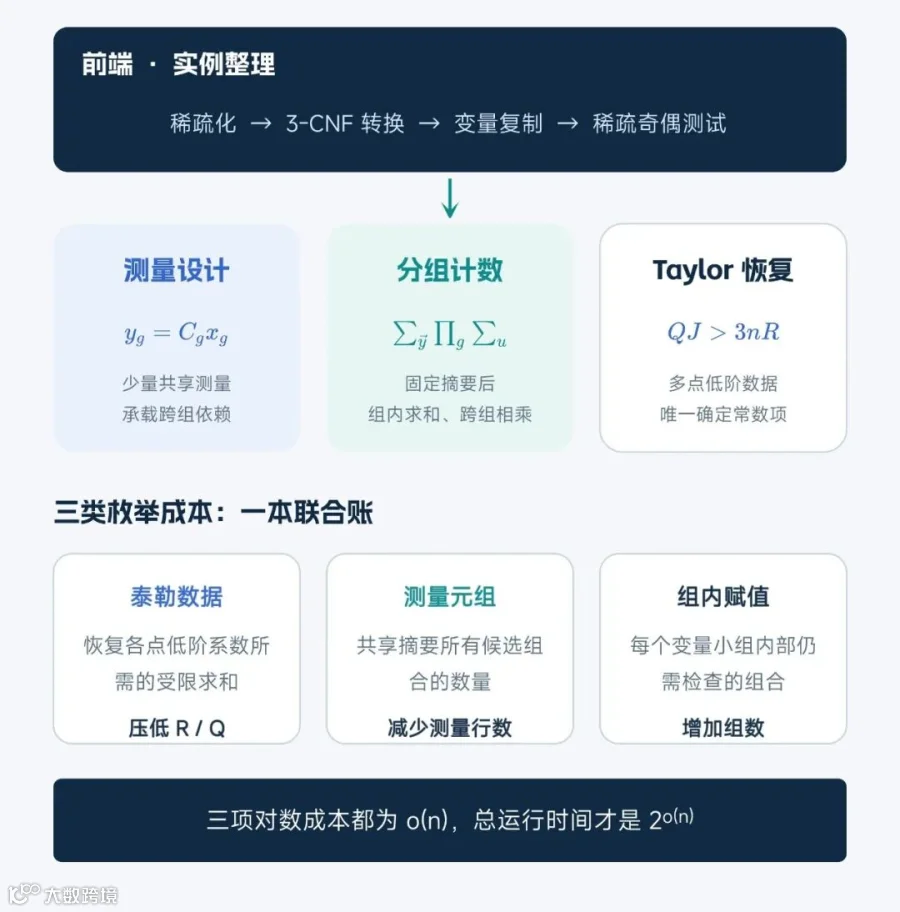
第五步|三类成本如何被同时压低?
忽略多项式因子后,主要枚举成本可理解为三部分:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
三者的对数成本都被压到 $o(n)$,总时间才成为 $2^{o(n)}$。这也是该证明与普通“分治直觉”的差别:不是单独优化某一项,而是让替换次数、摘要数量和小组规模形成一套联合参数平衡。
从受限情形到任意固定宽度 k-CNF
上述机制最直观的作用对象,是每个变量出现次数受限的3-CNF。要回到任意固定宽度 $k$-CNF,预印本还组合了多层归约:
- 计数保持的稀疏化
把原实例分解为一组出现次数受限的公式,分别计数后求和。 - OR门与变量复制
把长子句转成3-CNF,再用蕴含环强制同一变量的多个副本一致,保持满足赋值之间的一一对应。 - 稀疏奇偶测试
用少量低度多项式方程筛选满足赋值;初始测试排除“少量子句被违反”的情况,后续测试逐步消除其余非满足赋值。 - 确定性贪心选择
每次加入使当前公共零点数最小的候选测试,以计数器本身指导归约。 - 截断整数多项式编码
把奇偶条件转为整数0/1指示多项式,同时控制总输入次数,使共享摘要与泰勒恢复仍然适用。
对公众号读者而言,不必把这些技术名词逐个背下。更重要的是理解模块边界:前端归约负责把一般实例整理成可处理的稀疏代数系统,后端计数器负责利用共享摘要和插值完成精确计数。
最小实操:用8组赋值验证“多项式化—共享摘要—泰勒恢复”
下面的示例与视频中的公式一致:
$[ F=(a\lor b\lor c)\land(\neg a\lor b\lor\neg c)。 ]$
目标不是复现 67 页预印本,也不是测试次指数运行时间,而是验证三个基本事实:原公式计数为 6;可以构造满足 $H(0)=\#F$ 的多项式;可以从非零点的泰勒数据恢复 $H(0)$。
1. 先运行精确枚举
from itertools import product

clauses = (
    ((0, False), (1, False), (2, False)),  # a ∨ b ∨ c
    ((0, True),  (1, False), (2, True)),   # ¬a ∨ b ∨ ¬c
)

rows = []
for x in product((0, 1), repeat=3):
    ok = all(any((not x[v]) if neg else x[v]
                for v, neg in clause)
            for clause in clauses)
    rows.append((*x, int(ok)))

print(rows)
print("精确计数:", sum(row[-1] for row in rows))
输出为:
(0,0,0)→否,(0,0,1)→是,(0,1,0)→是,(0,1,1)→是
(1,0,0)→是,(1,0,1)→否,(1,1,0)→是,(1,1,1)→是
精确计数:6
2. 构造一个教学版 H(T)
定义共享摘要 $s=a+b+c$,并人为选择替换
$[ P_v(T)=(1-T)x_v+Ts。 ]$
显然 $P_v(0)=x_v$,所以 $H(0)=\#F$;在 $T=1$ 时,个体变量系数消失,所有替换只依赖共享摘要 $s$。此时可以按 $s=0,1,2,3$ 四类聚合,并用二项式系数记录重数,而不必逐个处理八组赋值。
import sympy as sp
T = sp.symbols("T")

def clause_poly(clause, value):
    literals = [(1-value(v)) if neg else value(v)
                for v, neg in clause]
    return sp.expand(1 - sp.prod(1-u for u in literals))

def H(t):
    total = 0
    for x in product((0,1), repeat=3):
        s = sum(x)
        P = lambda v: (1-t)*x[v] + t*s
        total += sp.prod(clause_poly(c, P) for c in clauses)
    return sp.expand(total)

h = H(T)
print(h)
print("H(0) =", h.subs(T,0))
print("H(1) =", h.subs(T,1))
实际输出:
H(T) = 76*T**6 + 72*T**5 + 9*T**4 + 26*T**3 + 15*T**2 + 6
H(0) = 6
H(1) = 204
这里的 $204$ 不是新的满足赋值数量,只是变形多项式在 $T=1$ 处的值。
完整教学脚本进一步在两个非零点各取0至3阶导数,用8组泰勒数据恢复六次多项式,并断言恢复结果与 $H(T)$ 完全一致,最终得到:
共享摘要一致性:H(1)=204
泰勒恢复 H(0) = 6
教学复现通过;这不是次指数算法性能实验。
复现边界:示例中的替换是为三变量教学专门构造的,不是论文的一般低度替换定理;代码仍包含小规模枚举,也没有实现稀疏化、测量设计、包含—排除受限求和或张量收缩。因此,它只能验证代数恒等式,不能用来证明或测量论文的渐近复杂度。
这项结果不意味着什么?
1. 不等于解决 P 与 NP
次指数时间仍然不是多项式时间。即使3-SAT存在 $2^{o(n)}$ 算法,也不能推出 $P=NP$。此外,一般多项式时间归约可能显著扩大变量规模,$2^{o(n)}$ 这种界并不会自动沿所有归约保留,所以也不能推出“所有NP 问题都有次指数算法”。
2. 不等于现实SAT求解器立即提速
渐近时间界隐藏了依赖 $k$ 的常数、构造开销和实现成本。公开材料的核心贡献是最坏情况复杂度保证,而不是一组相对于现代CDCL、局部搜索或工业SAT求解器的基准测试。理论可运行与工程可用之间,仍需要独立实现、参数优化和真实实例评测。
3. 不等于依赖ETH的旧论文“证明错了”
形如“若ETH成立,则某问题不存在某类快速算法”的条件定理,作为逻辑蕴含仍然成立。若ETH的反证最终获得认可,变化的是前提不再可用:相关困难性结论需要寻找新的假设、新的证明或重新界定,而不是自动变成算法突破。
4. Lean通过不等于独立科学认证完成
Lean的价值是把定义、引理和推导放入可机器检查的形式系统,显著降低“证明步骤是否成立”的检查成本。但研究者仍需核对:形式命题是否准确表达原始猜想、输入编码和计算模型是否恰当、是否引入额外假设、自然语言文稿是否超出已形式化范围。
这次公开材料恰好提供了一个典型案例:预印本与Lean都支持次指数结论,但二者的精细时间界不同。科研传播应该把这种差异写出来,而不是用一句“已被Lean完全验证”覆盖所有细节。
科研人员接下来最该关注什么?
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
从研究范式看,这次事件的长期价值可能不止于一个定理。它把一条新的生产链摆到台面上:
模型生成候选证明→形式化固定命题与推导→公开原始材料→外部专家审查和解释→独立实现与后果评估。
真正成熟的AI for Science,不是把“模型说证明了”当作终点,而是让每一步都能被检查、复现、修订和追责。
结语
如果这项ETH反证最终通过独立审查,它改变的将不只是3-SAT的渐近上界,更是精细复杂性理论中一批“似乎绕不过去”的研究前提。其核心方法也值得持续跟踪:用代数替换制造可分解结构,用共享摘要压缩交互,再用插值恢复精确答案。
但在今天,最专业的态度仍然是同时保留两种判断:认真对待它可能带来的理论突破,也认真区分公开声明、形式化证据与独立学术认证。这比简单说一句“AI又证明了数学难题”,更接近科研真正关心的地方。
版权声明

| 直播课程推荐 |
2027年国自然与省级基金申报全链路实战高级培训班从选题到提交——AI协同撰写、立项依据精修、科学问题"三问法"凝练、技术路线图设计、评审逻辑拆解与往期学员TOP33踩坑全解析
直播时间:11月7日-8日

AI-XGBoost机器学习与生态—地学大数据深度挖掘:从算法原理、多源数据建模到高水平论文产出全流程实战培训班
直播时间:10月31日-11月1日、7日-8日

基于Claude Code 、Codex双AI协同高水平论文撰写与质量校准:研究定位→数据分析→论文初稿→交叉审稿→投稿与返修全流程实践培训班
直播时间:10月31日-11月1日
直播时间:11月14日-15日、21日-22日
