闪迪高带宽闪存(HBF)试图在HBM与SSD之间开辟新市场,旨在以更低成本提供更大容量以应对大模型推理需求,但其商业化落地仍需跨越速度、晶圆消耗及生态适配等多重关卡。
01 推理场景将内存瓶颈从速度转向容量
随着大模型推理对长上下文和KV缓存需求的增加,系统面临“内存墙”挑战。若完全依赖HBM容纳所有数据,可能导致GPU配置过剩且算力闲置;若退守SSD,则读取速度难以满足实时性要求。
闪迪提出的高带宽闪存(HBF)意在填补这一空白:在接近HBM读取带宽的同时,提供8至16倍的容量优势。内部仿真显示,针对960GB的Qwen3-480B-A35B模型,采用HBF方案仅需1张GPU即可容纳,而纯HBM方案至少需8张GPU。需注意,此为特定模型的内部容量情景推演,尚未转化为经广泛验证的通用吞吐能力或采购节省实证。
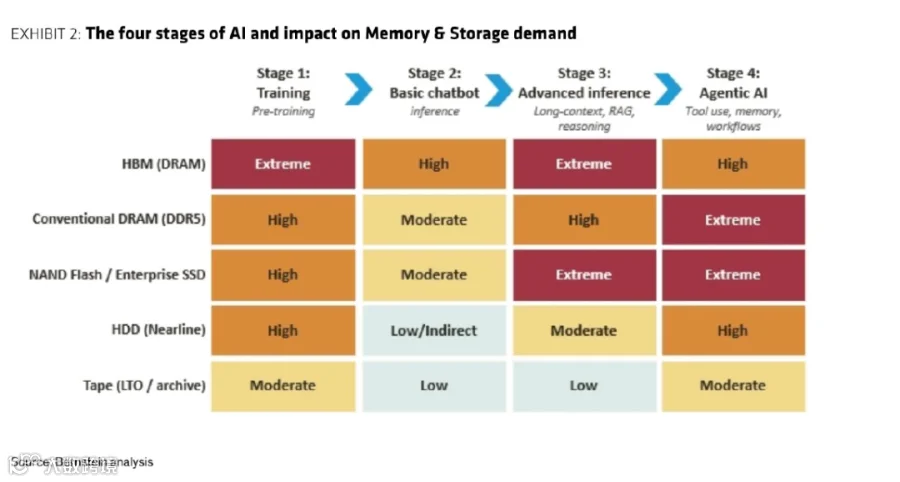
图1|Bernstein研究指出,进阶推理与智能体应用将显著增强NAND需求;该图表反映的是需求趋势判断,而非具体出货量预测。
02 HBF架构提案多样,混用模式尚处研究阶段
闪迪展示了四种HBF架构构想:独用、HBM/HBF缓存式混用、HBF增补HBM,以及预填充与解码分离。这些方案核心在于解决数据分层存储与迁移问题,但目前并非已交付的量产GPU配置。此前H3论文中提及的HBM与HBF同封装图示,仅为学术研究参照。
在实际应用中,权重和非频繁更新的旧KV缓存适合置于HBF容量层,而高频更新的热KV仍需保留在HBM中。数据迁移效率取决于模型访问规律、缓存命中率及软件预取机制,单纯增加内存层级并不必然提升推理速度。
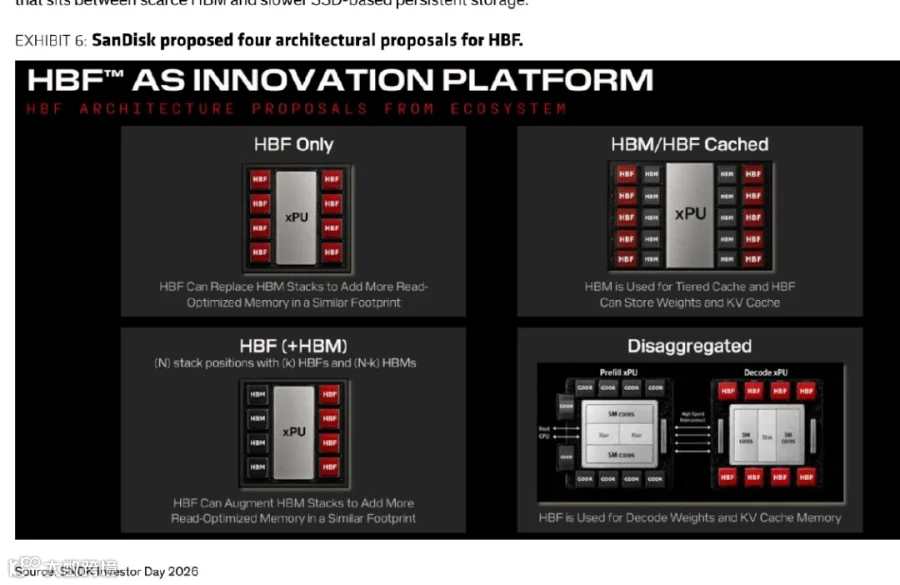
图2|闪迪展示的四种HBF架构提案中,分层混用技术尚未等同于已商业交付的GPU配置。
03 聚合带宽逼近HBM,但单次访问延迟仍有量级差异
HBF通过堆叠NAND、并行访问及宽接口汇聚读取带宽,目标区间为0.4至3TB/s,与HBM4的2至3.3TB/s参考值存在重叠。然而,HBF的单次读取延迟处于微秒级,远高于HBM约100纳秒的水平。
这意味着HBF更适用于大批量、可预取且连续读取的权重数据;而对于零散小请求或频繁改写的数据,将面临页级读取、写入速度及寿命限制的挑战。此外,HBF需占用先进封装面积,并要求处理器与软件具备识别、分配及迁移数据的能力。

图3|HBF依靠大规模并行读取来逼近HBM带宽,但在单次读取速度上仍慢一个数量级以上。
04 单位容量成本低于HBM,但晶圆消耗显著高于普通NAND
为换取高性能,HBF采用低位密度闪存单元并增加堆叠与控制逻辑。据Bernstein模型估算,生产同等容量的HBF,基准情景下需消耗约普通NAND 6.5倍的有效晶圆产能(波动区间为4.3倍至8.7倍)。此为情景估算,非量产实测数据。
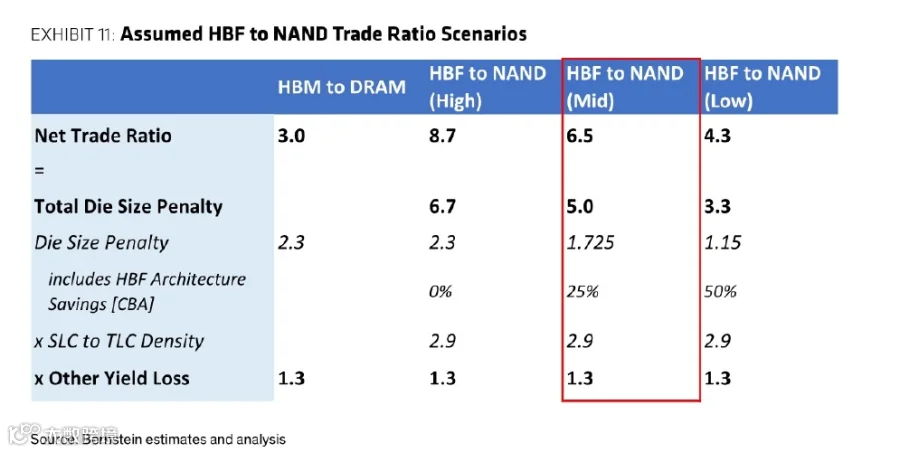
图4|受制造假设影响,HBF单位容量的晶圆消耗比在4.3倍至8.7倍之间波动。
在基准情景下,16层512GB HBF模块制造成本约271美元(每GB约0.53美元),为企业级TLC SSD的9.5倍。尽管闪迪宣称在相近模块价格下可提供更高容量,使每GB售价显著低于HBM,但其盈利空间取决于良率、封装成本及客户接受度。这里的“便宜”是相对于HBM的系统容量账,而非相对于普通SSD的制造成本账。
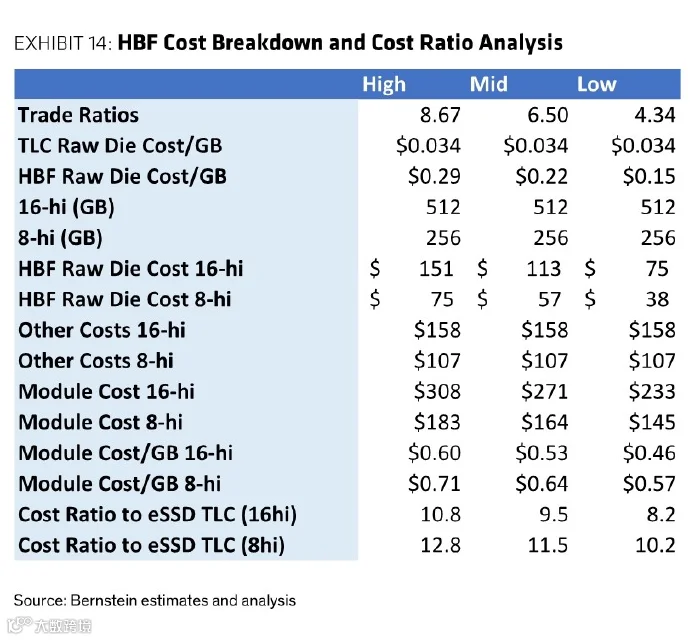
图5|Bernstein基准成本模型显示,16层512GB HBF模块成本约271美元,目前仍属估算范畴。
05 潜在影响:NAND供给收紧与HBM需求分化
若HBF大规模放量,NAND厂商需将部分晶圆产能转向该高带宽产品,导致普通存储bit产出减少。这可能因新增AI需求叠加更高的晶圆占用,从而收紧NAND供给并改善行业价格与利润。但需注意,6.5倍的消耗系数不能直接等同于全行业产能的减少幅度。

图6|HBM在DRAM中的晶圆占比已高于其bit出货占比;HBF对NAND行业的影响目前主要基于类比推演。
对HBM而言,影响具有双重性:一方面,将冷数据移至HBF可能减少单模型对HBM或GPU数量的需求;另一方面,推理成本下降可能刺激更多部署,从而推高行业HBM总需求。目前尚无实际装机数据能判定哪种力量占主导。
06 首颗芯片流片完成,规模化落地仍面临多重障碍
闪迪已披露首颗HBF存储Die流片成功,目标于2027年推出首批推理产品样品。公司正联合SK海力士推动标准化,Google、Meta、Tenstorrent等也已加入相关联盟。但这仅表明生态搭建起步,主流GPU厂商如NVIDIA尚未公开支持,且处理器接口、软件分层及封装面积等问题仍是落地阻碍。

图7|闪迪目前进展为首颗HBF存储Die流片,距离完整推理产品的正式交付尚有距离。
闪迪规划了三代HBF的容量与带宽升级路线图,但未公布具体上市日期。该路线的最终验证依赖于样品的各项性能指标、良率、成本,以及在真实推理任务下的端到端吞吐与能耗表现。仅凭“容纳更大模型”的能力,尚不足以支撑服务器配置更换的商业决策。
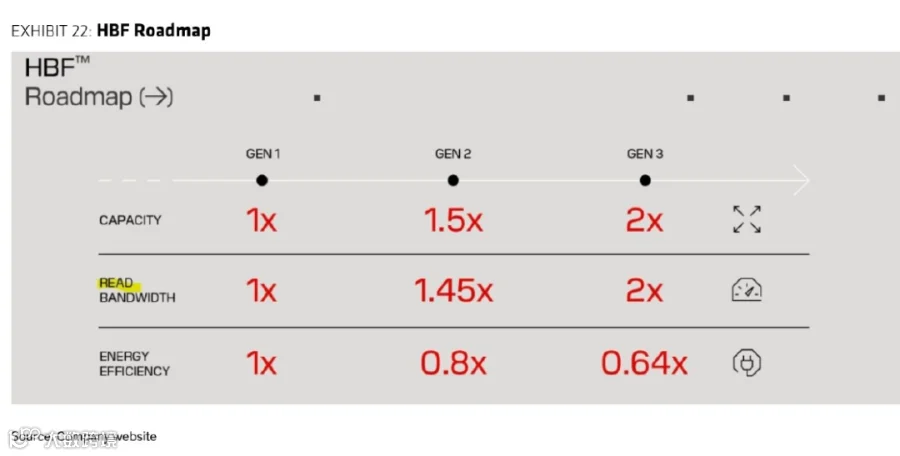
图8|闪迪路线图展示了三代容量和带宽提升的规划目标,但缺乏对应的明确上市时间表。
结语:系统成本与供应链账本需同时算通
HBF若要成功切入推理系统,必须同时解决两方面问题:在系统层面,需有效缓解HBM容纳全套模型的压力,平衡性能与成本;在供应链层面,需消化因高位密需求带来的额外晶圆消耗。闪迪已在芯片研发和标准化方面迈出关键一步,但只有当处理器硬件、软件栈及客户负载共同验证其综合效益时,这一产业推演才能转化为实际的规模化采购。