尽管深度学习领域竞争激烈,但如何在有限的时间和算力下高效产出论文仍是普遍痛点。本文分享一套实用的五步流程,并梳理从数据集筛选、模型改造到论文写作的关键资源,助力研究者快速理清思路。
第一步:定方向,甄选合适数据集
研究方向应紧密贴合专业背景及导师项目。确定方向后,需优先评估数据集的可用性、Baseline的成熟度以及现有算力支撑情况。
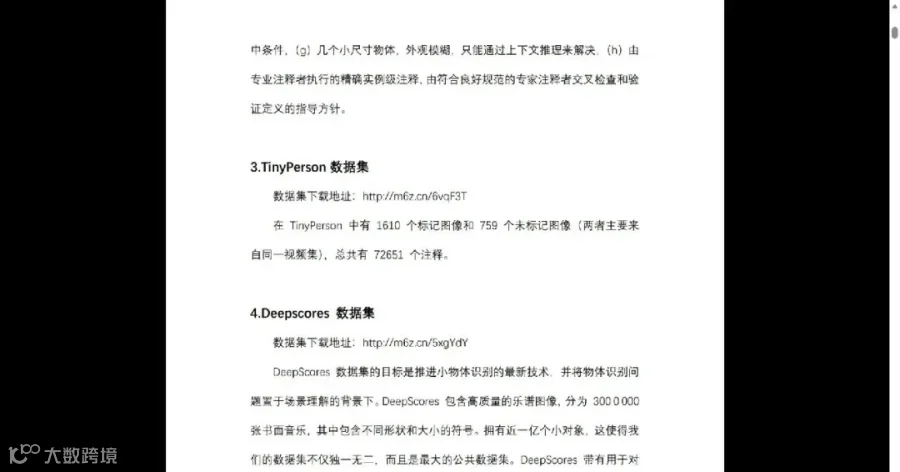
为缩短前期资料搜集时间,整理了一份包含90个深度学习数据集的资源列表,供筛选候选数据时参考。使用前请务必核实数据许可协议及适用条件。
第二步:研读论文,聚焦问题解决思路
入门阶段无需盲目追求阅读数量。建议先阅读一篇高质量综述,再精选近年代表性工作,重点剖析其研究问题、方法设计及消融实验。
核心在于厘清:现有方法存在哪些局限?作者设计背后的逻辑是什么?哪些思路可迁移至当前任务?
第三步:复现Baseline,明确改进切入点
优先选择代码公开、文档清晰且与任务匹配的方法进行复现。在彻底理解各模块作用及实验设置后,再着手改进。
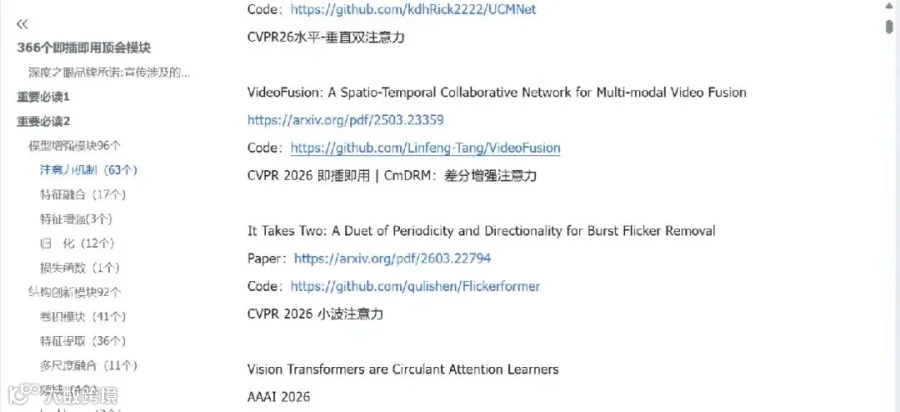
针对“不知从何改起”或“盲目堆砌模块”的常见困境,整理了一份包含366个即插即用模块的资源库,涵盖模型增强、结构创新、前沿技术融合、效率优化及特定任务场景。缺乏灵感时可按方向查找参考,但最终方案需结合具体任务通过实验验证。
第四步:诊断问题,针对性选择模块
避免盲目引入热门模块。更稳健的策略是先分析Baseline的不足,确定改造位置及预期效果,遵循“单次调整一处”原则,通过对比实验和消融实验验证有效性。
模块仅提供思路参考,论文的核心价值在于阐述其为何适合当前任务、解决了何种具体问题,以及实验数据对结论的有力支撑。
第五步:规范写作,清晰呈现研究成果
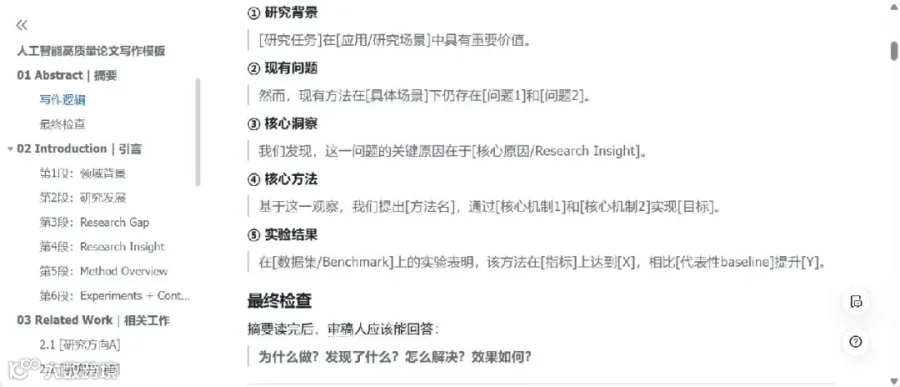
实验结果不等于高质量论文。需构建清晰的逻辑链条,包括研究问题的引出、方法设计的合理性论证以及实验对结论的支持。
为此整理了一份人工智能论文高质量写作模板,将Abstract、Introduction、Related Work、Method、Experiments等部分进行结构化拆解,协助研究者梳理框架,降低从零组织内容的难度。