


核心结论:OpenTalking 是实时对话产线,而非简单换脸脚本
OpenTalking 并非单纯的“数字人换脸”工具,而是一套完整的实时对话产线。它将前端交互、大模型(LLM)、语音识别(STT)、语音合成(TTS)、口型驱动及 WebRTC 音视频传输串联成一条支持打断、记忆及私有化部署的完整链路。
该项目拥有 3.2k Star 和 630 Fork,基于 Apache-2.0 协议开源,采用 Python + React + FastAPI 技术栈。对于从事视频管线生产的开发者而言,其架构设计极具参考价值,尤其是在“模型与编排解耦”方面的工程实践。
架构解析:链路上的六大核心环节
OpenTalking 的核心目标是构建数字人对话产品的完整链路,主要包含以下六个关键模块:
- 交互层
:基于 React 开发的 WebUI,集成形象管理、音色选择、知识库配置、记忆管理及多会话控制台。 - 会话层
:负责多会话状态管理、打断控制及长会话恢复。这是区分产品化应用与纯推理脚本的关键分水岭。 - 大脑(LLM)
:兼容任何 OpenAI 接口标准的模型,支持本地部署或云端接入。 - 听觉与表达(STT/TTS)
:集成 SenseVoice 等 STT 引擎,以及 CosyVoice、IndexTTS、Edge TTS 等合成方案,支持音色库管理与试听。 - 视觉驱动
:支持 QuickTalk、Wav2Lip、MuseTalk、FlashTalk 等口型驱动模型,具备可插拔特性。 - 传输通道
:基于 WebRTC 进行低延迟推流,并同步下发字幕事件。
该架构的最大亮点在于将“模型”与“编排”彻底分离。后端支持四种运行形态,以适应不同场景需求:
mock:使用静态帧模拟视频驱动,用于在不依赖显卡和模型权重的情况下验证 API、TTS 及 WebRTC 链路。 local:在本地运行 QuickTalk、Wav2Lip 或 MuseTalk 等模型。 direct_ws:直接通过 WebSocket 连接外部模型服务。 omnirt:将请求转发至远端推理集群(如 FlashTalk、FasterLivePortrait),适用于高算力需求场景。

架构图示:浏览器、会话 API、渲染 Worker、事件总线与四种合成后端的协作关系
mock 模式极大地降低了开发门槛,允许开发者在无需昂贵硬件或复杂环境配置的情况下,先行跑通业务流程,避免了因环境搭建困难而导致的项目夭折。
性能实测:消费级显卡的实时能力
根据官方提供的 RTX 3090 实测数据,QuickTalk 模型的表现如下:
-
输入:模板视频 + 音频 -
输出规格:720×900 分辨率,25fps -
显存占用:约 3.8 GiB -
处理吞吐:约 35 fps
35 fps 的吞吐能力高于 25 fps 的输出需求,这意味着系统具备实时处理能力,并能预留余量应对网络抖动。3.8 GiB的低显存占用使得单张 12GB 显存的显卡可同时支撑两至三路并发。这体现了实时数字人与离线渲染的本质差异:实时场景需以分辨率换取低延迟。
项目提供了从 Mock 测试到全本地私有化部署(SenseVoice + CosyVoice + QuickTalk),再到远端高质量集群(OmniRT)的五档部署路线,满足不同预算和技术能力用户的需求。

WebUI 控制台界面:集成形象、音色、会话与知识库配置
功能扩展:从实时对话到视频创作
除了实时对话,OpenTalking 近期更新中强化了视频创作与克隆功能。复用 FasterLivePortrait 运行时,支持语音/文字驱动生成视频,以及基于摄像头或上传视频的克隆功能。
新增的功能模块包括视频创作参数面板、克隆页面、自定义素材上传、网页录制导出及资产库工作区。这表明该项目的野心在于通吃直播与录播场景:实时对话适用于客服、导览和带货,而视频创作则服务于内容生产。
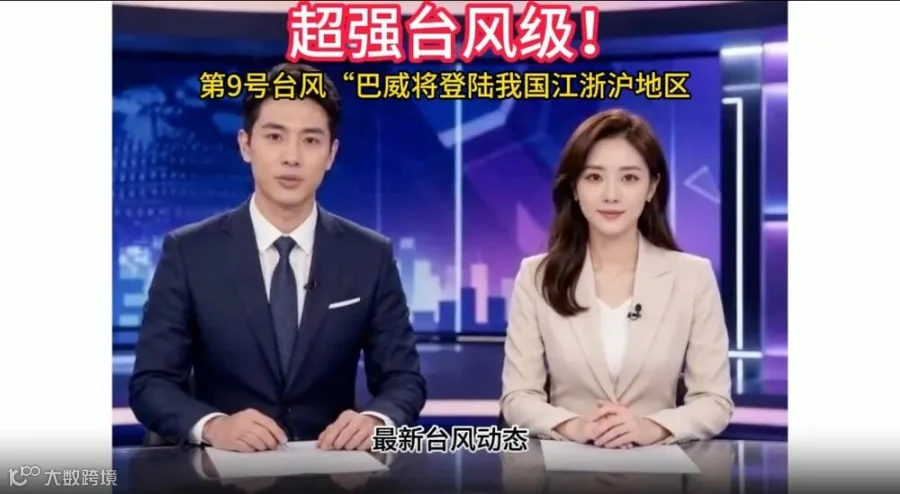
应用场景示例:双人新闻主播同框交替播报

应用场景示例:博物馆讲解,结合数字人、展品信息与知识库检索
三大核心优势与注意事项
1. 深度集成的知识库与记忆系统
不仅仅是简单的 Prompt 嵌入,项目集成了 LightRAG 进行检索,支持会话级知识选择。角色记忆提供 BM25、mem0 和 SQLite 三种后端 provider,并推出“Persona Package”功能,可将角色设定、知识材料和提示词打包复用,甚至支持导入微信聊天记录以生成特定人格。
2. 极高的工程规范
代码库集成了 ruff、mypy 和 pytest 的 pre-commit 钩子,提供 Docker Compose 部署方案、详细的模型适配器文档及 Benchmark 输入目录。仓库中大量的文档截图和演示素材表明,作者将文档视为产品的重要组成部分。
3. 务实的发展路线图(Roadmap)
当前待办事项聚焦于核心难点:提升实时对话的自然度(打断、低延迟、音画同步)、优化消费级显卡的多模型路径(预热、缓存、低显存适配)、完善 Windows/WSL2 一键部署、增强私有化部署的监控调度能力,以及拓展更多云端语音和多模态 Provider。
其中,“Windows 一键部署”对国内广大使用 Windows GPU 机器的用户尤为重要。
适用性评估:它不适合谁?
若您的需求是制作高品质交付级短视频,OpenTalking 可能并非最佳选择:
-
缺乏素材处理能力:无自动素材下载、画面床(B-roll)编排功能。 -
缺乏交付标准:无分辨率、时长、音轨的自动化断言,无命名规范及分发流程。 -
画质取向不同:追求“实时够用”,而非离线渲染级别的精细打磨。
反之,若您需要构建“打开网页即可与数字人对话”的应用,自行开发会话状态管理、打断机制、WebRTC 传输及字幕同步等底层逻辑通常需要数月时间,OpenTalking 为此提供了成熟的解决方案。
总结
OpenTalking 解决的是实时交互式数字人的底层架构问题,其“模型可插拔”和“编排与模型解耦”的设计理念具有很高的借鉴价值。对于追求全自动口播视频流水线的开发者而言,虽然两者目标不同,但其工程架构思路值得深入研究与复用。
项目地址:https://github.com/datascale-ai/opentalking
许可证:Apache-2.0