

导读Softmax 已经减去最大值,损失也接近零,训练梯度仍可能因舍入误差而失真。Google DeepMind 公开的修复研究,用高置信分类和近一致蒸馏展示了两类问题:该有的小梯度消失,本应为零的梯度却留下来。沿着计算、优化器和实验结果,看看问题如何影响训练,以及修复在什么条件下值得采用。
本文 3223 字,阅读约 8 分钟
减去最大值,为什么还不够?
第一个问题:该有的小梯度,被提前算成了零
第二个问题:本该为零的梯度,反而留了下来
影响多大:能改变训练结果,但有明确触发条件
怎么解决:保留小量,也要修复求导路径
对自己的项目,先检查什么?
减去最大值,为什么还不够?
Softmax 是深度学习里的基础函数:模型先为各个候选答案打分,它把这些原始分数,也就是 logits,转换成总和为 1 的概率。分类模型用它表示各类别的概率,大语言模型的输出端用它表示下一个词元的概率;注意力模块也会用它计算权重。
训练时,交叉熵损失衡量预测与目标之间的差距。它对 logits 的梯度,会继续通过反向传播影响模型参数的更新。下文说的“类别梯度”,都指损失对相应 logit 的梯度。
问题在于,概率只差一点,梯度的计算结果却可能从一个小数直接变成零。对训练来说,这个差别仍然重要。
2026 年 10 月 22 日,Google DeepMind 的 Jonathan T. Barron 等人公开预印本《A Fix for Softmax and Cross-Entropy》,分析了常见实现中的两类数值问题,并给出保留数学定义的修复。
这项工作的焦点,是有限精度的计算顺序如何改变训练梯度。计算机能保存的有效数字有限,数学上等价的两个表达式,执行起来可能产生不同结果。用了多年的“减最大值”写法防住了指数溢出,却没有覆盖这里的全部误差。
其中,高置信预测时的 Softmax Collapse 已在 2025 年的 ICLR 论文《Grokking at the Edge of Numerical Stability》中被明确研究,作者还提出了缓解方法。此次研究的增量,是在保留 Softmax 与交叉熵数学定义的前提下,直接调整计算路径,并用实验连接两类数值误差与训练行为。
第一个问题:该有的小梯度,被提前算成了零
假设模型给三个类别打分 [9, -9, -9],第一个类别是正确答案。Softmax 会对分数取指数,再除以所有指数项之和。
直接取指数可能遇到过大的数。常见实现先减去最大值,把分数变成 [0, -18, -18];这在数学上不改变概率,也能避免指数上溢。
但接下来,分母变成了 1 加两个约为 的小数。fp32 是一种 32 位浮点格式,它能单独表示这些小数,却无法在 1 附近分辨这么细的变化。这次求和会被舍入成恰好等于 1。
于是,正确类别的概率被算成 1,对应的交叉熵损失变成 0。问题继续传到反向传播:正确类别的梯度等于“预测概率减 1”,也被算成了 0;另外两个类别的梯度却仍是小的正数。
论文用 JAX(支持自动求导的高性能 Python 数值计算库)及其生态中的 Optax 训练工具库,展示了这组 fp32 输入的计算结果。JAX 能从损失计算过程自动求出梯度,作者的修复参考代码也用它编写:
这里损失的数值已经很小,但梯度的结构变了。数学上,所有 logits 同时增加相同的数,概率和损失都应保持不变,对应的各类别梯度之和应当为零。现在,负的那一项消失了,正的两项还在。
这就是 Softmax Collapse:模型对正确类别足够自信时,该类别梯度提前归零,其他类别梯度仍非零。提高计算精度可以把这个临界位置推远,但 fp64 也有自己的精度极限。
第二个问题:本该为零的梯度,反而留了下来
知识蒸馏让学生学习教师给出的整组概率,而不只是学习一个正确标签。例如,目标可以是猫 0.7、狗 0.2、鸟 0.1。
教师概率作为固定目标时,这种软目标交叉熵对学生 logits 的梯度等于“学生概率减教师概率”。当师生输出完全一致时,梯度理应为零,学生不应再被这个目标推着移动。
实际计算却可能留下残余梯度。师生很接近时,分别计算概率再相减,微小差异容易被舍入误差淹没;即使 logits 一致,教师前向计算的 Softmax 与学生反向计算所用的 log-softmax 路径,也可能因运算顺序不同而无法完全抵消。log-softmax 计算的是各类别概率的对数。
论文把它称为 Softmax Cancellation,也就是相消造成的精度问题。它与前一种问题的方向不同:前一种丢掉了应有的梯度,这一种则可能留下本不该有的更新信号。
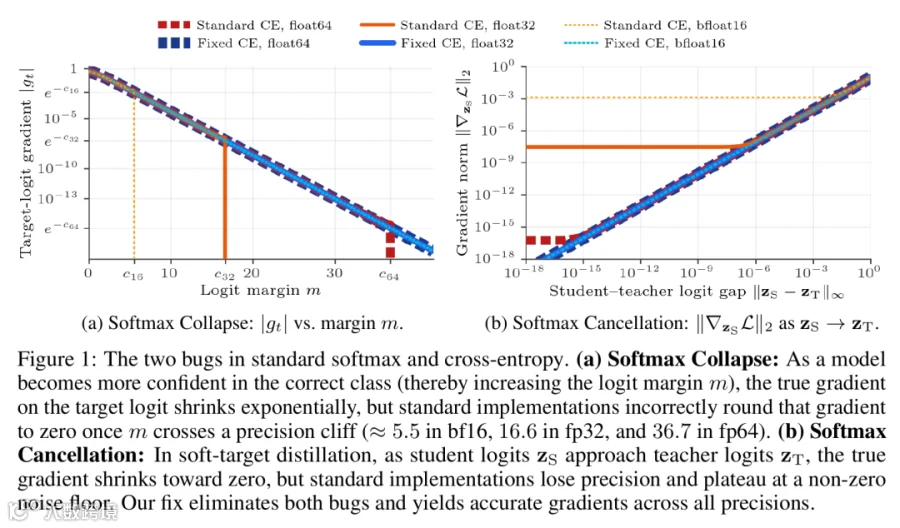 左图显示高置信时目标梯度突然归零;右图显示师生输出接近时,标准实现的梯度停在非零误差水平 | 来源:A Fix for Softmax and Cross-Entropy,v1,Figure 1
影响多大:能改变训练结果,但有明确触发条件
误差可以在一次损失计算中出现,不必等很多步训练后才积累出来。前面的 fp32 算例中,一次“1 加小量”的舍入就能破坏梯度。概率接近 1、损失接近零,仍可能看起来像训练顺利。蒸馏中,师生越接近,也越需要留意残余梯度。
错误梯度进入优化器后,才产生下一层影响。Adam 根据历史梯度及其平方的移动平均调整更新幅度;小梯度不一定带来同比例的小更新,归一化分母及稳定参数 都会影响结果。因此,要分别看清楚:梯度在哪里算错,以及优化器怎样把它传到参数。
论文研究的 Grokking,是模型先记住训练集、经过较长训练才在测试集上形成泛化的现象。在论文分析的实验条件下,模型对正确答案的置信度持续增长,目标类别梯度跨过精度临界点后突然消失。当批内样本都进入这一区域,参数梯度接近消失,Adam 对参数梯度平方的历史估计也随之衰减。
权重衰减会逐步缩小模型权重,以约束其增长。在论文的解释中,权重衰减或残余更新让部分样本退回临界点以内,目标类别梯度恢复。此时归一化分母已经很小,恢复的梯度就可能造成一次大更新,形成 Slingshot(弹弓)损失尖峰;这样的过程可能反复发生。
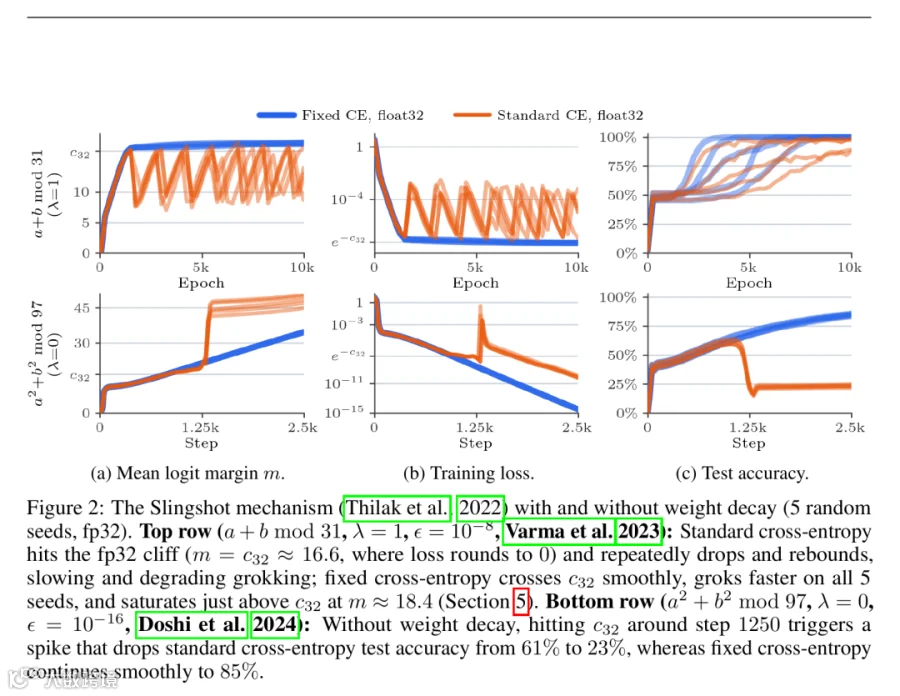 蓝色为修复版本,橙色为标准版本;上排是有权重衰减的模 31 加法,下排是无权重衰减的模 97 平方和任务,均为 fp32、五个随机种子 | 来源:A Fix for Softmax and Cross-Entropy,v1,Figure 2
以模 31 加法为例,任务是预测两个整数相加后除以 31 的余数。单层 Transformer 使用 50% 的数据训练,以全批 AdamW(在 Adam 之外单独施加权重衰减的优化器)更新参数,权重衰减系数为 1, 。在这组条件下,五个种子的测试准确率从标准版本的 94.3%±5.4% 提升到修复版本的 100.0%±0.0%(均值±标准差),相应损失尖峰消失。
蒸馏实验则把学生直接初始化为教师的同一份权重。教师已在模 53 加法任务上达到 100% 测试准确率,继续蒸馏本应没有更新。实验在温度 4、无权重衰减、Adam 的 下运行 2000 步;温度通过缩放 logits 调整概率的集中程度。
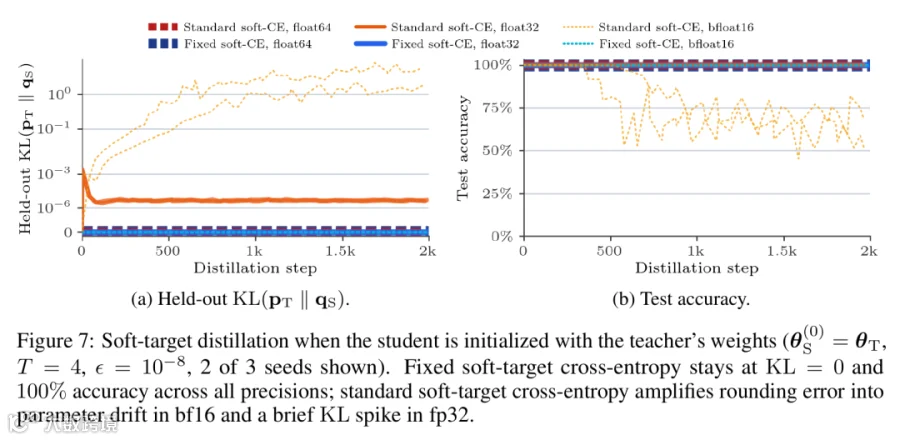 学生复制教师权重后继续训练;左侧衡量师生分布差异,右侧为测试准确率,图中展示三个随机种子中的两个 | 来源:A Fix for Softmax and Cross-Entropy,v1,Figure 7
标准版本中,使用 16 位浮点格式 bf16 时出现漂移和准确率下降,fp32 时出现分布差异尖峰;修复后,bf16、fp32、fp64 三种精度下都保持师生分布一致与 100% 测试准确率。这个实验说明,数值误差本身就能制造训练变化。
但这些结果尚不足以证明,所有大模型训练都因此受损,或替换后都能明显提升。作者明确说,实验探测的极高置信度和极近师生输出,在常规大规模训练中并不常见;论文没有给出大语言模型预训练的整体收益验证。
修复数值计算也不保证每次训练都达到满分:前述模 31 实验将 改为 后,fp32 修复版本的测试准确率为 99.0%±2.3%。
因此,值得重点排查的是高置信训练和近一致蒸馏中的异常梯度。Softmax 用途广泛,不能单凭这一点就把局部实验外推到所有注意力计算、推理输出或线上模型。
怎么解决:保留小量,也要修复求导路径
先看前面的三分类例子。把两个错误类别的指数项之和记为 ,这里 。损失对正确类别 logit 的梯度记为 ,可以写成:
左边先得到一个接近 1 的概率,再减 1,小量可能已经丢失。右边把小量留在分子里,即使分母舍入成 1,仍能保留约为 的梯度。
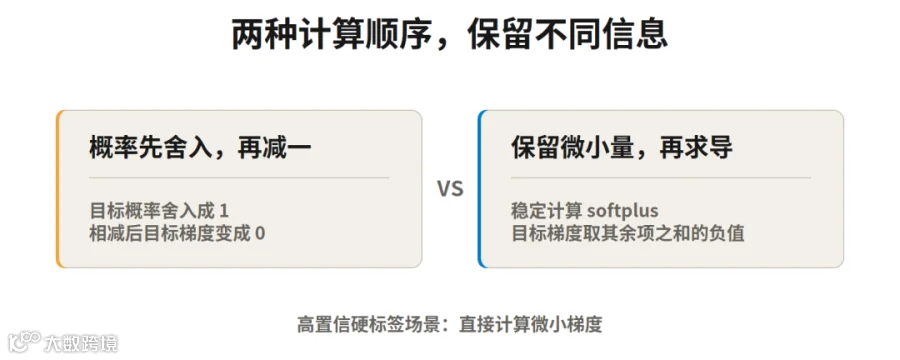
图中的 softplus 计算 ;采用数值稳定的实现,才能在结果接近零时保留小量。
实际修复还要让损失计算和自动求导沿着稳定路径执行。对于硬标签交叉熵,也就是目标只有一个正确类别的损失,论文将目标项与其他项分开,利用 log1p 等函数计算微小修正,并使目标类别梯度通过其他类别梯度之和的负值获得。log1p 专门计算“1 加一个小量再取对数”,避免先把这次加法粗略舍入。
蒸馏则需要另一条修复路径:直接接收师生 logits,从它们的差值出发构造概率差,借助 expm1 和 log1p 保留微小差异。expm1 专门计算“指数减 1”,在输入接近零时比先求指数再减 1 更准确。软目标版本还专门指定反向传播使用的梯度,同时保留前向交叉熵值。
因此,只替换一个普通 Softmax 调用,并不保证同时修好两类问题。硬标签损失、软目标损失及其反向计算,需要分别核对。
采用实现时还有一处重要更新。作者当前项目页披露:早期示例代码在除一个 logit 外其余项都近似负无穷时,可能产生 NaN 梯度;这种输入可出现在因果注意力掩码或极端分数中。原因涉及对零取对数后的自动求导。当前代码已调整相应计算,作者说明论文实验所用内部代码没有这个问题。
这也意味着,修复不能只验证普通输入,还要检查掩码、极端分数和反向梯度。采用前应核对作者当前参考实现和勘误,再在自己的输入范围内测试。
对自己的项目,先检查什么?
排查时,先确认 Softmax 和损失实际在哪种精度下计算。模型权重是 bf16,不代表损失也以 bf16 执行;实际计算精度影响误差出现的位置。
高置信分类训练可以检查:正确类别的梯度是否突然变为零,而其他类别仍有非零梯度。近一致蒸馏可以检查:将师生设置为相同 logits 时,学生梯度是否仍有残余。测试时应固定教师目标,只检查这项损失对学生 logits 的梯度。即使它为零,权重衰减等其他训练项仍可能更新参数。
若复现了对应问题,再对照更新后的实现比较前向损失、反向梯度和训练曲线,同时测量吞吐与内存开销。提高精度可作为对照手段,但只会推迟部分数值问题;也不能把所有损失尖峰都归因于 Softmax。
我更看重这项研究提供的排查路径:先找到小量丢失的运算,再检查梯度如何改变,最后验证优化器和训练结果是否受影响。沿着这条链做对照,才能判断修复对自己的任务有没有价值。
OPD 不是第四种万能后训练:它在 SFT、RL 与 RSI 之间到底在哪
参考资料
•A Fix for Softmax and Cross-Entropy,v1(本文实验数据及来源图): https://arxiv.org/abs/2610.31642v1
•作者项目页(两类误差、当前参考实现与代码勘误): https://jonbarron.info/softmaxfix/
•Grokking at the Edge of Numerical Stability,ICLR 2025(此前对 Softmax Collapse 的研究与缓解方法): https://proceedings.iclr.cc/paper_files/paper/2025/hash/c9e6ac15e689e06139d7b39e1667b165-Abstract-Conference.html
•JAX 官方文档(数值计算库及自动求导能力): https://docs.jax.dev/en/latest/
文章仅做学术分享,如有侵权请联系删除,非常感谢!