输入一张场景图和一条任务指令,RynnUnify自己拆子任务、生成下一段预测视频、再根据预测结果规划下一步;遇到「看不见的未来状态」类问题,它还会自己决定要不要先生成一段视频再回答。同一个16B模型,往下再接一个动作头就能直接开机器人。
统一多模态模型(UMM)这两年把理解和生成塞进了同一个模型,但在具身场景里始终差一口气:跨任务子步骤的长程rollout里,场景一直在变、预测误差不断累积,静态的一张预测图说明不了「操作之后世界会怎样」。达摩院去年到今年这条Rynn线(RynnVLA、RynnBrain)攒下的判断是:机器人大脑需要的是理解、预测、动作三者共享同一个底座。
RynnUnify就是这个判断的落点。它基于Cosmos3的Mixture-of-Transformers架构,8B自回归推理器负责理解和规划,8B rectified-flow生成器负责把「下一个子任务会发生什么」画成视频,两侧通过joint attention交互。在此之上做了两个扩展:一个8B agent从推理器RL而来,学着决定「直接答题还是先调生成器看一眼」;再把整个模型接到动作头上变成世界-动作模型(WAM),在仿真和Astribot S1真机上验证。
效果落在三个数字上:自建的长程视觉规划基准Rynn-VP上,总分从Cosmos 3 Nano的45.05提到54.80;生成辅助推理基准Rynn-GEU上,RL训练的agent把平均分从44.0提到50.0,超过GPT-5.6-Terra的45.1;RoboCasa365的20个复合移动操作任务成功率51.5%,真机三项任务平均46.7%。代码与权重已放出,主体Apache-2.0,Base权重31.50GB(bf16)。
 图1:RynnUnify四项能力的成绩单——具身理解与定位(UMM平均第一)、长程视觉规划(Rynn-VP 54.80)、生成辅助推理(Rynn-GEU 50.0)、机器人控制(RoboCasa365 51.5%与真机46.7%)。
效果展示
将粉色毛绒玩具放入黑色背包中 -> 从沙发上拿起那个红色毛绒玩具 -> 将红色毛绒玩具放入黑色背包中。-> 向下按压背包即可将其关闭。-> 向下按压背包即可将其关闭。
相关链接
-
论文:https://arxiv.org/abs/2610.32965 -
代码:https://github.com/alibaba-damo-academy/RynnUnify -
主页:https://alibaba-damo-academy.github.io/RynnUnify.github.io/ -
模型权重:https://huggingface.co/collections/Alibaba-DAMO-Academy/rynnunify (Base / Agentic-Reasoner / WAM-RoboCasa三个仓) -
ModelScope(国内镜像):https://www.modelscope.cn/collections/DAMO_Academy/RynnUnify -
开源协议:代码Apache-2.0,三个权重仓均标注apache-2.0;但NOTICE写明visual-planning组件保留NVIDIA版权与OpenMDW-1.1声明、RL组件含Relax(Apache-2.0),商用前需核对THIRD_PARTY_NOTICES.md
内容介绍
一句话说:RynnUnify是一个16B统一具身模型,输入任务指令和当前观测,输出下一段预测视频;往下接动作头就输出机器人动作,往上加一个RL训练的8B agent就输出「看没看过预测视频都更准」的推理答案。
与「理解和生成各管一段」的常规UMM不同,核心特点有三个:
-
视频生成是推理的中间步骤,不是终点:推理器决定下一个子任务、写好结构化视频提示词并估计时长,生成器画出来,画完的最后一帧变成下一步的观测——理解与预测在同一个模型里循环; -
生成器自己决定用不用:BCPO让8B agent对每道题评估「直接答」和「先生成再看」两条路的期望收益,只在生成有把握带来增益时才调用冻结的生成器; -
同一个底座直通机器人:推理器产出连续的子任务latent,经layerwise attention条件化生成器,动作头从生成器的36层视频特征里读出48步动作块。
适用场景:需要长程任务分解与状态跟踪的机器人操作、把世界模型当「推理工具」而非「输出产品」的具身智能研究、以及想在统一底座上同时做理解评测和动作控制的工程团队。
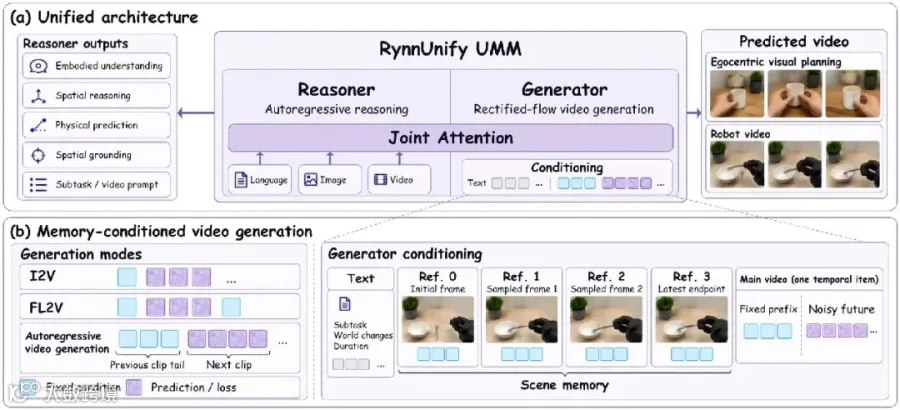 图2:架构总览。(a)推理器与生成器共享joint attention;(b)记忆条件化的视频生成支持I2V、首尾帧FL2V和跨chunk自回归续写,场景记忆由初始帧、历史关键帧和最近endpoint四组参考帧加时间前缀构成。
方法概述
一套机制管「怎么记」,一套机制管「要不要想」,一套机制管「怎么动手」。
1. 跨chunk场景记忆与自条件训练(Cross-chunk Scene Memory + Self-Forcing)
长程规划最大的敌人是「出了视野就忘」。RynnUnify维护四个独立编码的参考帧——固定的初始观测、两个从历史里选出的关键帧、最近一步的endpoint——再加上一段来自上一chunk尾部的连续视频前缀,组成跨chunk场景记忆。参考帧负责锚定场景外观和布局,时间前缀保留最近的运动与交互上下文;三段信息都直接拼进token序列,不引入额外的记忆编码器或cross-attention模块。训练侧对应地做了自条件:以0.3概率对条件帧加高斯噪声(σ∈[0,0.15])、以0.5概率做降采样-上采样模糊,逼生成器学会从「自己画的不完美历史」继续往下画。生成数据总计1,083,458个clip、约1,370小时;理解侧用RynnBrain预训练语料的10%子集约2.0M样本打底,视觉规划数据124万样本,具身感知与推理19.66万样本。
2. 分支条件策略优化(BCPO)
这是全文最有意思的一步。先看反例:论文把BAGEL、RxBrain、Cosmos 3 Nano的「交错生成」版拉出来测,Rynn-GEU平均分全线下跌——BAGEL从11.9跌到10.8,RxBrain从31.4跌到28.6,Cosmos 3 Nano从37.3跌到33.5。生成的视频里如果有扭曲的几何和错误的动力学,后续推理只会被带偏。BCPO的解法是把「要不要生成」本身变成可学习的决策:每道可路由的题采样8条轨迹(4条直接回答、4条先生成再答),分支内用GSPO做相对优势比较,分支间用两组奖励均值之差sigmoid后当软目标,教推理器预测调用概率;奖励是格式合法性乘答案质量,数值与几何题用归一化误差映射(δ=0.30)给连续分。训练用了22,007道题,agent从8B推理器初始化,lr 1e-6跑一个epoch,生成器全程冻结。结果是Rynn-GEU平均从44.0提到50.0,其中Area从35.9跳到66.2、Mess从8.5跳到29.1,且三个公开推理基准(MMSI/MindCube/ERQA)不降反升。
 图3:BCPO框架。agent在「直接回答」与「生成辅助」两条路间自主路由,分支内GSPO管推理质量,分支间奖励差管调用决策,RL只更新agent。
3. 世界-动作模型扩展(WAM)
把理解和预测兑现成动作:推理器从任务指令、当前三视角观测和视觉历史(最多12张图)里产出连续的子任务latent,经layerwise attention条件化生成器预测未来视频;一个18块的action head从生成器36层视频特征里以cross-attention读特征,用flow matching预测48×12的动作块(20Hz、覆盖2.4秒),推理时执行前16步。训练用RoboCasa365约1,600小时原子任务加177小时复合任务轨迹,分三阶段推进;真机适配(Astribot S1)时冻结推理器,只训生成器和动作头。这个设计的含义是:动作预测消费的是「世界会怎么变」的表征,而不是直接从观测黑箱映射到动作。
实验结果
公开具身理解(Table 2)
RynnUnify在十个指标的平均分57.9,是被评UMM里的最高分(Cosmos 3 Nano 53.2、RxBrain 44.9、BAGEL 28.0),十项里六项第一。但注意它不是碾压:MMSI-Bench 35.9低于RynnBrain-8B的39.6,MindCube 44.2明显低于RynnBrain-8B的56.6——生成能力的加入伴随纯理解侧的局部回退,这是统一模型的老代价。
Rynn-GEU:生成辅助推理(Table 3)
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| RynnUnify+Agentic | 50.0 | 66.2 | 29.1 |
|
|
|
|
|
|
|
两个必须说清的点:一是对手的「交错生成」全在掉分,只有RynnUnify的agentic版涨分——差异化不在「能生成」,在「会挑题生成」;二是涨分不是无差别的,Pos/Dist/Size三个精细几何题在agentic rollout后分别从38.5/52.9/57.0降到36.0/51.8/56.5,生成的视频在细粒度几何上仍有失真。
Rynn-VP:长程视觉规划(Table 4)
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
| RynnUnify |
|
45.66 | 60.54 |
|
54.80 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
总分计算为0.50×PI+0.40×VR+0.10×VQ。涨分全部来自规划和实现(PI+15.16、VR+5.96),VQ反而略降。另外别漏了第一行:拿GPT-5.6-Terra规划、MiniMax-H3生成的组合系统得分65.71,比RynnUnify高10.91分——统一模型的完整叙事面前,still有一堵组合大系统的高墙。
 图4:Rynn-VP定性对比。玩具收纳任务里RynnUnify能连续推进多个玩具的转移;枕套折叠任务里对手纷纷出现尺度跳变或背景漂移,RynnUnify保持布料状态连续演化。
RoboCasa365与真机(Table 5/6)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
57.1 |
|
|
|
|
|
|
|
| RynnUnify |
|
50.0 | 51.5 |
Unseen分榜第一(超CMA6.0、超Cosmos 3共11.0个百分点)是含金量最高的一格;Seen分榜输给Xiaomi-Robotics-1的57.1,论文没有回避。真机Astribot S1三个任务各20次试验:转向抓取55.0%、换位35.0%、三次放碗后取勺50.0%,平均46.7%,对比GR00T N1.7的26.7%和π0.5的25.0%。其中「三次放碗后取勺」考的是对已完成动作轮次的记忆,50.0%对35.0%的领先部分印证了视觉历史的价值。
局限与未来方向
首先,生成的视频会扭曲细粒度几何。Pos/Dist/Size三项在agentic rollout后下降,论文自己也把这条列为第一挑战——「预测出来的画面」目前还不能当精确测量仪用。
其次,算力门槛不低。Base权重31.50GB(bf16、7分片),24GB消费级卡装不下;BCPO训练时每道题要采8条轨迹、生成辅助分支每次都要真实跑一遍生成器,论文把「降低闭环控制的交错生成成本」列为未来工作。社区10-24已出GGUF量化(两天2,814下载,同期官方仓才42下载),部署侧在跑通,但速度数字官方未给。
再次,对比栏里有个不点击正文容易漏掉的强对手:GPT-5.6-Terra+MiniMax-H3组合系统在Rynn-VP上比RynnUnify高10.91分,「统一」目前换来的更多是工程简洁性而非分数优势。
此外,真机验证只有三个任务、每任务20次,动作head未见独立消融的完整公开;论文无独立Limitations小节,上述边界部分需要从Future Work里读出来。
结论
RynnUnify验证了一件事:在具身场景里,视频生成的价值不在于画面本身,而在于它能不能被按需调用、被正确解读——BCPO把「用不用」交给模型自己学,把「误用」的风险关在了分支路由里,这是它与同类UMM拉开差距的地方。
对于做具身智能研究的人,这份工作是「理解-预测-动作同底座」路线目前最完整的开源样本,BCPO的分支间软路由设计(每题8条轨迹的成本账)值得精读;对于关注开源生态的工程师,三个权重仓加ModelScope镜像可以直接落地评测,但31.50GB的体量和NVIDIA组件的OpenMDW-1.1声明让「消费级可跑」和「随意商用」两个说法都不成立,动手前先看THIRD_PARTY_NOTICES.md。
机器人要的不只是看懂世界,还得在动手前先把「动过之后的世界」想一遍——这篇工作把想的过程变成了可以训练、可以路由、可以被奖励塑造的一段计算。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~