

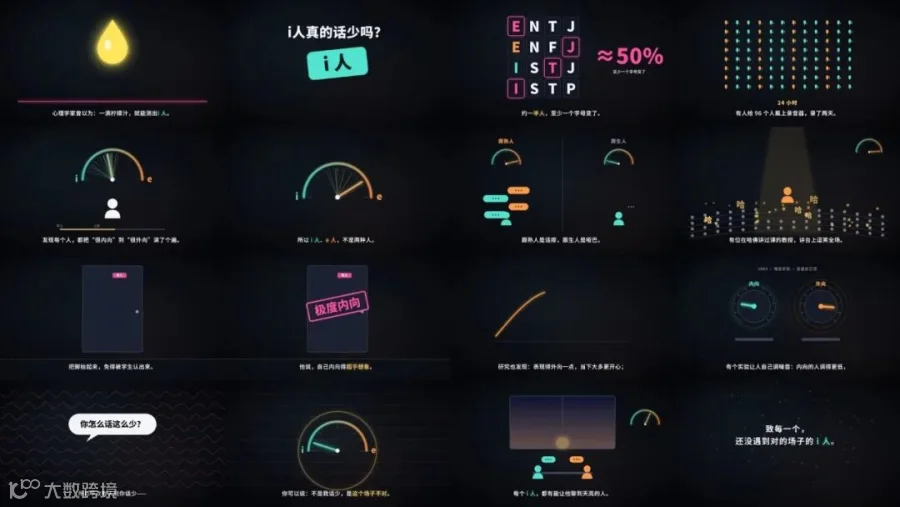
下面这两支片子,从文案、画面到配乐,都是我让 Claude 写代码做出来的。
什么剪辑软件、素材库都没找,也没有花钱买版权音乐,一支讲峰终定律,2 分 27 秒;一支讲 i 人到底话少不少,2 分 21 秒。
|

|
这就是最近爆火的用claude做代码视频,B站有个up主叫比特新语,靠做这类视频短短几天就涨粉到了几十万,这篇文章我大家如何做这个视频。
这类视频一般是用2-5分钟的时间,讲一个心理学、哲学或者思维上的概念,没有人声,纯靠字幕+配乐,画面的背景用的也都是深色背景。
整个流程
WORKFLOW · 流程 + 审核
可以看到这个流程,我们只需要在选题、视频文案、样片以及最终的成片那审核一下,其余的都丢给Claude自己跑。
选题:一个反常识的问题,一个能画出来的东西
TOPIC · 反差 + 实验
这几条是我做峰终定律、i 人两支片子,以及参考别人的爆款视频后,让AI帮忙一起总结的经验:
- 整个片子要围绕一个有反差感的话题,
起手帧就应该抛出这个问题,比如“你的手机充到 80% 以后,为什么突然变慢了?”,观众一看就想知道答案。 - 收尾要打动人,
片子最后要让人记住的那句话。比如峰终定律是“记忆不算总账”,i 人那支是“i 人、e 人是同一个人在不同场合的样子”。 - 有实验、人名、年份、数字。
在支撑论证的时候,需要查一些论文,拿一些科学实验来证明,会提升论证的有效性。
还有就是这个话题最好不要过长,几分钟就能讲完,否则就会给人一种听课的感觉,在短视频的场景下体验尤其差。
调研
RESEARCH · 论文 + 核查
这一步非常容易翻车,我会让 Claude 查原始论文,每个说法分三档:一手来源直接用,二手来源标清楚,查不到出处的不会用,搞完后我还会用GPT再帮我做一遍事实核查,论幻觉率,GPT应该是当之无愧的王者,目前我用过的所有模型里最低的。
视频文稿
SCRIPT · 分镜 + 爽点
这里视频分镜,我会让AI在文档用下面的表里写出来,方便我审核,比如这是讲 i 人那个视频的一部分文稿:
秒 |
字幕 |
爽点 |
画面 |
配乐 |
0 |
心理学家曾以为:一滴柠檬汁,就能测出 i 人。 |
钩子 |
第 0 帧就是发光的柠檬汁大特写,1.5 秒落下炸开涟漪 |
第 0 秒一声清脆的“滴” |
4 |
1967 年,100 人实验:越内向,口水越多。 |
数据砸脸 |
涟漪化成 100 个小人,排成散点图 |
拨弦脉冲 |
8 |
两年后,有人重做一遍,没差别。 |
打脸反转 |
斜线“啪”地断掉,散点散成一团 |
唱片刮擦,停顿 |
12 |
再后来发现:这招只在上午灵。 |
笑点 |
太阳从左划到右,过了中午,柠檬熄灭 |
俏皮的下滑音 |
16 |
(标题)i人真的话少吗? |
|
一枚“i 人”标签“啪”地贴上屏幕 |
重击,主题进来 |
28 |
约一半人,至少一个字母变了。 |
数据砸脸 + 笑点 |
MBTI 字母牌翻面,闪出“≈50%” |
滑稽拨弦 |
这里需要注意,为了适应短视频的节奏,我们最好一句话对应一个画面,不要长时间让画面停住,否则观众就会划走,我一般用的是下面的几个原则:
-
一屏一句,12 到 20 个字,停 4 秒左右。 -
前 2 秒,第 0 帧就要有画面、有字幕、有声音,第一句字幕直接抛出全片要回答的那个问题,最好和标题是同一句。 -
爽点每 4 到 8 秒一个。我用的分类是:被说中、认知反转、数据砸脸、替你正名、笑点、悬念回收、社交货币。 -
结构按比例排:冷开场,12% 左右出标题,中间一大段证据,55% 左右给一句话定义,60% 左右拆自己一下,后面回到观众,最后一句收住。
Claude 写的第一版文稿,通常是能清楚了,但有时候会有AI味,我们还得自己改一版。不过Claude有时是有点幽默感的,i 人第一版让它照着爽点类型逐句拆,它拆出了厕所隔间那一段,“一位在哈佛讲过课的教授,讲台上逗笑全场,有时下了课就躲进厕所隔间,把脚抬起来,免得被学生认出来”。

配乐
MUSIC · 采样 + 卡点
这里我也查了一下,版权音乐很多是要付费的,免费曲库无法让AI去操作,因为有人机验证,我就直接让Claude自己写了。钢琴和弦乐用的是 VSCO 2 社区版采样,GitHub 上能下,CC0 协议,商用不用署名。拨弦和音效用代码直接合成。Claude 用 Python 写了个小引擎,像写谱一样写“第几秒、哪个乐器、什么音、多大力度”,渲染出 wav:
s = Score(length=40)
s.note('piano', 3.0, N('A5'), vel=0.4, dur=2.0)    # 3 秒处一个钢琴单音
s.pad('cello', 18.0, [N('F2')], dur=5.0, vel=0.5)   # 18 秒大提琴铺底
s.sfx('riser', 18.0, align='end')                   # 标题前蓄力
s.sfx('impact', 18.0)                               # 标题重击
s.render('out/demo')
Claude让我很惊艳的地方在于卡点,它的配乐和字幕每次都能对应上,虽然我不懂乐理,但听还是能听出来的,确实比其它模型强很多。
画面
VISUAL · 深色 + 留白
画面我这里选择的是remotion框架搭建的,个人和小团队都能免费用,每帧都是代码算出来的,能精确的卡点。
视觉风格选择的是深色底,发光的主体、胶片颗粒、暗角,一帧里东西少、留白多,但帧与帧之间变得快,这个也是参考了一些爆款视频得出来的。
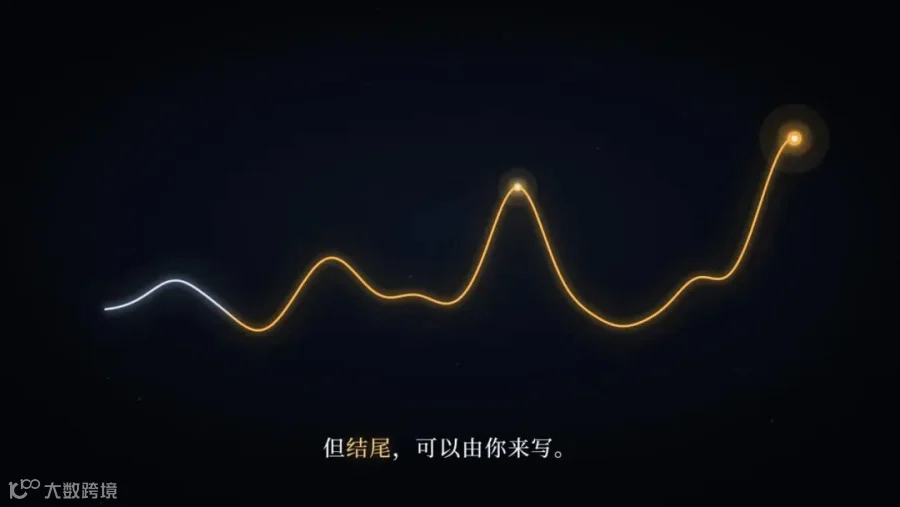
贯穿全片的那个东西,要换着形态出现。i 人那支的指针表,开场是一枚“i 人”标签贴上屏幕;中段标签被撕开,露出下面一直在摆的指针;讲教授时它打到 e 的尽头;倒数第三句它甩回 i,周围的嘈杂一键静音。
之前峰终定律的视频节奏很慢,发出去后跳出率很高,它平均 29 秒一次画面,最长有 115 秒没大变化,然后我会在最后让AI检查下画面变化的频率,不符合要求会重新打回去,大概是2s左右要变化一次,每次变化还得和音效对应上
质检:让它截图给自己看
QUALITY · 抽帧 + 检查
每做完一段,需要让 Claude 按秒抽帧,拼成一张联系表,就是文章开头那两张图,让它自己看一遍,比如检查字幕有没有遮挡住画面,文字是否重叠,元素是否外溢等等。
成片前再检查一下前 3 秒的画面和音量、全片节奏(大变化间隔、字幕对齐率、静止段)、整体响度。这里如果都没问题就渲染出片。
标题和封面
TITLE · 句式 + 封面
标题我暂时用了个固定的句式《主题》+ 一句反常识的话 + 冒号 + 一个算式,比如:
-
《峰终定律》记忆不算总账:(峰 + 终) ÷ 2 -
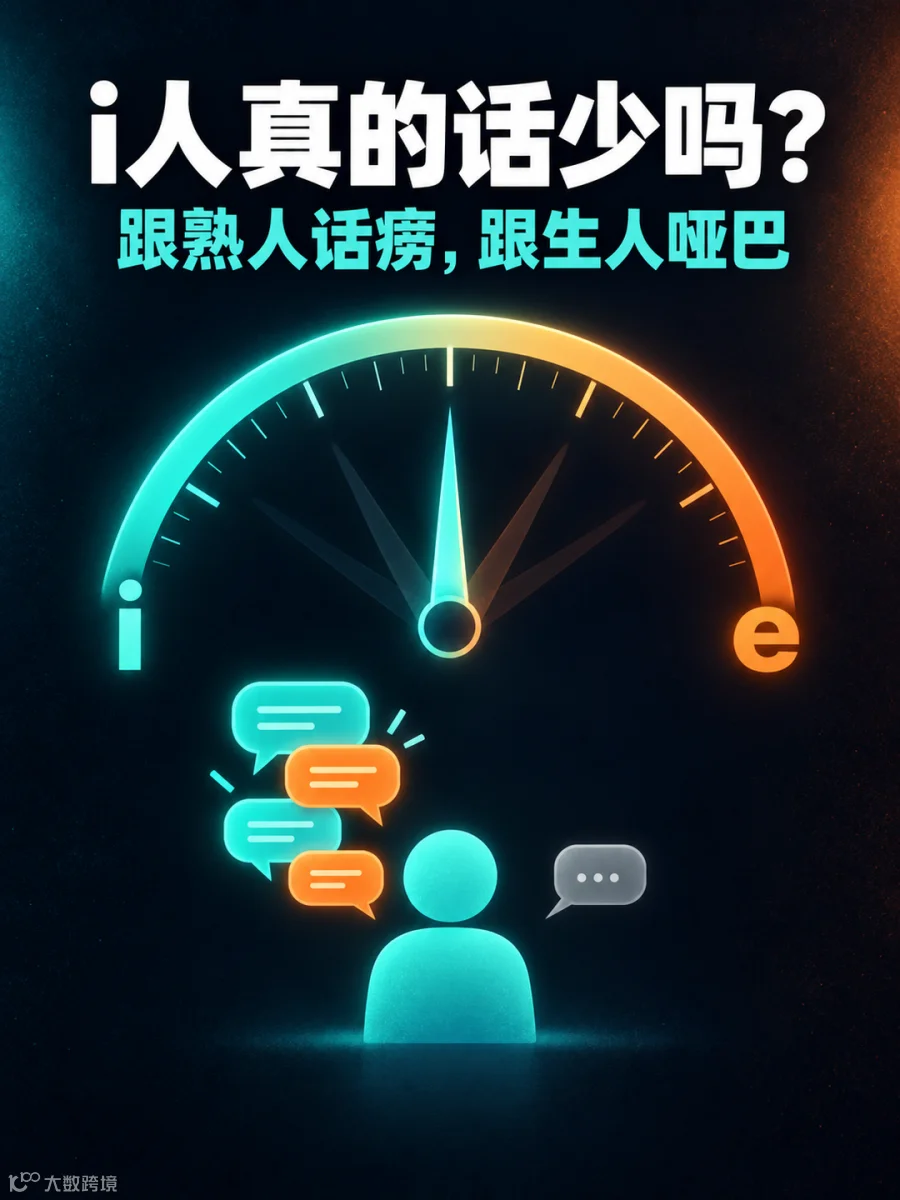
《i人》真的话少吗:一个人 = i + e
封面用 gpt-image-2 直接生成 3:4 和 4:3 两张图。
|
|
到这里就总结完了,你可能觉得太多了记不住,不过没关系,我直接把这个Skill开源了,我这个Skill只放了做视频的流程,具体的视觉、交互示例一个没有加,因为我觉得Claude的模型能力足够强,已经不需要给它这些了。
我的Skill开源地址在:github.com/limowan/mw-concept-video
如果觉得有帮助,可以帮我来个star。