


大家好,我是静远,一个天天在用AI做一人公司的架构师。
文末有我的微信,需要我天天在用的Agent运营工作流同款说明(技能调度、定时任务、多代理协作这套harness的配置思路),还有我在用的一人公司知识库目录模板的朋友,加好友备注领资料即可,打包直接发送。
相信大家最近,已经听“Agent”这个词听到耳朵起茧了。
Agent元年、Agent编程、通用Agent、Agent军团……我后台几乎每周都有人问同一个问题。Agent到底是个啥?它跟ChatGPT这种聊天框,到底差在哪?
是更聪明的模型吗?是换个皮肤的聊天机器人吗?还是又一个圈内人发明出来炒概念的新词?
都不是。
讲道理,我一开始也觉得这玩意虚。直到我自己用一支Agent军团,把内容产线、选题、发稿全跑起来,一个人干出一个团队的活,我才想明白,Agent不是玄学,它的原理你今天就能懂。
而且不需要任何编程基础。
今天这篇文章,我把Agent拆开揉碎,从大模型聊天的原理讲起,一步步给你推导出Agent的本质。看完这篇,市面上一堆Agent课程里的第一章,你基本可以跳过了。
话不多说,我们开始。
一. 先泼个冷水,LLM没有记忆
要搞懂Agent,得先搞懂它的心脏,大语言模型,LLM。
而关于LLM,我身边90%的人都以为,它像人一样,聊过的话会记住。
其实LLM没有记忆。一点都没有。
它每次干活,都是一次全新的、失忆的阅读理解。
这事你要验证特别简单。打开API文档,看一眼LLM的接口长什么样,就全明白了。整个接口的核心就一个参数,messages,消息列表。
你发给它的,是一整段对话记录。谁说了什么、谁又说了什么,一条条排好队。它要做的事情只有一件。看着前面所有的对话,预测下一句该说什么。
就这样,没了。

所以问题来了。既然它没有记忆,那我们在网页里跟它多轮对话,它怎么表现得“记得”上一句说了啥?
答案特别朴素,也特别反直觉。你的客户端每次都把全部聊天记录,原封不动重新发了一遍。
你说一句,它答一句。你再说一句,客户端就把你第一句、它第一答、你第二句,打包成完整记录,发给模型。模型看完这一大坨,接一个下一句。
你以为的连续对话,底层是无数次独立的“一次性阅读理解”。
每一次请求,都是一个失忆的人,拿到一整本对话记录,现场读完,现场接话。
理解了这一点,好几个你日常遇到的怪现象就全通了。
为什么聊得越久,它反应越慢、账单越贵?因为每一次提问,它都在重读全部历史,聊天记录越长,这次阅读理解的量就越大。
为什么聊着聊着,它会忘掉开头说过的话?因为记忆不在它脑子里,是塞在上下文这个工作台上的。工作台就这么大,聊到后面,最早的内容可能被挤出去,或者被淹没在十万字里,找不到了。
为什么开了新对话,它就六亲不认?废话,没人给它递历史,它本来就是个刚落地的失忆患者。
看到这,你可能会慌。没有记忆,那它岂不是个精致的复读机?
先别急。这个失忆的阅读理解机器,其实是整篇文章里最贵的一个零件。它脑子是现成的,缺的是手脚。
二. 只能聊,不能做
现在你知道了LLM的本职工作,看着messages列表,吐出下一句话。
注意这个能力边界。它全部的产出,就是文字。
它能让对话看起来很精彩。但你让它帮忙整理一个文件,它只能回你一段文字,描述整理完大概长什么样。文件在哪?它根本看不见。
因为模型被关在一个盒子里。它的整个世界,只有你递进来的对话记录,别的什么都没有。没有你的电脑,也没有网线,文件系统就更够不着了。
你能跟一个被隔绝在玻璃房里、只有嘴巴能动的人合作什么?
这玩意只能聊,不能做。
但是转折来了。
既然它的能力是看完对话、吐出文字,那如果我们跟它约定一种特殊的文字格式,让它吐出来的内容变成一条指令呢?
比如它看完你的话,先不急着回答,而是吐出一句,请帮我执行读取文件,文件名是某某。
它在玻璃房里喊话,我们在玻璃房外面听到,去真正执行,再把结果递回去给它看。
它有脑子,我们有手脚。
这,就是一切的大门。function call,工具调用。
三. function call,给嘴炮装上手脚
2023年6月,OpenAI发布了一个API能力,叫function calling。
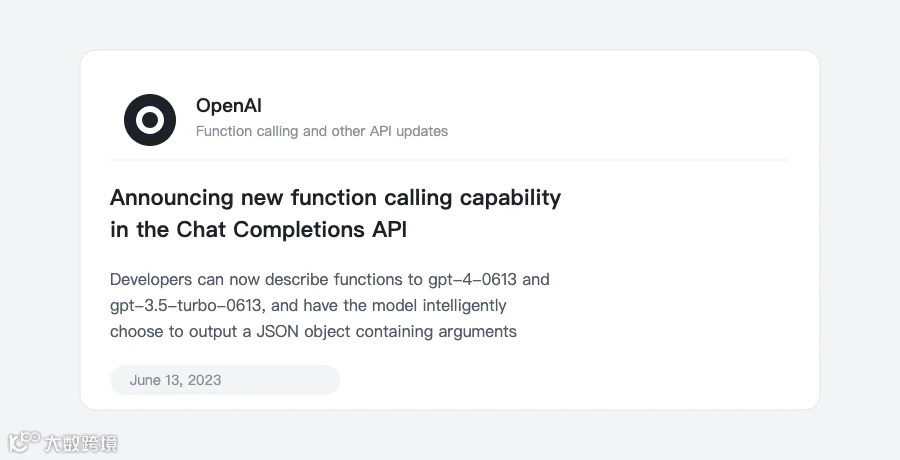
名字很直白,就是函数调用。用人话说。
开发者可以提前告诉模型,这有几个工具,每个叫什么名字、是干什么的、需要哪些参数。模型聊天过程中如果觉得用得上,就不直接回答,而是吐出一段结构化的JSON,告诉你我要用哪个工具,参数是什么。
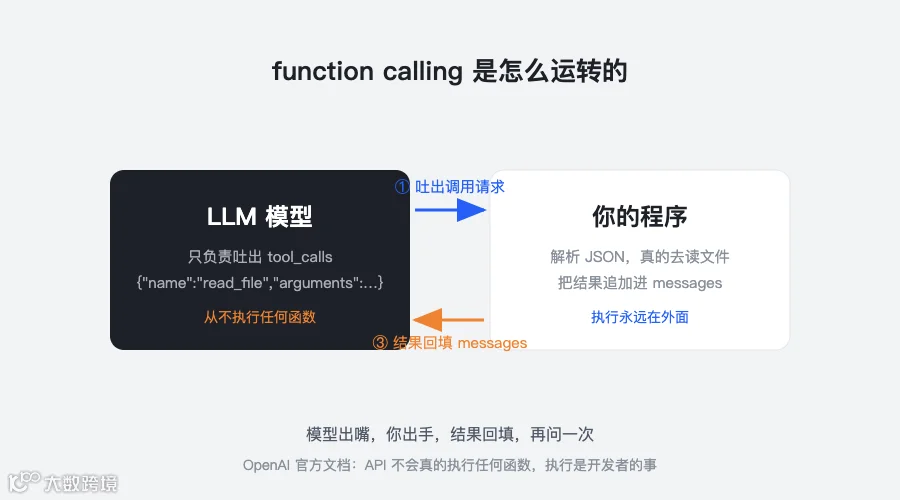
注意那个最关键的官方原话,OpenAI的文档里写得明明白白。API不会真的执行任何函数,执行是开发者的事。
这句话就是Agent的第一性原理,值得单独抄在本子上。
模型只负责决定调用什么、填什么参数,执行永远在外面。
整个流程就三步。
第一步,把说明书和对话一起发给模型。说明书就是工具清单,每个工具一条,名字、描述、参数格式。这份说明书用JSON Schema描述,你不用管这个词,理解成一张标准化的工具登记表就行。
第二步,模型判断这事用得上某个工具。它吐出来一个tool_calls,说要调read_file,参数是{"path": "xxx"}。
第三步,我们收到这段JSON,在外面真去读文件,把文件内容作为结果,追加进对话记录,再发给模型。模型看完结果,这次才给你正经回答。
一句话总结。模型出嘴,你出手,结果回填,再问一次。
这里有个特别容易搞混的点,必须说清楚。
很多人以为工具调用是模型学会的新技能。没错,确实是练出来的。从gpt-4-0613开始,模型专门被训练过,看得懂工具说明书,吐得出合法的参数JSON。
但它自始至终没有执行过任何东西。
它学会的只是点菜。做菜的,永远是玻璃房外面的你。
2023年11月,OpenAI又把functions参数升级成了更通用的tools参数。后来各家模型全跟进了这套规范,工具清单还是那个清单,JSON Schema还是那个Schema,规矩也没变过,模型吐调用,外部去执行。
所以你今天看到的几乎所有Agent产品,不管界面长什么样,底层都在跑这一套。
为什么这个设计牛?因为它把想和做,干净地切开了。
模型负责决策,调什么工具、传什么参数。外面的程序负责执行,真去读文件、真去发请求。决策是模糊的、需要智能的。执行是确定的、写代码就行的。
一个出嘴,一个出手,拼起来,就是个能干活的系统了。
四. 手搓一个,能读你文件的Agent
光说不练假把式。现在我们就用LLM加工具调用,搓一个最小的Agent出来,一个能读你电脑文件的问答助手。
你问它某个md文件里写了什么,它自己去读,然后回答你。
不用框架,不用装任何东西,就靠上面说的原理。整个过程就一个循环,我把伪代码全贴出来,你逐行看。
  messages = [系统提示 + 工具说明书,用户问题]

while True:
 response = 调LLM(messages)           # ① 把整个对话发给模型

 if 模型吐了tool_calls:               # ② 模型说我要用工具
    result = 读文件(tool_calls的参数)  # ③ 我们在外面执行
    messages.append(模型的tool_calls)  # ④ 这轮喊话记进历史
    messages.append(文件内容作为结果)  # ⑤ 执行结果也记进历史
        continue                         # ⑥ 回到①,带着结果再问模型

    else:
        print(response)                  # 模型好好说话了,输出答案
        break                            # 任务完成,循环结束
就这十来行。
你输入一句,帮我看看某个txt里写了什么。第一轮,模型看完对话,吐出tool_calls,要调read_file,参数就是那个路径。循环捕获,真的去读,把内容塞回对话。第二轮,模型看着文件内容,给你正经总结。
一个能读懂你电脑的Agent,就这么跑起来了。
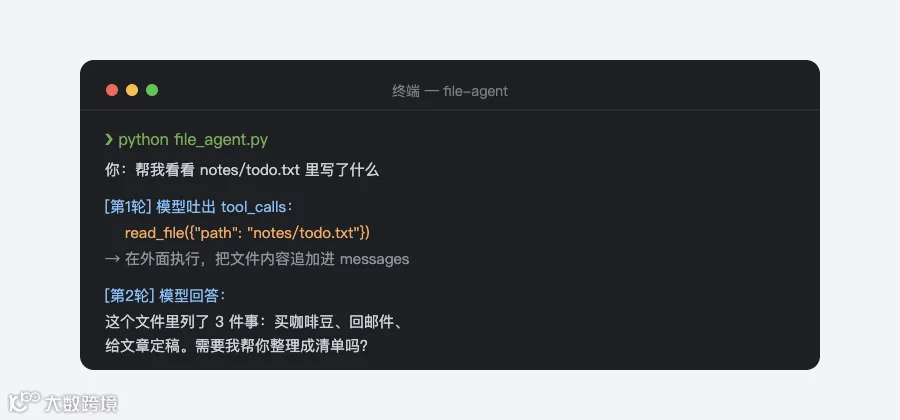
当然,这是个最小骨架,还有一堆细节没处理。工具不存在怎么办、参数填错怎么办,还有死循环的风险。但骨架就是这么简单,没有任何魔法。
现在,把三样东西放在一起看。一个没有记忆的LLM,一份工具说明书,一个while循环。
这就是一个Agent的全部。
**Agent = LLM + 工具调用。**没了。
你回头再去看市面上的Agent框架,LangGraph、Google的ADK、Dify、Coze,把界面剥掉,核心全是这套东西。调用模型,执行工具,结果回填,循环往复。
框架解决的问题只有一个,怎么用得更舒服、更稳定、更便宜。
原理就这么点。剩下的,全是工程。
五. 但是,裸奔的循环撑不了多久
如果Agent就到此为止,那也太简单了。你真拿上面那个十来行的循环去干正经活,会发现它很快就会翻车。翻车的方式特别有规律,正好是三种。
这三种翻车,逼出了Agent技术栈里剩下的所有东西。
第一种翻车,撑爆。
还记得吗,LLM没有记忆,每次请求都带全部历史。那Agent干复杂任务呢?读十个文件、跑几轮搜索、中间再犯几次错,对话记录蹭蹭涨。
很快就有两个后果。一是贵,每次都要重读全部历史,Token翻着倍地烧。二是笨,上下文塞得越满,模型越容易找不到关键信息。在Agent架构里,上下文是寸土寸金的。
这时候就需要上下文管理。哪些历史该留,哪些该压缩,还有哪些干脆直接扔掉。就像一个助理,桌面就那么大,文件得常整理,过期的归档,没用的碎掉。
第二种翻车,闯祸。
你给Agent一个读文件的工具,它可能顺手把你的密码配置也读了发出去。你给它一个删文件的工具,它可能为了整理目录,把你的稿子全删了。
它不懂轻重。它只是按目标找最优路径,而你的私域、你的钱包、你的生产数据,在它眼里跟普通文件没有任何区别。
这就轮到权限上场了。哪些目录能碰,哪些操作要人工点头,剩下的打死不能干。玻璃房外面那只手,得戴上手套。
第三种翻车,失忆。
任务干完了,对话一关,这次学到的东西、你的偏好、项目的背景,全没了。下次开新任务,它又是个刚入职的实习生,一切从头教。
这就需要记忆。把跨任务该留着的东西,存到对话外面去,下次干活先取出来放进上下文。
上下文管理、权限、记忆。这三样,没有一个出现在Agent = LLM + 工具调用这个公式里。
但缺了任何一样,这个公式都跑不远。
那这三样东西加在一起,算什么?
这些能力没有一样长在模型里,全在模型外面,是套在模型外面的一层运行装置。就像发动机再强,也得有车架、油路、刹车,才是一台能上路的车。
于是就有了那个更完整的公式。
六. Agent = LLM + Harness
业内给模型外面这层运行装置起了个名字,harness。直接翻译,马的装备。
给马装上缰绳、鞍具、蹄铁,马才能稳定地干活。给LLM装上上下文管理、权限、记忆、工具执行,LLM才能稳定地干活。
所以,Agent的完整公式是,Agent = LLM + Harness。
其中Harness里最重要的那个零件,就是工具调用循环。剩下的,上下文管理、权限、记忆、各种防跑偏的护栏,都是让这个循环能长期稳定跑下去的配套设施。
用这个公式,你可以重新理解你现在见到的每一个Agent产品。
Claude Code、Codex这类编程Agent,harness是文件读写、终端执行、权限确认、上下文压缩。我天天用的WorkBuddy,harness是技能调度、多代理协作、定时任务。MCP呢,也不是什么新的智能,它就是一个标准化的工具插口,让所有Agent能插上全世界的工具。甚至Skills这种东西,本质也是harness的一部分,什么时候往上下文里塞什么说明书,省着用这块寸土寸金的地。
各家产品的差异,不在LLM,在harness。
模型是买来的,同一个模型人人都能调。决定一个Agent好不好用的,是外面这套运行系统设计得精不精。
这也是为什么,理解了工具调用这一个变量,你就看懂了所有Agent框架。因为它们全是在给同一个心脏,配不同的四肢和护具。
我自己这一年的经营,本质上就是在给自己搭harness。哪个环节配什么工具、给多大权限、留多少上下文、存哪些记忆。模型月月都在换,harness是我自己的资产。
最后多说一句。
你可能会问,模型越来越强,这些东西会不会哪天都不需要了?
我的判断正好反过来。
模型越强,能放手让它干的事越多,harness就越重要。就像车越快,刹车和方向盘越不能省。
Agent不是更聪明的聊天机器人。
它是被装上手脚、戴上护具、放进一个精心设计的运行系统里的LLM。
脑子已经是现成的了。
接下来的十年,比的是谁更会给它造身体。
开头提到的领资料方式,扫码加我个人微信,备注领资料即可直接发送。

欢迎点赞收藏转发关注。
把你卡住的那个具体任务发我,我看看能不能拆成 AI 能参与的步骤。我们一起讨论。