
大家好,我是Tony Bai。
【导读】
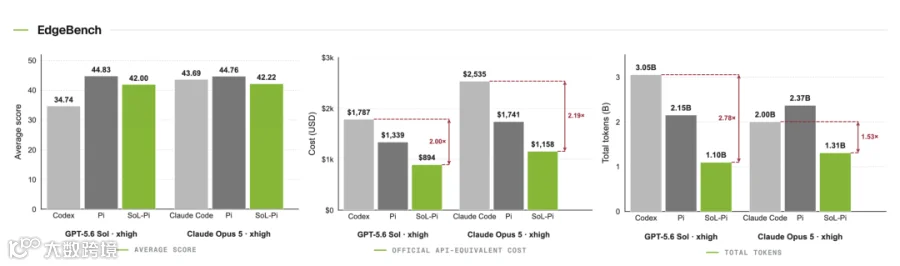
Agent 能不能自己改进自己的“Harness”?英伟达给出了一份工程答卷:SoL-Pi。它让 AI 在 535 个可执行环境里观察 Agent 的行为,自动提出、实现、评审、验证改进想法。152 个候选进场,只有 4 个机制活到最后。EdgeBench 上,它保留约 94% 的 Pi 基线得分,Token 降低 44.7%~49.0%,成本降低约三分之一,对比 Codex 与 Claude Code 原生 Harness 的 API 成本低 50%~54%。比数字更值得学的,是这条“可复制的自我改进流水线”。
【文章要点】
-
定位:SoL-Pi 是“RSI 启发”的 Harness 改进闭环,而不是 Agent 在线自改;人类提供先验并审阅幸存者。 -
闭环:152 个想法 → 独立研究循环 → 训练集筛选 → 冻结 → 留出集一次性验证,留出结果绝不回流。 -
护栏:预先声明、对优化器不可见的能力底线,只有“不少干活”的节省才算数。 -
产物:四个机制分别作用于动作、上下文、观测、委派。 -
结果:EdgeBench 成本约降 1/3(对 Pi)、降 50%~54%(对原生 Harness)。 -
工程启示:7 条 RSI Harness 搭建清单。 -
冷静看:得分约损失 6%;TB4 少解 3 题;搜索仅在单一后端;“递归高效改进”仍是愿景。
当 Agent 开始改进“自己的 Harness”
编程 Agent 的进化曲线陡得惊人:从补全一行代码,到跨仓库修 Issue,再到多个 Agent 连续跑上几天无需人盯。
能力越强,两个问题越尖锐。
第一,每一个 Token 都在推进工作吗?一次编辑后必然跟着的测试命令、被反复重放的巨型工具输出、早已完成却赖在上下文里的子任务……冗余会随轨迹变长而累积。
第二,既然 AI 已经能改复杂软件系统,它能不能改造生产 AI 的系统本身?这就是递归自我改进(Recursive Self-Improvement,RSI)。但 RSI 本身极其烧 Token:每一次尝试,无论成败,都在花钱。
英伟达的团队把两个问题接在了一起:与其先去规模化 RSI,不如先让 AI 把 Harness 变得更省,再让更省的 Harness 去支撑下一轮 RSI。
于是有了 SoL-Pi。对每一位做 Agent 的工程师来说,它最值得学的不是那 4 个具体机制,而是背后那条“让 Harness 自己迭代”的流水线。
先摆正概念:SoL-Pi 的 RSI,是什么,不是什么
“RSI Harness”听起来很科幻,所以先把边界说清楚。
SoL-Pi 是什么:
-
论文自述为“RSI 启发”(RSI-inspired)的方法,作用于 Harness 层,模型保持不变; -
一个 AI 研究 Agent 观察另一个 Agent 在基础 Harness 上的执行轨迹,提出并实现改动,再经过能力与效率两道门筛选; -
一个“混合式”闭环:人类提供早期先验、过滤低价值方向,循环一旦启动便无人干预,幸存者再由人类理解并重构为可维护的代码。
SoL-Pi 不是什么:
-
不是 Agent 在线运行时自己改自己; -
不是完全自治的 RSI。论文坦言,开放式循环中目标、证据与实现的漂移可能在人类察觉前就已累积,人类到底该在哪个环节介入,仍是开放问题; -
“递归高效改进”(用更高效的 Harness 降低下一轮研究成本)只是长期愿景,当前研究并未证明复利效应。
为便于理解,这里给一个笔者的归纳:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
SoL-Pi 当前形态 |
|
|
|
|
|
|
|
|
RSI Harness 的闭环与搜索引擎
闭环长什么样
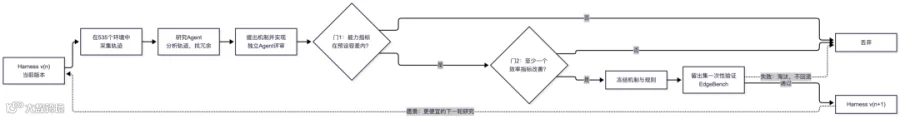
图中虚线回路“更便宜的下一轮研究”是论文提出的愿景(Recursive Efficient Improvement),并非已验证结论。
搜索引擎的四个关键设计
① 广度到深度的漏斗。
起点是 152 个候选方向,分属上下文、进度、工具、委派、提示与策略、改进与评估六大提案家族。在分配 rollout 预算之前,先用 Oracle Analysis 基于已有轨迹估算“可避免的工作量”,预筛一遍。
② 每个想法一条独立循环。
沿用 Karpathy 的 autoresearch 实验循环(提出、实现、运行、读结果、保留或丢弃),并做三处改造:实现用 Ralph Loop 迭代到明确退出条件;另一个 Agent 独立评审;多条轨迹用 Map-Reduce 分析,每个分析器只看一条轨迹,再由 Reducer 合并证据。
③ 两套隔离的数据。
535 个环境:495 个来自 GitHub Issue-PR 配对(还原到修复前,隐藏 PR 与回归测试,只保留“修复前失败、修复后通过”的),40 个是由可执行验证器驱动的合成任务。EdgeBench 的任务与验证器既不用于搜索,也不作为合成模板。EdgeBench 公开的 51 题中,11 题用于对冻结候选的一次性验收,其余 40 题用于最终泛化评估。
④ 一次性技能循环。
要同时跑上百个想法,编排本身是难题。团队试过三种方案:
|
|
|
|---|---|
|
|
|
|
|
|
| 一次性技能循环 |
|
规模化变成“重复实例化模板”,而不是“不断扩建协调器”。
最关键的护栏:能力底线
让 AI 省 Token,最容易的作弊方式就是:早点收工、跳过验证、删掉证据。
所以每个候选要过两道门:所有能力指标必须在预先声明的容差内;至少一个效率指标必须改善。这些指标与容差,对被优化的 Agent 来说不可见、不可改。留出结果更是绝不回流,失败就直接淘汰,不会被拿去“补丁式修复”。
四个幸存机制:Harness 循环的四个切口
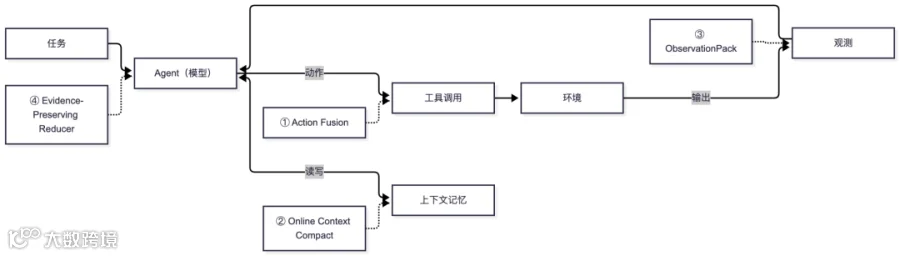
① Action Fusion:编辑加命令,一次搞定。
基础 Pi 常常先改文件,再单独发一条命令去测试。Oracle Analysis 估算这类相邻动作占跨轮转换的 12.3%。Action Fusion 把它们合成一次工具调用,API 调用从 3 次降到 2 次。需要先检查编辑结果的命令仍保持分开。
一个很有意思的细节:最初只靠提示词,触发率不稳定,研究 Agent 于是把融合动作直接写进工具 Schema,才得到零无效调用的稳定基线;它还自己发明了“触发率”这个中间指标,与任务得分一起指导优化。若所有 149 个候选都触发,轨迹推算可减少 10.8% 的模型轮次和 11.5% 的 Token(这是反事实估计,不是实测重跑)。
② Online Context Compact:在子任务边界上算账。
每当计划中的一步完成,就评估是否压缩:比较“节省的输入”与“重写缓存的额外成本”,回得了本才动手。后续压缩还要把未回收的成本算进去。
③ ObservationPack:大输出只发两次。
超过 10 KiB 的工具结果在本地归档,前两次请求完整发送,之后换成稳定句柄、原始大小和头尾摘录,需要时再按页取回原文。
④ Evidence-Preserving Reducer:便宜模型读日志,引用必须对得上。
对 ≥4 KiB 的构建与测试日志,由更便宜的模型(论文中为 GPT-5.6 Luna)生成紧凑回执,再由确定性验证器检查 Schema、源哈希、退出状态、逐字引用和大小;任一不过则回退原文。
单机制与组合(EdgeBench,GPT-5.6 Sol)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
47.2 |
| 完整 SoL-Pi | 1.0990 | $894 |
|
每个机制单独加入都降低了 Token;在 Opus 5 上,Action Fusion 得分最高(50.5,较 Pi 提升 12.8%)。还有个反直觉的现象:完整方案的缓存写入反而更多(0.0141B 涨到 0.0316B),但总成本仍从 894。不能只盯缓存命中率,要算整个任务的总账。
成绩单
EdgeBench
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
搜索只使用了 GPT-5.6 Sol 的轨迹,Opus 5 是从未见过的后端,SoL-Pi 零调整迁移过去。
换战场:Terminal-Bench 4 与 IMO 2026
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
要老实说:TB4 上 SoL-Pi 少解了 3 题,IMO 上 Codex 通过 5 题而 SoL-Pi 为 3 题。 它赢在“更便宜”,不是“更强”。
Agent 集群
在 Anthropic 的性能优化 take-home 上,1 个 Sol 协调者加 20 个 Luna 工人各跑 2 小时(起点 147,734 周期):
|
|
|
|
|---|---|---|
|
|
1,127 |
|
|
|
|
|
|
|
|
|
SoL-Pi 集群比 Pi 集群周期少 17.5%、成本低 26.8%;单 Agent 依然最便宜。每个配置仅跑一次。

给工程师:RSI Harness 搭建清单
把论文的做法抽象成可迁移的原则(以下是笔者的归纳):
-
先声明,再搜索。能力指标、容差、效率指标在搜索前固定,且对优化 Agent 不可见、不可改。 -
双门验收。先过能力底线,再看效率提升,最后在通过者中保留非支配解。 -
训练集与留出集物理隔离。留出集只在冻结后评估一次,失败即淘汰,绝不回流。 -
先量化机会,再花预算。用 Oracle Analysis 一类的预分析,估算想法的上限收益,再分配 rollout。 -
广度优先。论文观察到,模型迭代 5~10 轮后易陷入局部盆地;增加起始想法多样性才偶尔撞出突破,转化率约四十分之一。 -
编排即用即弃。用一份最小模板,复制、跑完、丢弃,别养一个不断膨胀的协调器。 -
人守两端。人提供先验、过滤低价值方向,并在幸存后审阅、重构代码。
验收门的最小示意(伪代码):
// 对优化 Agent 只读不可改:指标、容差都在搜索开始前冻结
function accept(candidate, baseline, floor, efficiencyMetrics) {
  const capabilityOk = floor.every(
    (m) => candidate[m.name] >= baseline[m.name] - m.tolerance
  );
  if (!capabilityOk) return false;                  // 门1:能力底线
  return efficiencyMetrics.some(
    (m) => candidate[m.name] < baseline[m.name]     // 门2:至少一项效率改善
  );
}
// 留出集:冻结后仅调用一次,结果不写回任何研究循环
想直接上手?SoL-Pi 已开源(MIT),是 Pi 的独立扩展,每个机制默认关闭:
npm install --global @earendil-works/pi-coding-agent@0.85.1
pi install git:github.com/NVlabs/SoL-Pi
官方推荐的保守配置,只开不额外调用模型的两个本地机制:
{
  "version": 1,
  "actionFusion": true,
  "observationPack": true,
  "evidencePreservingReducer": false,
  "onlineContextCompact": false,
  "cacheWriteReadRatio": 12.5
}
安全提示:Evidence-Preserving Reducer 可能把日志内容发给外部 Reducer 模型,需保留在本地的日志请勿启用;ObservationPack 的本地归档在会话结束后不会自动删除。
冷静看
-
得分有代价。完整方案只保留约 94% 的 Pi 得分;论文指出逐个机制放行的小损失,在组合后会累积。 -
搜索仅在单一后端。在 Opus 5 上机制触发率和强度更低,论文称迁移证据为“初步”。 -
样本小、多为单次运行。集群实验每组一次;ObservationPack 配对评估仅 11 题。 -
成本为 API 等价估算,按 2026 年 8 月 17 日标价计算。 -
作者团队自测,独立复现值得期待。 -
“递归高效改进”、“预训练 Harness”是愿景。论文没有证明复利效应或 Harness 的 Scaling Law。
写在最后
SoL-Pi 没有宣布“Agent 已经能无限自我进化”。它做了一件更朴素、也更可复制的事:用严格的隔离、预先声明的底线和一次性的编排,让 AI 在可审计的范围内改进自己的 Harness。
如果 RSI 真的会到来,那么能把“改进”约束成可验证、可回滚、不自欺的 Harness,大概率会比单个聪明的机制更重要。
参考资料:
-
项目博客:https://nvlabs.github.io/SoL-Pi/ -
论文(arXiv:2609.20519):https://arxiv.org/html/2609.20519v1 -
代码仓库:https://github.com/NVlabs/SoL-Pi
如果本文对你有所帮助,请帮忙点赞、推荐和转发 !
点击下面标题,阅读更多干货!
- Pi 1.0 炸场!OpenClaw 背后的 Agent 引擎,进化成了“杀不死”的 Harness
- “AI 正在用垃圾代码摧毁一切!”:Flask 之父对话 Pi 作者,揭开 AI 编程的残酷真相
- 悄悄用 Go 重写 AI 基础设施:NVIDIA 的 GPU 云平台为何选择 Go?
- 人类打造的最后一个AI?国内顶尖学者联合发文,把“AI自我进化RSI”拆成了五个等级
- AI 企业的新模式:Steve Yegge 提出 Counting House,让 AI 在严密护栏下接管千万级业务
- 大厨、厨房与餐馆:一文彻底搞懂 AI Agent 背后的“Harness”到底是什么
- 谷歌开源Harness²:不碰权重,让Agent学会了“自我进化”
🔥 还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
-
抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理 -
用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw -
构建坚不可摧的 Safety Middleware 与飞书人工审批防线 -
在底层实现 Token 成本审计、链路追踪与自动化跑分评估 -
从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码👇,开启从 0 开始构建Agent Harness 的实战之旅。