
今年上半年,AI圈有个明显的趋势:大家都在做记忆。
6月份,OpenAI把ChatGPT的记忆系统升级到了Dreaming V3版本,事实回忆准确率从41%提到了82%。8月份,Anthropic宣布Claude的记忆系统再次升级,将Chat和Cowork的记忆打通。
国内这边也没闲着,腾讯云开源了Agent Memory,华为发布了UCM推理记忆管理器,阿里云也在数据库产品线上密集布局记忆能力。行业似乎达成了一个共识:记忆是AI从"一次性工具"变成"长期伙伴"的关键。
但关键问题在于,AI记忆到底应该怎么做?
目前主流的方案是"外挂记忆"——模型本身还是那个无状态的大模型,只是在外面加了一层存储和检索系统。OpenAI的Dreaming V3本质上是在后台自动整理聊天历史,Claude的三层记忆架构也是在通用模型上叠加记忆层。
红熊AI走了一条不同的路。我们选择从预训练阶段就把记忆架构植入模型底层,让记忆成为AI的底层能力,而不是后期外挂的补丁。
这背后的路线之争,值得好好聊聊。
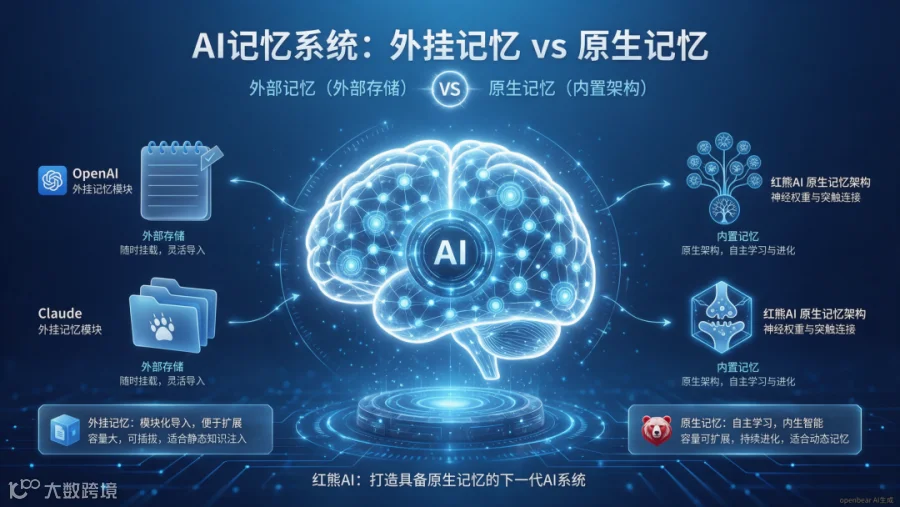
△AI记忆的路线之争
巨头们的记忆方案:聪明的"补丁"
先说说OpenAI和Claude是怎么做记忆的。
OpenAI的记忆系统迭代了三次:
2024年,他们推出了Safe Memories,用户需要手动保存偏好。
2025年4月,引入了Dreaming机制,系统可以自动筛选聊天历史中的相关信息。
到了2026年6月,Dreaming V3上线,这套系统可以在后台自动合成、处理冲突、感知时间,把零散的聊天整理成一份会随时间更新的个人档案。
具体来说,Dreaming V3会做三个动作:
❖第一,提取长期有效的信息,比如你的写作风格、项目目标、饮食禁忌;
❖第二,丢弃临时噪声,比如一次性查询、测试对话;
❖第三,遇到冲突时保留较新的说法,减少过期信息的误导。
但本质上,这套系统仍然是外挂记忆——模型本身是无状态的,靠外部系统存储和检索信息。模型回答问题时,先从外部记忆系统检索相关信息,把检索结果拼接到上下文中,再进行推理。记忆和推理是分离的,模型本身并不知道"自己记住了什么"。
Claude的方案也类似。Anthropic为Claude搭建了三层记忆架构:基础记忆管理对话上下文,项目记忆存储特定任务的背景知识,永久记忆保存用户偏好和长期事实。
但Claude的记忆同样是后期叠加的。在通用模型上增加记忆层,而非模型本身具备记忆能力。
这种外挂记忆方案的优势是快速上线、迭代灵活。毕竟不需要重新训练模型,只需要在外面加一层系统就行。但天花板也很明显。
外挂记忆四重困境:准确性、幻觉、成本、隐私
外挂记忆的问题或者说困境,主要体现在四重:
第一重:准确性
OpenAI官方数据显示,Dreaming V3的事实回忆准确率是82%。这意味着每5次回答,就有1次可能出错。问题出在哪里?检索偏差——关键词匹配可能召回不相关信息;上下文冲突——旧记忆和新信息打架,模型难以判断;时间感知弱——过期信息没有被及时降权。
第二重:幻觉
当记忆和推理分离时,模型容易产生幻觉。举个例子,用户三个月前说过"我喜欢吃素",但最近已经改变了饮食习惯。如果记忆系统没有及时更新,模型仍然会基于旧记忆推荐素食餐厅。这就是典型的基于错误记忆生成错误答案。
第三重:成本
外挂记忆需要双重消耗:检索成本——从外部数据库召回相关信息;推理成本——将检索结果拼接进上下文,再进行推理。OpenAI Dreaming V3虽然将算力成本降低了80%,但这是相对于旧版本而言。相比原生记忆架构,外挂记忆的成本仍然更高。
第四重:隐私争议
记忆越强大,隐私问题越突出。OpenAI Dreaming V3会自动整理用户的聊天历史,生成"个人档案"。虽然用户可以查看、编辑、删除记忆,但默认开启的机制让很多人感到不安。有人就问:我的AI记忆是资产,还是平台的附属品?
这些问题,本质上都是因为记忆和推理是分离的。模型本身不知道"自己记住了什么",只是在使用记忆。这就好比你在便签本上记了很多东西,每次回答问题前都要翻一遍便签。便签可能过时、丢失、互相矛盾,而你自己其实并不真正"理解"这些信息的意义。
红熊AI的选择:从底层重写记忆
当行业普遍选择"外挂记忆"时,红熊AI走了一条不同的路——从模型底层构建“原生记忆”。
红熊AI自研的OpenBear大模型,在预训练阶段就植入了原生记忆架构。这意味着模型能力与记忆能力在底层统一,模型本身"知道"自己记住了什么,记忆不是存储工具,而是认知管理系统。
技术路径上,红熊AI的MemoryBear记忆引擎采用五层类脑架构:接入层感知外部信息,组织层将信息拆解为实体、事件、关系并织成节点网络,调控层管理记忆的形成、更新、遗忘,检索层按任务复杂度动态调用,审计层追溯记忆来源确保可解释性。
这套体系有几个关键机制。
时间边界——记忆更新不是覆盖旧值,而是保留历史区间,让AI具备"时间感",理解同一件事在不同阶段可能意味着不同的东西。
自我反思引擎——对零散经历做压缩与归纳,把碎片化事实收敛合并,最终压缩认知并写回记忆库。
遗忘机制——从事件序列、关系变化、情绪线索、遗忘筛选四个维度梳理经历,让该降权的往后排,重要的才能凸显。
这里有个反常识的判断:会遗忘,才能形成稳定认知。什么都记住,反而等于什么都记不住。MemoryBear的遗忘机制经过精心设计,这与人类大脑的运作机制高度一致——遗忘不是缺陷,而是注意力调度机制。把不重要的往后排,重要的才能凸显出来。
结果如何?得益于原生记忆架构,MemoryBear在两项全球权威评测中表现突出:LongMemEval总分95%,LoCoMo总分91.54%,幻觉率控制在极低水平。这组数据刷新了AI记忆领域的SOTA,也验证了原生记忆架构的可行性。
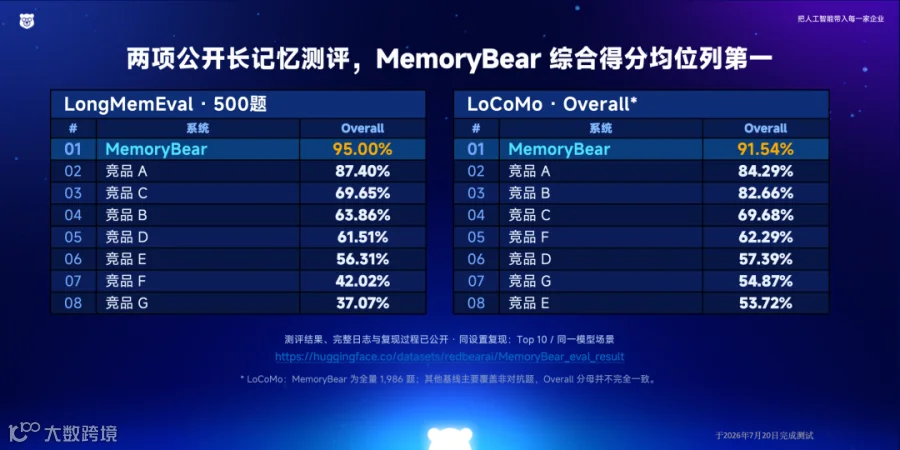
△Memorybear在两大记忆测评登顶

两种记忆模式的本质差异:便签本 vs 大脑
OpenAI、Claude的方案,本质是"便签本"模式。把重要信息写在便签上,贴在显眼位置,需要时翻看便签再回答问题。这种模式简单、灵活,但天花板很明显——模型本身没有"理解"记忆,只是在使用记忆。
红熊AI的方案,本质是"大脑"模式。记忆不是存储,而是认知的一部分。模型本身"理解"记忆,能够主动调用、更新、遗忘。记忆会演化,随时间形成稳定的认知。这种模式准确、高效、可解释,但开发难度也更大——需要从预训练阶段就植入记忆架构。
红熊AI的选择,基于一个核心判断:记忆不是附加功能,是AI的底层能力。
当行业还在比拼参数规模时,红熊AI已经把"记忆"做成AI的底层能力。这不是技术路线的选择,而是对AI本质的理解——真正的智能,不只是推理能力,还包括从经验中学习、持续进化的能力。
记忆终局:从个人记忆到数字认知体
AI记忆技术的发展图谱已经清晰。
第一阶段是形成稳定、准确、可追溯的个人记忆,这是当前阶段。
第二阶段是实现跨Agent、跨场景的认知共享。
第三阶段是构建持续演化的"数字认知体",让AI不只是记得住,更能学习、成长、演化。
在这个图谱中,外挂记忆和原生记忆并非完全对立。短期内,外挂记忆因其灵活性仍将是主流。但长期看,原生记忆架构将成为AI认知系统的标配。

红熊AI的选择,等于是提前押注了记忆终局。
当行业还在比拼参数规模时,红熊AI已经把"记忆"做成了AI的底层能力——让AI不只是记得住,更能学习、成长、演化,成为与人类一同进步的"数字伙伴"。
这或许才是AI真正改变世界的起点。