

Hugging Face 的 Sergio Paniego 在这篇文章里,梳理了蒸馏如何从“把模型变小”走向迁移推理能力,以及它为何成为前沿模型后训练的一部分, 以下为全文翻译。

这是“训练一个 Agent”系列第 2 课的预热文章。那堂课里,我们会用 TRL 蒸馏开放模型。在此之前,先来回顾一段简史。
蒸馏是后训练领域的热门话题,它也是让小模型变得出奇好用的最有力工具之一。
你可能早就在开放模型中见过蒸馏,只是没有注意到。还记得 DeepSeek-R1-Distill-Qwen-7B 这样的名字吗?下面就来简要讲讲它背后的故事。
最初是为了压缩
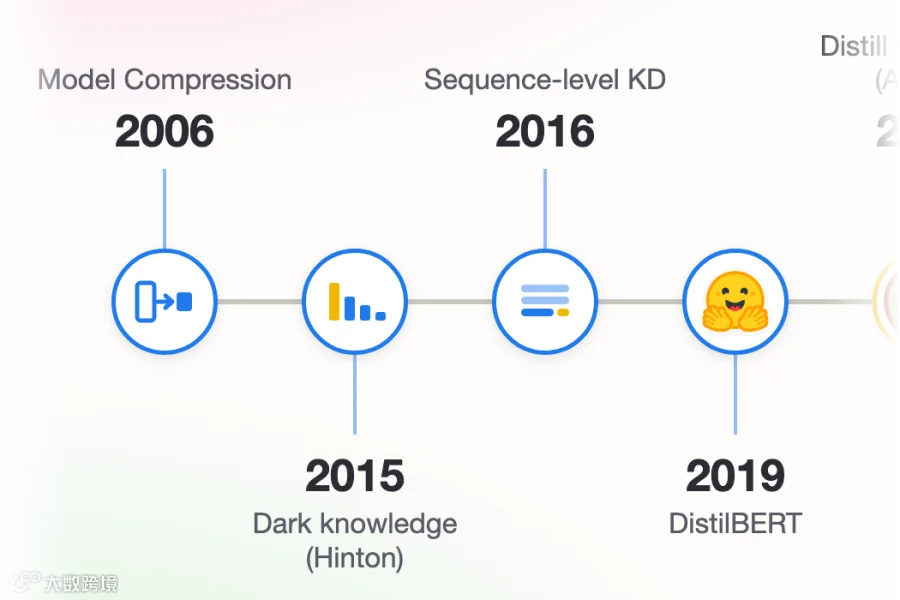
模型压缩阶段:2006 年的模型压缩、2015 年的暗知识、2016 年的序列级知识蒸馏,以及 2019 年的 DistilBERT。
2006 年,Bucilă、Caruana 和 Niculescu-Mizil 在《模型压缩》(Model Compression)中提出:训练一个小模型,让它复现一个庞大、缓慢模型的预测。行为一样,成本却只要原来的一小部分。没有增加新能力,只是得到一个更便宜的模型。
不出所料,Schmidhuber 也出现在了这段历史里:他表示,自己早在 1991 年就率先做到了。
2015 年,Hinton、Vinyals 和 Dean 的《蒸馏神经网络中的知识》(Distilling the Knowledge in a Neural Network)让这个想法真正流行起来。这就是教师—学生框架:一个大教师,带一个小学生。学生不再只学习单一的硬标签,而是学习教师经过温度参数软化后的完整概率分布。哪些其他选项也有可能、它们彼此有多接近,这些额外信号就是“暗知识”(dark knowledge),也正是学生能从教师那里学到比原始数据更多东西的原因。
此后,蒸馏悄然扩散。它进入了计算机视觉领域,出现了 FitNets、注意力迁移等方法,也进入了 NLP。2019 年的 DistilBERT 在体积缩小 40% 的同时,保留了 BERT 的大部分表现,让数百万人用上了蒸馏模型。在将近十年的时间里,蒸馏意味着一件事:把已有模型变得更小、更快。
教师变成了大语言模型:从压缩到迁移
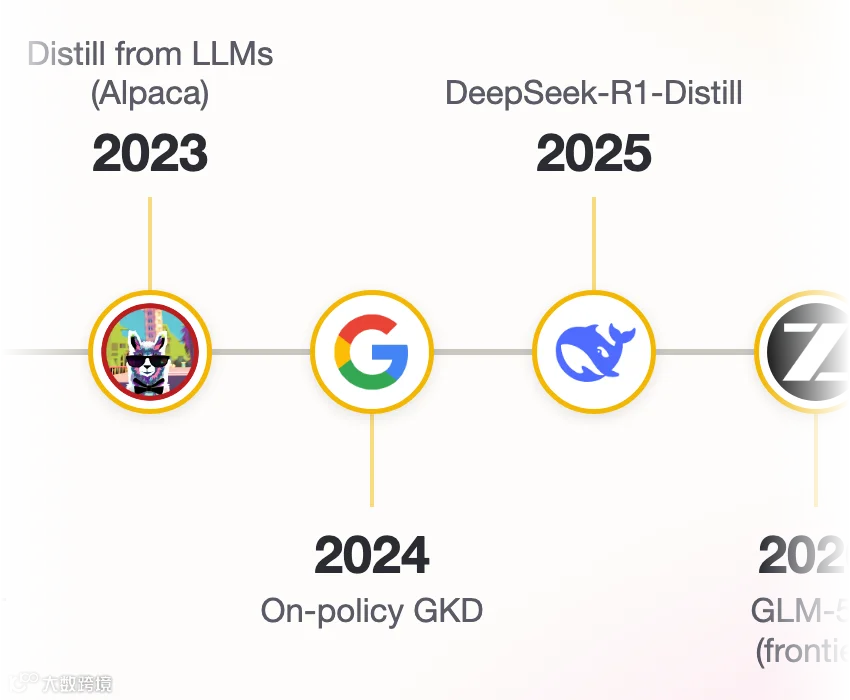
从压缩到迁移:Alpaca、同策略 GKD 与 DeepSeek-R1-Distill。
到了 2023 年左右,目标变了,教师也变成了大语言模型。有了可以调用的强大指令模型,你训练小模型的目的不再是压缩一个已有模型,而是让它学会自己原本不具备的行为。Alpaca 和 Self-Instruct 只花几百美元,就从更大模型生成的文本中迁移出了能力。蒸馏的重点从压缩转向了迁移。
最引人注目的例子是 2025 年的 DeepSeek-R1-Distill。团队没有从零训练一个巨大的推理模型,而是把强教师模型的推理轨迹蒸馏给紧凑的 Qwen 和 Llama 学生模型,再开放发布。一个小模型,加上一位好老师,突然就能推理了。这正是文章开头提到的那个模型。
如今也用于前沿模型的后训练
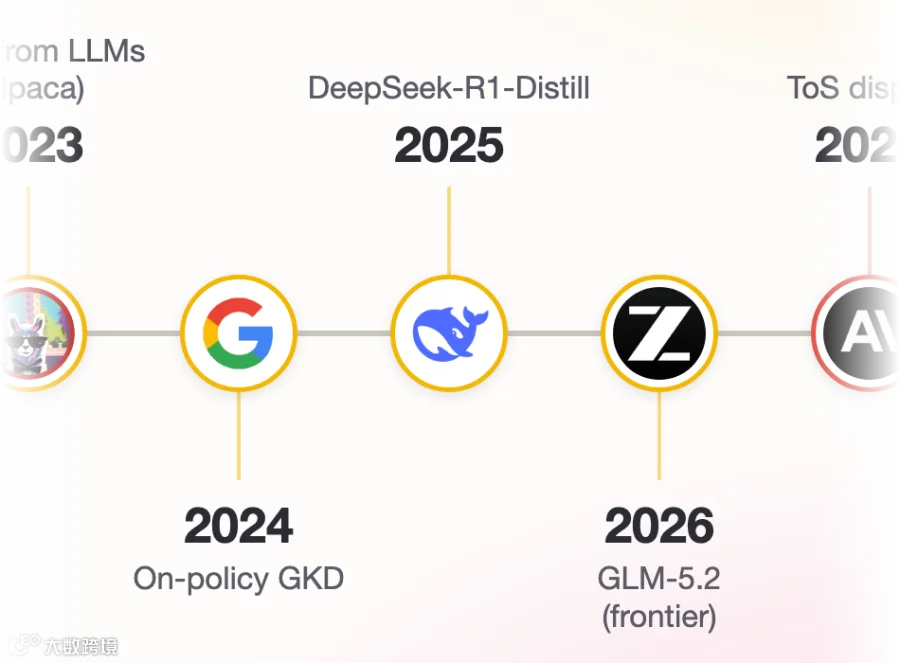
前沿模型也使用蒸馏:从同策略 GKD 到 DeepSeek-R1-Distill 和 GLM-5.2。
蒸馏并没有停留在小模型的捷径上。在前沿模型中,它如今采用同策略蒸馏(on-policy distillation)的形式:学生自己生成,能力更强的教师为学生生成的 Token 打分,让它学会纠正自己实际犯下的错误。GLM-5.2 在后训练中使用了它,Qwen3 也依靠蒸馏,而蒸馏、监督微调、强化学习和合成数据之间的界限正变得模糊。它们越来越像是同一条后训练流水线的不同叫法。Hugging Face 的开源后训练库 TRL 以 GKD(Agarwal 等,2024)的形式实现了同策略蒸馏;MiniLLM(Gu 等,2023)则提供了采用反向 KL 散度的变体。
因此,整段历史可以看作目标的一次次扩大:从 2006 年压缩模型,到让模型更快,再到复制另一个模型的行为,如今则要迁移它的推理能力。机制还是那个机制,目标却越来越大。
最近的争议

蒸馏的服务条款争议。
蒸馏也处在一场仍在持续的争议中心。今年,Anthropic 指控多家实验室,包括 DeepSeek、Moonshot、MiniMax,以及最近的阿里巴巴,通过大量账号对 Claude 的输出进行规模化蒸馏,并称这违反了其服务条款,相关内容见 Anthropic 的说明和 CNBC 的报道。OpenAI 也作出过类似表态。由于模型输出在美国不受版权保护,这场争论围绕的是服务条款和访问权限,而不是版权。
回到蒸馏的历史,结论很简单:从更强模型的输出中学习,既是构建开放模型的一种方式,也是这些争执的核心。授权和访问方式,决定了它是一种工具,还是一次攻击。
这些方法都是开放的
这段历史中的核心技术,从 logits 蒸馏到前沿模型使用的同策略蒸馏,都已经在 TRL 中实现。你不需要拥有前沿实验室的基础设施,也能亲手尝试。
这就是第 2 课的内容。我们会继续训练自己的小型编程 Agent:软标签、离策略与同策略蒸馏、自蒸馏,以及用 TRL 动手编写代码、完成实际案例。到时见,详情见 Ben 的预告。
参考链接
-
原文:https://huggingface.co/blog/sergiopaniego/brief-history-of-distillation-in-ai -
GLM-5 技术报告:https://huggingface.co/papers/2602.15763 -
Anthropic:检测和防范蒸馏攻击:https://www.anthropic.com/news/detecting-and-preventing-distillation-attacks -
DeepSeek-R1-Distill-Qwen-7B:https://huggingface.co/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B -
Ben 的蒸馏课程预告:https://x.com/ben_burtenshaw/status/2071597423843999807 -
Schmidhuber:谁最早提出神经网络知识蒸馏:https://people.idsia.ch/~juergen/who-invented-knowledge-distillation-with-neural-networks.html -
蒸馏神经网络中的知识:https://huggingface.co/papers/1503.02531 -
DistilBERT:https://huggingface.co/distilbert/distilbert-base-uncased -
Stanford Alpaca:https://crfm.stanford.edu/2023/03/13/alpaca.html -
Self-Instruct:https://huggingface.co/papers/2212.10560 -
DeepSeek-R1 论文:https://huggingface.co/papers/2501.12948 -
Qwen3 技术报告:https://huggingface.co/papers/2505.09388 -
TRL 文档:https://huggingface.co/docs/trl -
GKD Trainer 文档:https://huggingface.co/docs/trl/gkd_trainer -
同策略蒸馏:从自身生成的错误中学习:https://huggingface.co/papers/2306.13649 -
MiniLLM Trainer 文档:https://huggingface.co/docs/trl/minillm_trainer -
大语言模型的知识蒸馏:https://huggingface.co/papers/2306.08543 -
CNBC 关于 Anthropic 与阿里巴巴蒸馏争议的报道:https://www.cnbc.com/2026/06/24/anthropic-alibaba-distillation-campaign.html