


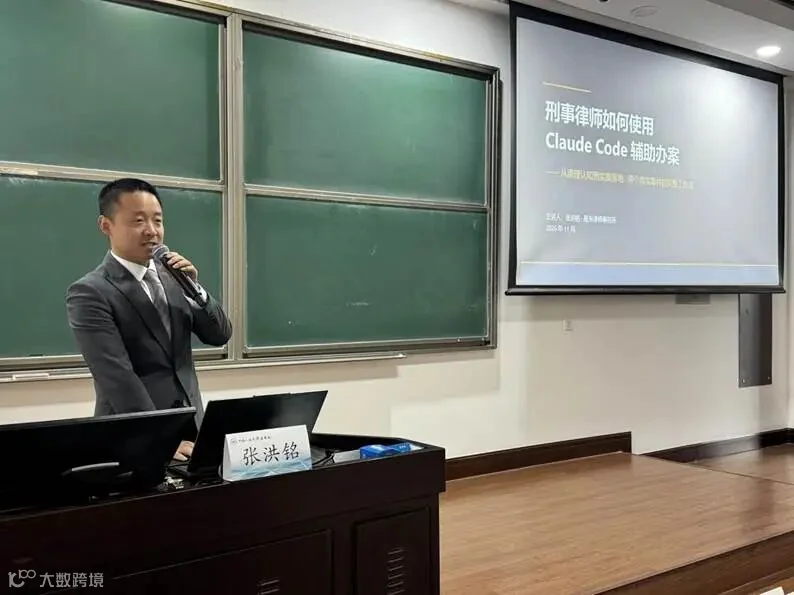
10月31日上午上半场,张洪铭律师作为主讲人,以“刑事律师如何使用Claude Code”为题,面向学员分享人工智能在刑事法律服务场景下的落地方法、实操流程与合规风控要点。
张洪铭律师首先梳理AI基础认知,厘清大模型的本质特性。他指出,大模型本质是“下一个词预测器”,依托统计归纳机制生成文本,并不具备真正的自主思考与逻辑推理能力,天然存在幻觉风险。面向法律实务场景,律师落地AI工具的优先路径为提示词工程、检索增强生成(RAG),模型微调可作为补充,普通刑事律师无需尝试从零训练大模型。针对本次课程核心工具Claude Code,张律师介绍它属于命令行Agent智能体,支持读写本地文件,可灵活切换云端、本地模型;依托“CLAUDE.md”、技能库,律师能够沉淀固化办案准则、标准化办案流程。围绕数据安全与模型选型,张洪铭律师对比了云端模型与本地模型的适用边界。云端大模型综合能力更强,但将案卷材料上传云端,等同于向第三方披露案件信息,极易引发保密违规、数据出境等执业风险。他建议,涉及涉密、敏感案卷材料,优先采用Ollama+通义千问(Qwen)本地模型部署方案,保障全部数据留存在本机。同时,张律师提出信息分级管理、案卷材料脱敏处理、优先本地部署方案、核查服务商数据政策、人工核验AI输出内容是AI刑事办案风险控制“五道闸”。针对行业普遍关心的AI幻觉治理问题,张洪铭律师介绍了防幻觉九步法,包括构建本地知识库(RAG)、工具调用读取真实文件、仅使用原材料投喂、明确禁止模型编造事实、强制要求输出内容标注原始出处、调低模型温度参数、多轮交叉验证结果、使用更强的模型以及人工核验。他强调,人工核验是风险兜底最重要的一环,还可以将防幻觉刚性要求写入“CLAUDE.md”全局规则,固化为AI办案的硬性技能,从机制上减少虚假信息生成。在提示词协作方法论上,张律师基于“人搭骨架、AI填血肉”协作原则,提出提示词包括角色定位、核心任务、案件上下文、指定输出格式、约束边界、参考示例六大要素,可广泛应用于证据摘录、辩护意见撰写、案件时间线梳理、庭审发问提纲草拟等工作。
最后,张洪铭律师结合两起真实刑事案件完整演示AI办案全流程。在某诈骗案中,AI可高效完成大批量证据摘录、快速生成法律文书初稿;同时对比发现本地模型输出内容容易趋于模板化,经过脱敏处理的案件材料,使用云端模型处理效果更佳。在某走私毒品案中,借助Claude Code解析SQLite电子数据库,成功挖掘出电子数据存在选择性删除、证据保管链断裂的关键疑点。他着重提醒道,AI在分析过程中曾输出错误结论,依靠多轮校验才完成修正,AI生成的结果绝对不能直接采信作为办案依据。
张洪铭律师总结道,人工智能可以大幅压缩重复性事务工时,显著提升刑事律师办案效率,但它始终只是高效辅助工具。案件的价值判断、法律取舍、辩护策略等核心决策不可交由AI完成,律师独立的专业判断,才是刑事辩护不可替代的上限与执业底线。
10月31日上午下半场,北京国盾信息中心司法鉴定所鉴定人张佩军带来题为“人工智能时代的电子证据审查—真实性判断案例解析”的专题授课,面向参训司法实务人员分享电子证据鉴伪思路、实操方法与典型疑难案例。张老师指出,生成式人工智能的迅猛发展,正在深刻改变证据造假的方式。电子证据伪造已从专业技术活变成普通民众可操作的工具活。伪造产出的聊天截图、短信记录内容通顺、外观逼真,仅凭肉眼阅读内容已经很难识别虚假证据。他强调,“AI降低了造假的门槛,但也放大了造假的痕迹”,电子证据审查必须从“看结论”转向“看过程”。
张老师结合两个真实案例,完整演示了电子证据真实性审查的方法论。在首个刑事案件中,代理律师二审前提交的一部手机里有16条关键短信,最终经鉴定全部系伪造。张老师从短信数据库的21个字段入手,逐项揭示破绽。网络类型字段为0、发送时间精确落在每分钟第55秒、毫秒位全为零、生产者字段指向一款“模拟来电短信”应用、短信中心号码为空等,条条痕迹指向程序批量生成的真相。第二个案例聚焦民间借贷纠纷中的微信记录冲突:针对同一笔借贷事实,原被告双方手机内留存的微信聊天记录内容不一致。前期受托鉴定机构仅检索微信FTS快速索引库,据此出具聊天记录完整的鉴定意见。张老师则对微信原始数据库开展解析,结合哈希表名称规则、消息本地ID自增逻辑,对照消息撤回、删除行为对应的底层数据特征综合研判,最终证实其中一方手机并未主动删除相关聊天记录,得出和原有鉴定意见截然相反的结论。

张老师总结道,内容会骗人,数据不骗人;单点的异常是线索,系统的矛盾是结论。他提醒,审查鉴定意见不能止步于看结论是否规范、机构是否具备资质,而要追问结论形成的依据是否充分。他也谈到,AI助手正在进入证据审查的工作流程,可以辅助挖掘线索、整理笔录,但“判断力是AI做不到的”,唯有把工具与专业知识结合,才能真正提升审查能力。
随后的交流环节,学员围绕如何初步识别微信记录真伪、录音与视频的鉴伪、PC版与网页版微信鉴定可行性、数据恢复等实务问题踊跃提问,张老师逐一解答,并特别提示不同取证厂商、取证软件的技术能力参差不齐,输出的取证报告存在差异。建议办案过程中同步备份原始数据文件,连同取证材料一并刻盘封存移交,为后续复核、深度分析留存基础条件。
10月31日下午上半场,中国科学院软件所邓昌智博士作为主讲人,以“资金电子证据智能审查技术及运用”为主题,围绕人工智能时代资金电子证据审查的前沿技术、理论框架与办案实践,为参训学员带来一场技术与法律深度融合的专业分享。
邓老师首先直面当前司法办案痛点。他谈到在诈骗、洗钱、贪污贿赂、非法集资等案件办理中,涉案资金流水常常达到数万乃至数十万条,账户层级交错、支付渠道繁杂、资金转移隐蔽迅速。依靠人工逐笔核对的传统 “人海战术”,不仅效率低下,还极易遗漏关键交易节点,难以实现对资金链路的完整核查。依托数据建模、资金图谱构建、交易异常检测等智能化手段,能够帮助办案人员从繁重的流水核对工作中解放出来,将工作重心回归证据审查与法律判断本身。邓老师梳理了资金电子证据分析演进中资金数据电子化、资金数据分析智能化、资金电子数据证据化、资金分析报告证据化四阶段,重点阐释了2023年提出的“金析为证”理念,通过配套制度制定、标准发布、专业鉴定机构建设与专职资金分析鉴定人才培养,推动资金分析工作实现了证据性质之变、质证对象之变、审查思维之变的三重变革,打通资金分析成果从线索材料到法定证据的转化路径。
在技术原理讲解环节,邓老师解析金融网络的底层架构,厘清账户基础关系,提出“客户是根,账户是资金载体,卡、存折是访问工具”的核心判断。他介绍,资金数据属于结构化与非结构化混合数据,具备客观真实性、多元性、留痕性、多源性等特征,资金证据审查需要牢牢抓住“入金—沉淀—转移—变现”四大关键环节,追踪账户流转痕迹。讲座围绕资金穿透、关联网络、时序分析三大核心概念,介绍数据层、治理层、算法层、应用层四层技术架构,以及图计算与知识图谱、规则引擎、机器学习异常检测、大数据碰撞比对四项核心技术能力,并归纳快进快出、分散转入集中转出、集中转入分散转出、循环转账、公转私与公私混同等典型异常资金交易模式。
随后,邓老师完整讲解资金证据获取、清洗、分析鉴定、鉴定文书撰写全流程。针对鉴定证据审查要点,他逐一说明资金数据获取审查、数据清洗审查、分析结果审查、分析方法审查的核查标准,强调办案中需要核验鉴定事项是否清晰、材料来源是否合规、数据处理规则是否明确、结论是否限定于资金事实范围,守住资金分析鉴定的规范性边界。结合非法集资、电信网络诈骗、职务侵占等真实办案案例,邓昌智博士展示智能审查系统在资金电子证据研判中的实战价值,让学员直观感受数字技术为经济犯罪证据审查带来的效能提升。

本次授课紧扣数字司法发展趋势,打通技术原理、规范标准与办案实务,帮助学员系统掌握资金电子证据智能审查体系,深化对“金析为证”制度内涵的理解,为后续运用智能技术开展资金证据核查、提升复杂经济案件办理质效夯实理论与技术基础。
10月31日下午下半场,中国人民大学信息学院梁彬教授为学员带来“人工智能安全”为题专题授课,围绕深度学习对抗攻击、文本模型安全、量化模型风险、DeepFake换脸、大模型与智能Agent安全等多个前沿方向,介绍当前人工智能技术面临的各类安全威胁,分享团队在AI攻防领域的系列研究成果。
梁教授提出,新技术快速普及的同时也成为网络攻击的重点目标,对抗样本成为AI安全最典型威胁包括攻击者向原始输入叠加人眼难以察觉的微小扰动,即可误导人工智能模型输出错误结果,也就是绕开攻击。梁教授以经典熊猫图像被扰动识别为长臂猿,以及物理世界交通标志牌被篡改、人脸识别遭伪装欺骗等实例,直观展示对抗样本的现实危害。在自动驾驶场景下,经过修改的交通标识,会直接误导车载视觉识别系统,带来交通安全隐患;人脸识别场景中,特殊设计的眼镜配饰,能够欺骗识别系统,带来身份认证风险。
针对图像深度学习模型,梁教授以通俗易懂的方式地介绍了DNN模型,以及白盒经典攻击算法FGSM、迭代式I‑FGSM攻击的技术原理。FGSM利用模型梯度信息,沿着梯度上升方向添加扰动实现模型欺骗;迭代版本I‑FGSM通过多步小幅扰动,实现更加精准高效攻击,并且能够适配真实物理世界场景。他提出基于自适应降噪的对抗样本检测方案,利用图像熵自适应调整滤波力度,结合标量量化、空间平滑,通过比对原始输入与降噪后输入的分类结果识别对抗样本,在多组数据集与攻击算法下取得良好检测效果。随后,梁教授介绍了文本对抗样本两大核心约束,即既要保证文本语义基本通顺可用,又要做到人为难以察觉。梁教授提出面向字符级、单词级文本分类模型,开展白盒与黑盒攻击研究,提出热字符、热训练短语HTP、热样本短语HSP等核心概念,通过插入、修改、删除三类策略构造文本对抗样本。仅仅插入少量关键短语,就能够篡改文本分类结果;通过形近字符拼写修改,在保留文本可读性前提下实现模型欺骗。梁教授还剖析了现实中面向产业广泛部署的量化AI模型的风险。很多手机、浏览器为了跑AI更快,会使用轻量化的量化模型。研究发现,通过技术手段修改网页画面,做出肉眼很难察觉的细微痕迹,就有可能骗过浏览器AI,让危险钓鱼网站不被拦截。同时,梁教授还拓展介绍多类新兴安全风险,包括面向目标检测的对抗补丁攻击、DeepFake换脸伪造带来的音视频造假威胁。当前LLM大语言模型、AI Agent智能体等快速兴起,也带来提示注入、多模态对抗样本、智能体越权执行等全新安全难题。

文稿:陈 婕
摄影:卢守康