


10 个关键问题 Q&A
-
Q:Chrysalis 和普通 AI Agent 最大区别是什么? A:普通 Agent 按预设提示词、工具运行;Chrysalis 能在管控下合成工具、沉淀运维规则、修改自身多智能体拓扑,实现结构层面的自我演进。 -
Q:三层协同进化分别解决什么问题? A:L1 快速止血、L2 沉淀经验避免重复踩坑、L3 长期优化 Agent 组织架构,适配未来同类故障。 -
Q:Shapley 归因在这里起到什么作用? A:故障时多动作叠加,用来区分哪一步修复有效、哪一步带来次生损害,避免误判。 -
Q:什么是反事实仿真? A:基于历史流量轨迹离线批量测试多套策略,不用在线上试错,找到最优限流 / 调度策略。 -
Q:它的安全管控链条由哪几部分组成? A:输入净化 + AST 沙盒、KMS 密码签名、OPA 策略、双人共管 HITL 四层纵深防御。 -
Q:为什么拓扑修改只在内存 DAG 完成、不改容器镜像? A:容器镜像不可变,磁盘修改需要重启;内存 DAG 更新实现零停机、不破坏容器完整性。 -
Q:Anthropic Claude Agent 为什么不做这类自演进? A:Claude 设计优先安全对齐,刻意限制 Agent 自主生成、挂载可执行代码与修改自身流程。 -
Q:国内云 Agent 普遍缺少哪些核心能力? A:缺少工具自合成、Shapley 因果归因、代码制品密码签名、动态拓扑自重构原生能力。 -
Q:Chrysalis 可以直接上线生产使用吗? A:不可以,它是谷歌研究参考原型,不是正式商用产品,适合架构思路参考。 -
Q:它最适合、最不适合什么场景? A:适合高价值云基础设施故障自愈;不适合通用对话、客服、普通办公自动化场景 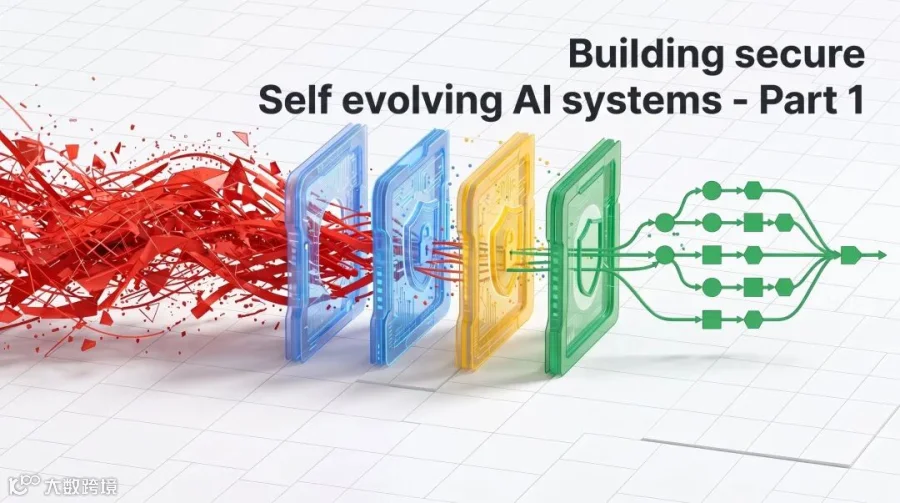
发布时间:2026 年 10 月 22 日
作者:Anant Nawalgaria,集团产品经理 & AI 工程师来源:Google 开发者博客
自我演进式 AI 的兴起
企业云平台需要支撑数百万并发用户,紧耦合的微服务会引发连锁故障,这类故障是任何静态运维手册、阈值告警都无法预判的。在黑色星期五闪购这类高流量场景下,站点可靠性工程师(SRE)面临残酷现实:必须在数秒内从嘈杂的分布式遥测数据中定位根因,否则连锁宕机造成的损失可达每分钟数百万美元。
生成式 AI 副驾工具已经加快了代码编写、日志汇总的效率,但 AI 智能体依然很难可靠地处置线上生产故障。一名值班工程师正在应对连接池耗尽问题时,他不需要 AI 只给出排查建议,或是一份未经验证、未必能解决根因的 PR(代码合并请求);他需要一套受管控、可自我演进的 AI 系统,具备如下能力:
-
实时跨缓存、数据库层诊断分布式故障根因 -
自主合成、验证缓解工具,并即时挂载至线上服务中间件,完成自修复 -
自我复盘评估:计算每一步动作的边际贡献,区分有效修复与有害的本能操作 -
沉淀记忆:将经过密码签名的运维不变规则存入语义记忆,降低同类故障复发概率 -
架构自重构:在获得人工审批后,在内存中动态调整自身多智能体层级结构,应对未来流量洪峰
这套范式,就是自我演进式 AI(Self-Evolving AI)。
在这套 Google Cloud 研究参考架构(代号:Chrysalis 项目)中,谷歌展示了三项核心研究突破如何融合成一套可投产的统一架构,可基于 Gemini 平台与 Agent Development Kit(ADK)运行。在模拟黑色星期五缓存雪崩故障场景下,这套带管控的架构,将首次故障处置耗时从 15–45 分钟缩短至 1.8 秒;HTTP 5xx 错误率从 72.7%~80.0% 降至 0.0%;P99 延迟从 519.8ms 下降至 18.2ms;同时可在 BigQuery 中对 400 套流量策略做反事实推演评估,单次推演仅约 0.5 毫秒。
关键一点:这套自我演进架构并非不受约束的 “黑盒”。为保证智能体安全、可靠、对齐、杜绝失控行为,所有自主动作都由 Google Cloud 纵深安全体系做密码级约束:
-
Model Armor:清洗遥测数据,防范提示注入、数据泄露; -
云密钥管理 KMS + 二进制授权中间件:对合成的修复补丁签名,拦截未验签代码; -
Open Policy Agent(OPA)策略控制器:强制执行 SLA 防护规则,避免 AI 自我引发故障; -
双人共管的人在回路(HITL)管控:对智能体结构做永久性变更前,必须由 SRE 明确审批。
1. 故障场景:黑色星期五缓存雪崩,为什么智能体必须具备自我演进能力
静态预案、辅助型 AI 副驾在高压场景下会失效,我们来看典型分布式连锁故障:
-
入口流量冲击:闪促活动带来大量并发下单请求,访问冷库存键; -
缓存淘汰:Memorystore(Redis)遵循 LRU 策略淘汰冷键,缓存命中率直接归零; -
连接池耗尽:未命中缓存的流量全部压向 Cloud SQL。PostgreSQL 连接池打满后,查询排队超时,服务大面积抛出 500 错误; -
致命的 “凌晨三点本能操作”:在运维高压下,人工工程师、基础大模型都会下意识重启数据库连接池。在流量雪崩时,强行断开连接会锁死数据库内核,长尾延迟飙升近十倍,最终演变为全量宕机。
自我演进智能体的持续适配逻辑
传统 AI 智能体在部署后,系统提示词、可用工具都是固定写死的。遇到全新基础设施瓶颈时,自我演进 AI 架构可以在运行时生成适配当前场景的处置工具,评估每一次干预带来的遥测指标变化,并沉淀可验证的防护规则用于后续故障处置。真正具备自主韧性的系统,必须基于真实结果(哪些操作有效、哪些有害)持续进化:
-
自主自修复(工具合成):智能体诊断出数据库耗尽来自无限流的入口流量,而自身没有内置流量整形工具 → 实时编写内存版令牌桶限流器中间件,校验抽象语法树 AST,通过 Cloud KMS 签名,热加载到 API 网关; -
因果式自我复盘(区分有效 / 无效动作):故障稳定后,智能体对比干预前后指标变化做评估。对 “重启数据库” 这类拉高延迟的动作打负分,对令牌桶限流这个消除报错的动作给予正向贡献分; -
认知记忆 + 组织架构自重构:将一条带签名的运维规则存入向量记忆:缓存雪崩场景禁止重启数据库。接着在内存里修改多智能体 DAG 拓扑,在主管智能体下新增常驻的流量整形专职智能体,后续流量洪峰在抵达数据库前就被治理。
2. 自我演进 AI 的三大研究支柱
面向云场景的自我演进智能体是前沿应用研究方向,目标是解决SRE 三难问题:在探索安全性、结构可适应性、多步骤贡献归因三者之间取得平衡。Google Cloud 将三项研究成果整合为三大支柱:
-
无服务器反事实仿真(论文:https://arxiv.org/abs/2609.14858)
- 挑战:在线上生产直接测试未验证限流参数,可能误拦截正常业务流量、再次触发宕机;
- 机制:生产请求轨迹导入 BigQuery,引擎在向量化内存中毫秒级回放数百套令牌桶配置,离线找出帕累托最优策略。 -
三层协同进化(论文:https://arxiv.org/abs/2606.15363)
- 挑战:仅调提示词很脆弱,无约束代码自修改会引发系统不稳定;
- 机制:智能体进化拆分为三条受管控的时间线:
- 第一层:临时热补丁。生成并挂载内存中间件工具,秒级遏制正在发生的故障;
- 第二层:规则沉淀。把 KMS 签名后的经验存入 Agent Platform 向量检索,后续告警自动拦截高危动作;
- 第三层:拓扑重构。在多智能体有向无环图 DAG 中新增常驻专职子智能体。 -
步骤级 Shapley 归因(论文:https://arxiv.org/abs/2511.10395)
- 挑战:故障中多轮干预顺序执行,只看最终结果无法定位哪一步修复了服务、哪一步带来次生损害;
- 机制:AgentEvolver 基于干预前后遥测差值(P99 延迟、5xx 错误率、数据库连接池占用),为每一段执行链路计算 Shapley 边际贡献,区分有效补丁和错误操作。
3. 四阶段参考演示:自我演进完整闭环
谷歌在 Gemini 平台上开放了交互式演示应用:
https://github.com/GoogleCloudPlatform/generative-ai/tree/main/agents/self-evolving-ai
整个闭环链路包含:业务目标服务、ADK 多智能体平面、自我演进引擎、纵深管控流水线。
阶段 1:入口故障 & SRE 基准场景
-
过程:5 次请求预热基线后,50 并发闪购流量冲击 15 个冷库存 Key; -
指标:Memorystore 命中率从 100% 跌到 0,Cloud SQL 连接池 100% 占满,P99 延迟飙升至 312.8–519.8ms,HTTP 500 错误 72.7%–80.0%(40 次下单失败)。
阶段 2:ADK 快速研判 + 受管控 APEX 第一层热补丁
-
过程:遥测告警触发由 Gemini 4 Argon 驱动的 Agent Platform 主管路由智能体;告警载荷先经过 Model Armor 检测,阻断提示注入; -
自主热修复:诊断连接池耗尽后,APEX 第一层热补丁合成器生成内存令牌桶限流器(容量 10token,填充速率 40req/s)。挂载到 API 网关前,补丁必须通过三道自动化管控关卡: -
AST 沙盒遍历器:禁止非法系统调用、危险动态执行入口; -
OPA 策略控制器:校验限流速率满足企业 SLA 底线(≥10req/s); -
Cloud KMS + 二进制授权:对制品摘要做 EC_SIGN_P256_SHA256 签名,在中间件边界校验密钥来源; -
指标:第二轮 50 并发流量下,HTTP 500 错误归零,连接池占用清零,P99 延迟恢复至 18.2ms;突增流量通过 429 限流释放,10 个请求从预热缓存正常返回。
阶段 3:AgentEvolver 归因 + 二层人审,内存拓扑重构
-
过程:AgentEvolver 贡献归因引擎复盘执行链路,给 “重启数据库” 操作负向扣分(该操作把延迟拉到 3800ms),令牌桶补丁贡献分 + 0.97; -
规则沉淀:APEX 第二层规则蒸馏器将一条不可篡改、带签名的运维规则写入 Vertex AI 向量检索:缓存雪崩场景:禁止重启数据库;优先使用令牌桶削峰限流; -
双人共管审批:系统提出结构性变更方案 —— 新增常驻流量整形专职智能体。流程暂停,弹窗等待值班 SRE 双人审批; -
ADK 内存 DAG 改写:
GKE、Cloud Run 中容器镜像不可变,故障时修改磁盘源码会破坏容器完整性、需要重启。在拿到人工审批的密码令牌后,APEX 第三层云拓扑适配器只在内存更新 DAG: -
在内存实例化流量整形专职智能体,配套限流、队列深度观测、令牌生成工具; -
将该专职智能体作为并行节点,挂载在主管路由智能体的子图里,和诊断智能体并列,不改动原有诊断节点; -
更新主管路由指令,在内存重新绑定 ADK 运行器,零停机、无需重启容器。
阶段 4:BigQuery 反事实回放 & 混沌验证
-
过程:故障请求轨迹流入 BigQuery,反事实回放引擎遍历 400 组令牌容量、填充速率策略; -
亚毫秒级寻优与红队验证:向量化内存回放在约 0.5ms 跑完 400 组策略,找到帕累托最优配置(容量 5token,速率 5req/s,零 5xx 错误);最后由混沌红队智能体在隔离沙箱做压力测试:清空全部缓存、灌入 200 并发请求。新接入的流量整形智能体承接冲击,无 5xx 错误,数据库最高负载仅 13%,验证架构韧性达标。 
4. 企业云管控:纵深防御体系
管控核心原则:AI 智能体可以自主调整处置策略保障业务健康,但它的执行权限,由不可变更的企业策略、硬件密钥、双人人工审批做密码级约束。
想要在生产安全部署自我演进智能体,这套架构构建了一条不间断的四层管控链路:
-
入站防护 + AST 沙盒清洗:遥测告警进入推理链路前,Model Armor 扫描对抗提示注入、脱敏敏感数据;智能体生成修复代码时,AST 遍历器提前拦截未授权系统调用、任意代码执行风险; -
密码可信溯源 & 二进制授权:校验通过的代码、沉淀规则,全部使用 Cloud KMS 非对称密钥签名;API 网关中间件强制二进制授权校验,未通过验签的内存限流器禁止挂载; -
策略即代码 + 双人共管人在回路:OPA 控制器强制 SLA 护栏(例如限流下限≥10req/s,防止 AI 意外把服务限死);高风险的二层结构变更(修改 ADK 智能体拓扑)触发 HITL 关卡,拿到 SRE 密码审批令牌后才能继续; -
防篡改审计:告警清洗、AST 检查、KMS 签名、策略判定、人工审批,每一步都生成结构化日志存入 Cloud Logging,满足合规与事后溯源取证要求。
5. 仿真测试结果
在黑色星期五缓存雪崩自动化对比测试中,这套自我演进架构显著优于人工处置、静态 AI 辅助副驾。

6. 参考资源
-
GitHub 参考实现与演示:https://github.com/GoogleCloudPlatform/generative-ai/tree/main/agents/self-evolving-ai -
投产平台:Gemini 企业智能体平台 -
管控组件:Cloud KMS / Model Armor / BigQuery / Cloud Logging
前置共识:
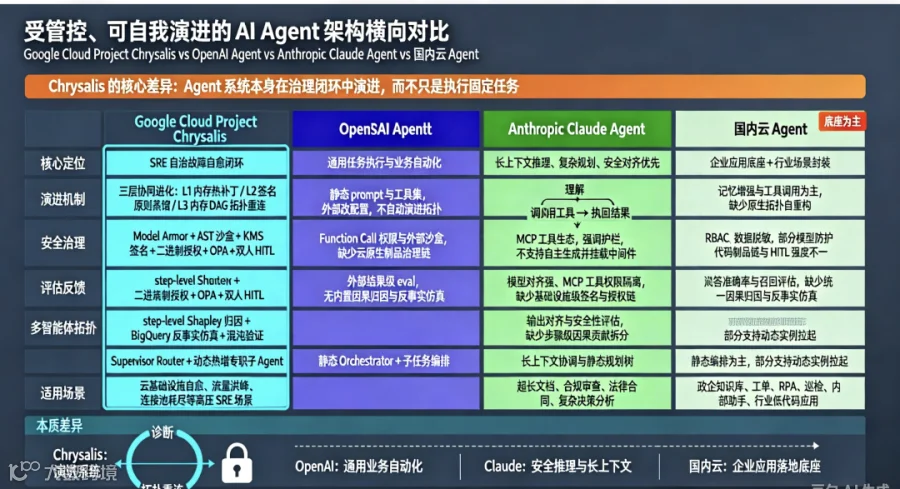
-
Chrysalis 不是通用对话 Agent 框架,目标场景是生产云 SRE 自治故障处置,属于垂直闭环自治智能体; -
OpenAI Agent、Anthropic Agent 主打通用推理、工具调用、任务编排,面向开发、业务自动化; -
国内云 Agent(阿里云百炼、腾讯 WorkBuddy/ADK、百度千帆、华为云 Agent)大多是平台化 Agent 开发底座,兼顾通用 + 行业落地,管控能力参差不齐。 -
对比维度:核心定位、演进机制、安全治理、归因评估、多智能体拓扑、运行时、生产约束、适用边界、短板。
一、总览对比表
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|