

10个关键问题Q&A
-
Q:Xiaomi-OCR-0 和普通 OCR(PaddleOCR)区别是什么? A:传统 OCR 只做文字识别;Xiaomi-OCR-0 是 VL 模型,识别 + 结构理解 + 问答 + 抽取一体化,可以直接输出表格、公式、回答文档里的问题。 -
Q:0.8B 这么小,为什么 OCR 解析分数很高? A:核心不在模型容量,而在 1.7 亿样本的数据引擎:多专家投票标注、渲染校验、定向合成难例,高质量标注是关键。 -
Q:Mix-RL 和 MOPD 是什么? A:MOPD 是双教师蒸馏(解析教师 + VQA 教师),收敛快;Mix-RL 是混合任务强化学习,训练更慢、最终指标更高。 -
Q:Q-Mask 的作用? A:文本锚定,把文字内容和图像空间位置精细对齐,保证布局、阅读顺序识别准确。 -
Q:OTSL 是什么? A:一种结构化表格表示格式,模型原生输出,方便程序解析表格结构。 -
Q:Ollama 版本可以直接跑收据识别、PDF 解析吗? A:拉取镜像后,需要配套官方 MCP 服务或 Demo 脚本,内置预处理和 prompt 模板;单独拉模型不能直接开箱即用。 -
Q:可以商用吗? A:许可证 Apache-2.0,允许商用,需要遵守协议,第三方组件单独看声明。 -
Q:和 MinerU 对比优势在哪? A:MinerU 侧重文档解析流水线;Xiaomi-OCR-0 单模型同时支持解析 + VQA 问答,体积更小,适合轻量本地 Agent。 -
Q:手写、行书草书识别效果怎么样? A:Chronicles-OCR 数据集 73 分,和 Seed2.0 Pro 持平,在小模型里属于不错水平,但距离专业书法识别还有差距。 -
Q:适合哪些落地场景? A:小票 / 票据 KIE、论文公式表格提取、档案扫描件结构化、本地文档问答 Agent、离线文档质检。 
Xiaomi-OCR-0 是小米开源的 0.8B 统一 OCR 专用视觉语言模型,基座基于 Qwen3.5-0.8B-Base,一套模型同时完成文档解析、表格 / 公式识别、手写识别、关键信息抽取 KIE、OCR 视觉问答,训练集约 1.7 亿样本,Apache-2.0 协议开源,适合本地轻量部署arXiv。
一、亮点 ✨
- 轻量化统一模型
仅 0.8B 参数,不再拆分 OCR 识别模型 + 文档理解 VQA 模型;支持扫描件、扭曲、倾斜、翻拍文档,鲁棒性强。输出格式原生支持 Markdown、OTSL 表格、LaTeX 公式、JSON 结构化抽取。 - 自研自动化数据引擎(核心创新)
-
ETC 异构专家三元共识:8 个主流 OCR/VL 专家模型投票标注文本、表格、公式,选出三方一致样本,不确定样本进入精修 -
渲染校验(Render-Guided Refine-and-Judge):标注结果回渲染成图片,和原图比对,自动发现表格、公式结构错误 -
多因子样本挖掘 + 定向合成:从专家一致性、模型自一致性、语义聚类、历史错误模式筛选样本;补覆盖不足、复现高频错误样本 - 渐进式训练链路
-
Q-Mask 文本锚定:细粒度对齐文本内容与空间位置 -
OCR 持续预训练 CPT:多任务基础能力搭建 -
Mix-RL 混合任务强化学习:基于可验证奖励优化难题样本 - 三大实验结论(关键学术发现)
-
当文档解析能力已经较强时,增加 OCR 理解类数据,反而可以进一步提升解析指标;早期加理解数据会带来小幅负向影响 -
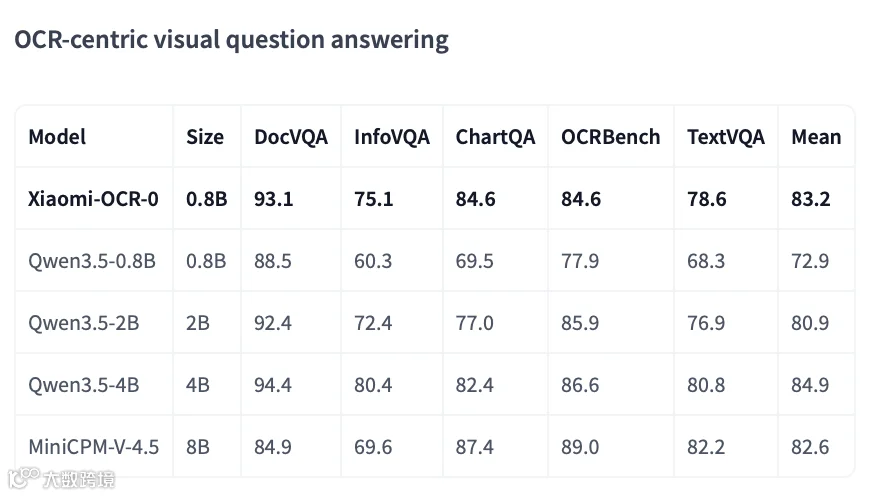
OCR 视觉问答(理解任务)比纯文档解析更吃参数量:0.8B→4B,解析提升极小(≈0.15 分),理解任务提升明显(≈4.9 分) -
MOPD 双教师蒸馏收敛更快;Mix-RL 训练更久,但最终性能上限更高 - 开源生态友好
社区已产出 GGUF 量化版本、NInfer 包、Ollama 镜像,支持本地 CPU/GPU 推理;配套 MCP 服务、Agent 能力、批量处理代码。
二、Benchmark 成绩
-
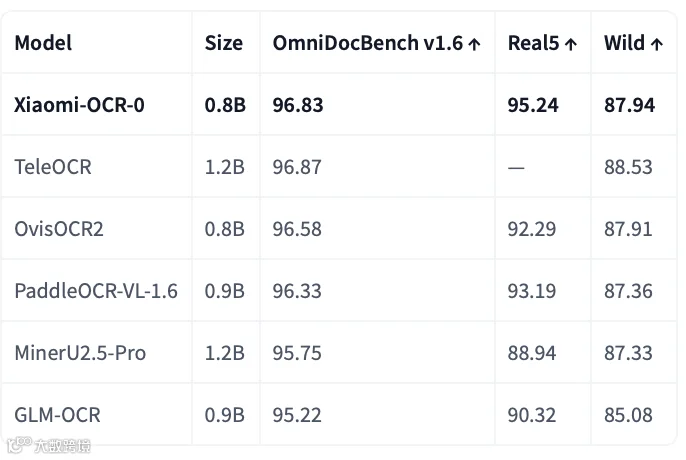
Real5-OmniDocBench:95.24(第 1) -
OmniDocBench v1.6:96.83(第 2)|Wild-OmniDocBench:87.94(第 2) -
UniMER-Test 公式识别:97.84;PubTabNet 表格识别:92.27 -
古文字 / 书法(Chronicles-OCR):73,对标 Seed2.0 Pro (72),支持隶书、草书、行书、楷书 -
OCR VQA 五榜均值:83.2,超过 Qwen3.5-2B(80.9),参数只有对方 40%
三、支持任务与 Prompt 模板
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
四、部署方式
-
Transformers 原生:torch+transformers,支持 cuda/mps/cpu,样例代码已给出 -
Ollama: longwayxu/xiaomi-ocr-0:bf16(约 1.8GB),配套 MCP、浏览器 Demo -
GGUF 量化:Q3_K_L/Q4_K_M/Q5_K_M/Q6_K 等,需要单独 mmproj 视觉投影器 -
NInfer BF16 包:包含语言权重、视觉权重、tokenizer、图像预处理配置
五、局限性
-
社区 GGUF、Ollama 版本均非官方评测,精度会有变化 -
理解类 VQA 任务天然上限受 0.8B 参数约束;复杂多步推理弱于更大模型 -
主要面向中文、英文文档,其他语种未充分验证