


10 个研究方向 + 配套分析指标清单
- Agent 会话级负载特征刻画
指标:会话时长分布、单会话 LLM 请求数、单会话工具调用次数、不同 harness 会话长度差异 - TTFT 首 token 时延分析
指标:p50/p90/p99 TTFT,按 harness / 模型 / 会话阶段分组,TTFT 与 prompt 长度相关性 - Prefix Caching 前缀缓存性能评估
指标:缓存命中块数量、缓存 token 节省率、不同 mutation 模式下缓存命中率、缓存块复用距离 - Agent 多轮循环行为建模(用户→LLM→工具)
指标:turn 轮次分布、工具触发请求占比、子 Agent 嵌套深度、会话终止原因分布 - 工具调用行为与失败分析
指标:各工具调用频次、工具失败率、工具执行时延分布、失败工具对应的 token 开销 - 上下文增长与输入 Mutation 模式研究
指标:prompt token 增长曲线,append / 其他 mutation 占比,system/user/tool 角色 token 占比 - LLM 推理资源调度与负载仿真
指标:请求到达间隔、并发请求分布、峰值 QPS、token 吞吐,集群排队时延仿真 - 不同 Agent 框架横向对比
指标:各 harness 的平均工具调用次数、失败率、TTFT、cached token 占比 - 长上下文 Agent 会话特性
指标:超长会话(>N 轮)的缓存收益衰减、长会话工具错误累积效应 - 推理成本建模(token 计费)
指标:单会话总 prompt/completion/cached token,每轮请求 token 成本分布,缓存带来成本下降比例
四、完整 Python 样例
依赖:
pip install datasets polars
from datasets import load_dataset
import polars as pl

# ========== 1. 加载数据集(流式,节省内存) ==========
# 加载requests和tool_calls子集,选定某一周分片
ds_requests = load_dataset(
    "harvardMadsys/freeinference_agentic_trace",
    "requests",
    split="week_2026_08_30",
    streaming=True
)
ds_tools = load_dataset(
    "harvardMadsys/freeinference_agentic_trace",
    "tool_calls",
    split="week_2026_08_30",
    streaming=True
)

# 转Polars DataFrame
df_req = pl.from_arrow(ds_requests.data.to_pyarrow_table())
df_tool = pl.from_arrow(ds_tools.data.to_pyarrow_table())

# ========== 2. TTFT统计 p50/p90/p99 ==========
ttft_stats = df_req.select(
    pl.col("ttft_ms").median().alias("p50_ttft_ms"),
    pl.col("ttft_ms").quantile(0.9).alias("p90_ttft_ms"),
    pl.col("ttft_ms").quantile(0.99).alias("p99_ttft_ms")
)
print("==== TTFT统计 ====")
print(ttft_stats)

# ==========3. 缓存命中率(cached token / total prompt token) ==========
cache_stats = df_req.select(
    (pl.col("provider_tokens.cached").sum() / pl.col("provider_tokens.prompt").sum())
    .alias("global_cache_hit_ratio")
)
print("\n==== Token缓存命中率 ====")
print(cache_stats)

# ==========4. 工具调用失败率 outcome != success ==========
tool_fail = df_tool.with_columns(
    fail_flag = pl.col("outcome") != "success"
).select(
    pl.col("fail_flag").mean().alias("tool_fail_rate"),
    pl.col("fail_flag").sum().alias("fail_count"),
    pl.count().alias("total_tool_calls")
)
print("\n==== 工具调用失败率 ====")
print(tool_fail)

# ==========5. 按Agent harness分组统计 ==========
df_req.join(
    df_req.select("session_id","harness").unique(),
    on="session_id"
).group_by("harness").agg(
    pl.col("ttft_ms").median().alias("p50_ttft"),
    pl.count().alias("request_count")
).sort("request_count", descending=True).show()
对比表:FreeInference Agentic Trace vs 同类 Agent Trace 数据集
|
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
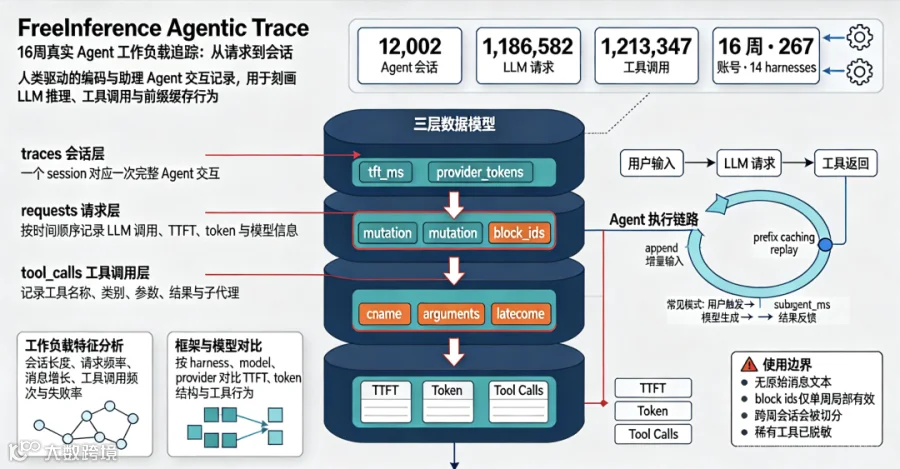
数据集:harvardMadsys/freeinference_agentic_trace(哈佛 MaDSys) 配套论文:From Requests to Sessions: A Large-Scale Characterization of Human-Driven Agentic Workloads核心定位:大规模人类驱动的 Agent 智能体工作负载真实追踪数据集,专门用于研究 LLM 智能体调用、工具使用、前缀缓存(prefix caching)、推理时延特征。
一、数据集总览
基础规模
-
时间跨度:16 周(2026-05-17 ~ 2026-09-05) -
会话:12002 个 Agent 会话,来自 267 个账号、14 种 Agent 框架(harness) -
LLM 请求:1zzzzzzzz,186,582 次 LLM 调用请求 -
工具调用:1,213,347 次 tool call -
模态:表格 + 文本;存储格式:zstd 压缩 JSONL + 预处理 Parquet -
规模区间:1M < n <10M;协议:CC-BY-4.0(可商用,署名) -
重点标签:agents、llm-inference、tool-use、prefix-caching、traces
⚠️ 重要限制:没有开放原始对话消息文本,只保留时序、时延、token、工具调用、缓存块元数据。
Agent Harness(智能体框架)
数据里包含 14 种不同 Agent 执行框架,样例中可见:hermes、cline、kilo、claude-code 等,都是代码 / 助理类 Agent,任务以编码为主。
二、数据分层结构(三层核心表)
数据集拆分为 3 个子集:traces/ requests/ tool_calls
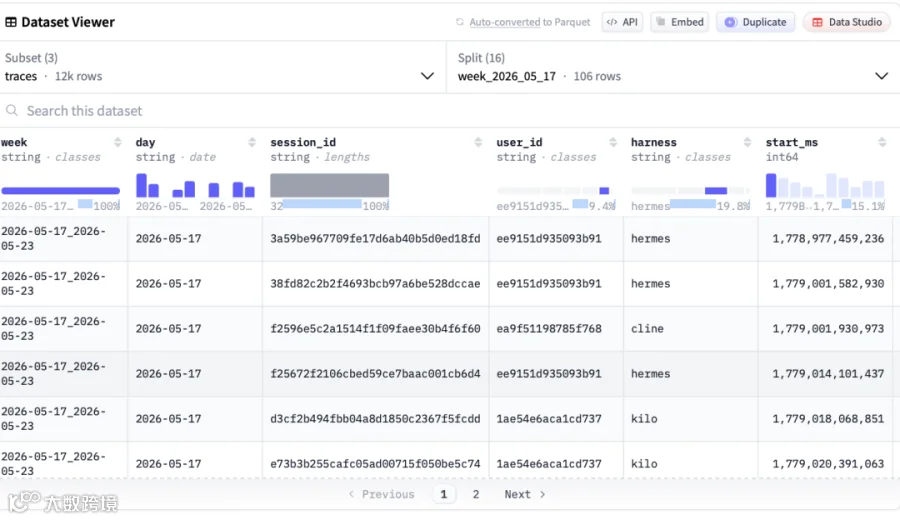
- traces(会话层,12k 行)
:一行 = 1 个完整 Agent 会话 - requests(请求层,1.22M 行)
:一行 = 单次 LLM 模型调用 - tool_calls(工具调用层,1.28M 行)
:一行 = 单次工具调用动作
traces 会话字段(顶层)
-
week /day:周分片、日期,数据按周切分 -
session_id /user_id:会话 ID、匿名用户 ID -
harness:Agent 框架名称 -
start_ms /end_ms:会话起止时间戳(毫秒) -
requests:数组,包含该会话内按时间序所有 LLM 请求
requests LLM 请求核心字段(最关键,用于推理性能分析)
{
"step":0, "turn_index":0,
"step_trigger":"user/tool",  // 触发来源:用户输入 or 上一轮工具返回结果
"link_reason":null,
"start_ms","end_ms","ttft_ms", // TTFT首token时延,Agent负载核心指标
"model":"glm-5.1", "provider":"B", "stream":true,
"provider_tokens": {"prompt":"总提示token","completion":"生成token","cached":"缓存命中token"},
"role_tokens":{system,user,assistant,tool,tool_definitions}, // 按角色拆分token统计
"n_messages":消息条数,
"tool_definition_names":["read_file","write_file","terminal","execute_code"],
"finish_reason":"tool_calls",
"mutation": 输入变更类型:null/append,刻画会话上下文增量变化,是prefix caching核心
"block_ids": 16-token块ID,用于前缀缓存回放
}
mutation:记录本轮输入相对上一轮的改动,绝大多数 Agent 场景是append 追加,这正是前缀缓存能大幅降成本的根源。 block_ids:输入切分为固定 16token 的块,使用 o200k_basetiktoken 分词,块 ID 仅在单周内局部有效,跨周要增加前缀避免冲突。
tool_calls 工具调用字段
-
call_index、name、category(如 * Interpreter 代码解释器) -
programs:识别出的程序(python 等) -
parse_status:工具参数解析成功 / 失败 -
arguments:参数,敏感值做占位替换 -
outcome:工具执行结果(error/success) -
result_tokens:工具返回内容 token 量 -
latency_ms:工具执行耗时 -
subagent:嵌套子 Agent 会话(支持子智能体递归)
三、数据分片规则
-
Split 按周划分,共 16 个 week 分片,从 week_2026_05_17到week_2026_08_30 -
会话不会跨周:如果一个 Agent 会话跨越周末,会被拆成两个独立会话 -
每周目录包含:原始 jsonl.zst 会话文件 + manifest.json(被过滤会话及排除理由) -
脱敏规则:出现少于 3 个账号的稀有工具名、命令,统一替换为 other或占位符,保护隐私
四、典型使用场景(这个数据集的价值)
- Agent 工作负载特征分析
人类真实使用的编码 Agent:多轮循环(用户→LLM→工具→LLM→工具),分析 TTFT、token 分布、上下文增长模式、工具调用频次 / 失败率,论文本身就是做这个。 - Prefix Caching 前缀缓存仿真与评估
内置 16-token block 划分、block_ids、mutation 输入变更信息,可以直接回放缓存命中,复现前缀缓存的收益,评估不同缓存策略在 Agent 负载下的 token 节省、时延下降。 - LLM 推理调度、网关、资源规划
Agent 负载和普通 chat 负载差异极大:长上下文、大量 cached token、工具触发多轮调用;可以用来仿真推理集群负载、排队时延、QoS。 - Agent 框架对比
按 harness 分组,对比不同 Agent 框架(cline/hermes/kilo 等)的调用模式、TTFT、工具失败率、token 消耗,样例 SQL 就是按 harness 统计 p50 TTFT。
五、读取与查询方式
1. DuckDB 直接查询 HF 上 Parquet(无需下载全量)
SELECT
    sessions.harness,
    count(*) AS requests,
    approx_quantile(requests.ttft_ms, 0.5) AS p50_ttft_ms
FROM 'hf://datasets/harvardMadsys/freeinference_agentic_trace/release/*/processed/requests.parquet' AS requests
JOIN 'hf://datasets/harvardMadsys/freeinference_agentic_trace/release/*/processed/sessions.parquet' AS sessions
    USING (session_id)
GROUP BY sessions.harness
ORDER BY requests DESC;
2. HuggingFace datasets 加载
from datasets import load_dataset
# 加载会话trace
traces = load_dataset("harvardMadsys/freeinference_agentic_trace", "traces", split="week_2026_08_30")
# 请求、工具调用,支持streaming流式读取(适合大数据,不占内存)
requests = load_dataset("harvardMadsys/freeinference_agentic_trace", "requests", split="week_2026_08_30", streaming=True)
tool_calls = load_dataset("harvardMadsys/freeinference_agentic_trace", "tool_calls", split="week_2026_08_30", streaming=True)
3. 命令行下载
# 全量下载
hf download harvardMadsys/freeinference_agentic_trace --repo-type dataset --local-dir freeinference_trace
# 只下载单周数据
hf download harvardMadsys/freeinference_agentic_trace --repo-type dataset --local-dir freeinference_trace --include "release/2026-08-30_2026-09-05/*"
六、关键局限
- 无原始对话文本
,只能做负载 / 性能层面研究,不能做 Agent 提示、内容质量评估; -
block ID 仅单周局部有效,跨周做缓存仿真必须加前缀; -
token 统计是用 tiktoken o200k_base 算的,不一定等于模型服务商真实分词器; -
会话跨周会被截断,会损失长会话连续性; -
稀有工具被脱敏替换,细粒度工具行为分析受限。
七、引用
@article{freeinference2026requests,
  title={From Requests to Sessions: A Large-Scale Characterization of Human-Driven Agentic Workloads},
  author={Nixon, William and Tian, Muxin and Zheng, Yunjia and Gunawi, Haryadi S. and Yang, Juncheng},
  year={2026}
}