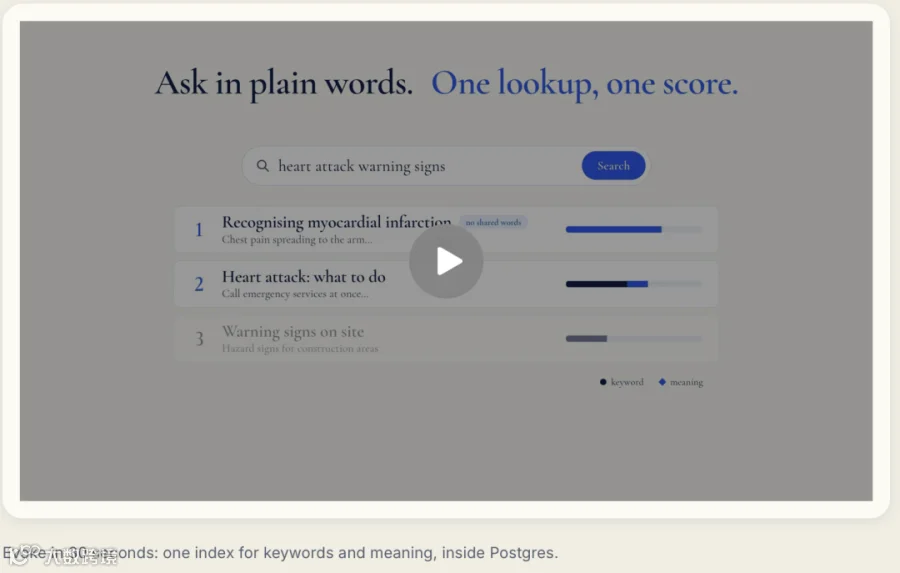
编者摘要:还在用 Postgres 做 RAG 语义检索的团队,大多要搭一套复杂外部系统:单独 Embedding 模型、向量索引,还要同步维护关键词 + 向量两套检索,最后合并打分结果,运维成本很高。
Evoke(II-42)这款 Postgres 开源扩展,直接把关键词检索和语义检索合并到同一个索引里。它内置 30M 轻量模型,在数据库内部 CPU 运行,文本不用传出数据库,也不需要 GPU。
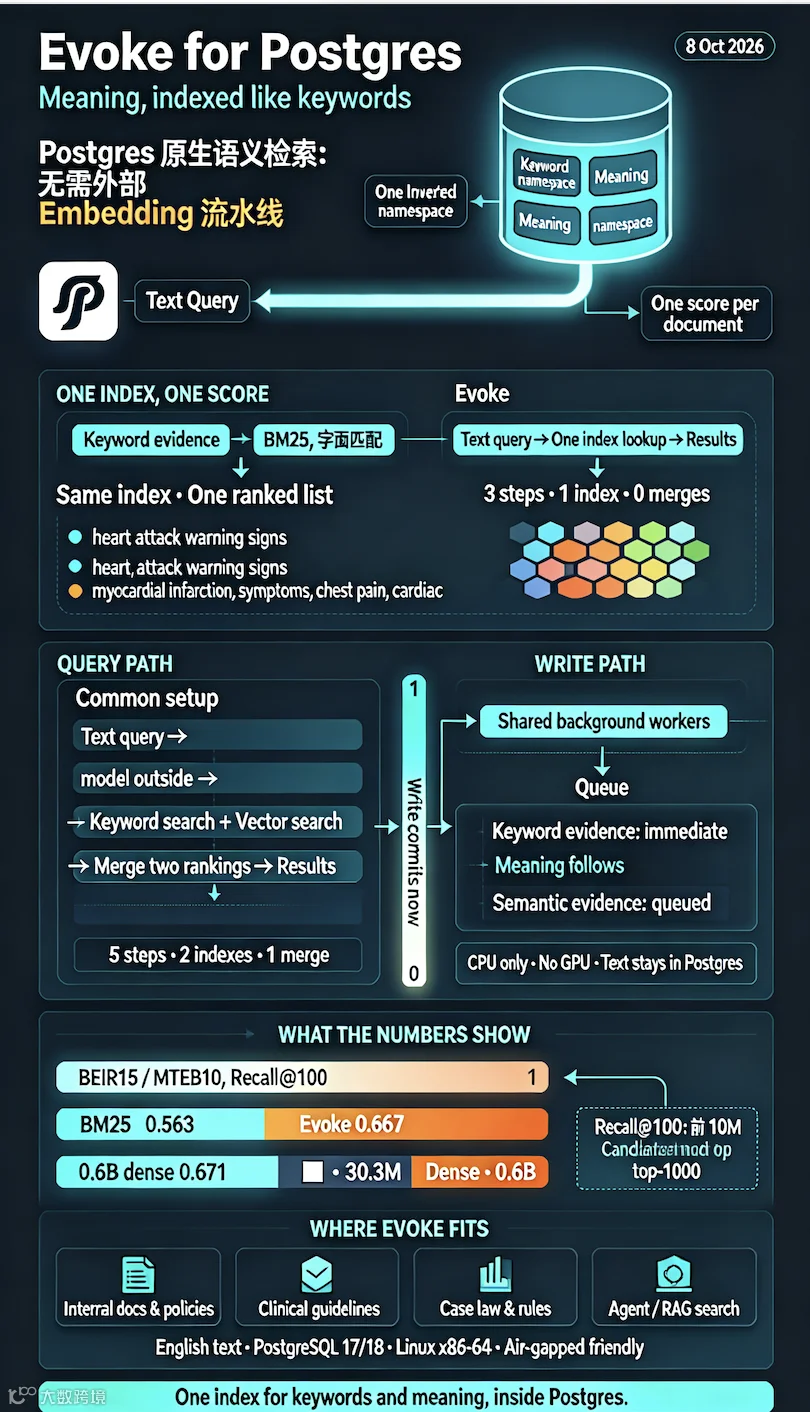
原理是学习型稀疏检索:模型把文档生成额外的概念词,和原文关键词放进倒排索引的不同命名空间,查询时两类证据合并算出单一分数,省去双索引结果融合。写入时关键词实时入库,语义编码后台异步处理,不阻塞业务。
实测在英文数据集上,它召回效果接近参数量大 20 倍的稠密向量模型。适合内网隔离场景,用来做知识库、法规、病历、企业文档检索,给 AI 智能体 /rag 提供高质量检索源。开源协议 Apache2.0,支持 PG17/18。
10 个关键问题 Q&A
- Evoke 是什么?
PostgreSQL 开源扩展(II-42),在数据库内同时实现关键词 + 语义检索,不用单独向量库。 - 它和 pgvector 最大区别?
pgvector 存稠密向量,通常需要关键词 + 向量两套索引,结果要融合;Evoke 用稀疏词项,单倒排索引,统一打分。 - 什么是稀疏语义检索 SSR?
模型输出一批带权重的概念词(不一定原文存在),和 BM25 关键词放在同一个倒排索引,合并计算相关性分数。 - 需要 GPU 吗?
不需要,纯 CPU 运行,模型打包在数据库扩展内。 - 数据会离开数据库吗?
不会,编码推理在数据库内部完成,支持物理隔离离线部署。 - 写入文档后多久能语义检索到?
关键词立刻生效;语义编码走后台队列,存在短暂最终一致性延迟。 - 性能水平怎么样?
30M 小模型,召回效果接近 0.6B 稠密 Embedding 模型,显著优于传统 BM25 关键词检索。 - 支持中文吗?
当前版本面向英文文本,暂不主打中文场景。 - 哪些场景最适合 Evoke?
企业知识库、临床指南、法规判例,给 RAG、AI 智能体做检索,重视召回率;内网隔离环境优势明显。 - 使用门槛?
PostgreSQL17/18,Linux x86-64;一条 SQL 创建索引,用 ii42_query 函数检索,Apache2.0 开源免费。
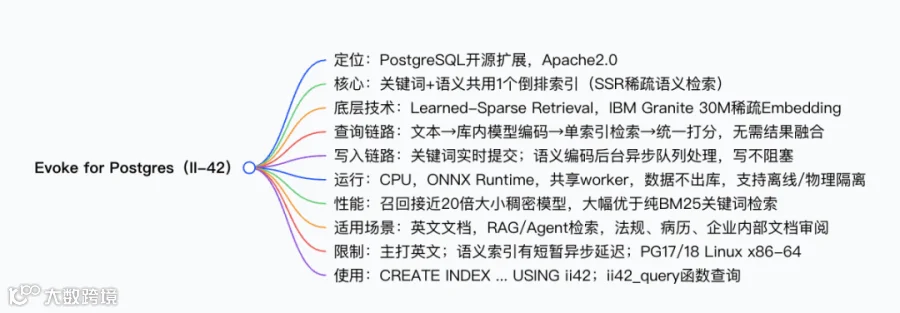
Evoke(项目代号 II-42)是PostgreSQL 开源扩展,核心创新:关键词检索 + 语义检索共用同一个倒排索引,不需要单独向量库、不需要外部 Embedding 流水线,30M 小模型直接在数据库内 CPU 运行,协议 Apache-2.0。
一、核心概念:Learned-Sparse Retrieval(学习型稀疏检索)
传统 RAG / 语义检索方案:
-
文本 → 外部 Embedding 模型 → 稠密向量(dense vector) -
存入独立向量索引 -
BM25 关键词索引与向量索引是两套系统,两套打分,最后要做结果融合(Rerank/Fusion),容易出现分数尺度不一致、同步维护成本高。
Evoke 的思路: 用 IBM Granite-Embedding-30M-Sparse(30.3M 参数)稀疏编码器,把文档 / 查询转换成带权重的词项集合,而不是稠密向量。
-
词项分为两个命名空间: -
关键词词项:原生文本分词(BM25) -
语义词项:模型生成的相关术语(原文里没有出现的同义词、专业同义概念)
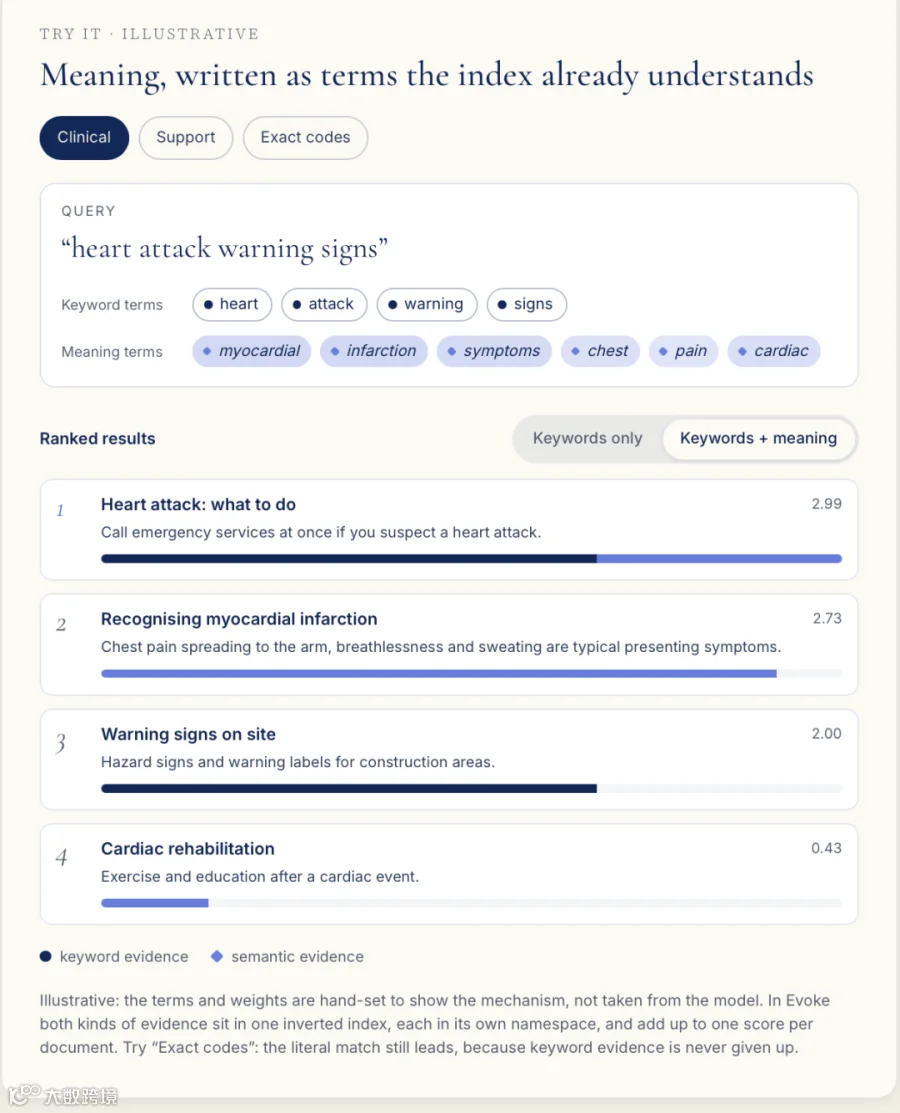
示例:查询
heart attack warning signs关键词词项:heart、attack、warning、signs 语义词项:myocardial infarction、symptoms、chest pain、cardiac
两类词项写入同一个倒排索引,查询时两类证据叠加,输出单一统一分数,不再需要多索引结果合并。
技术名:SSR,Sparse Semantic Retrieval,通过
sae=true开启。
二、读写链路
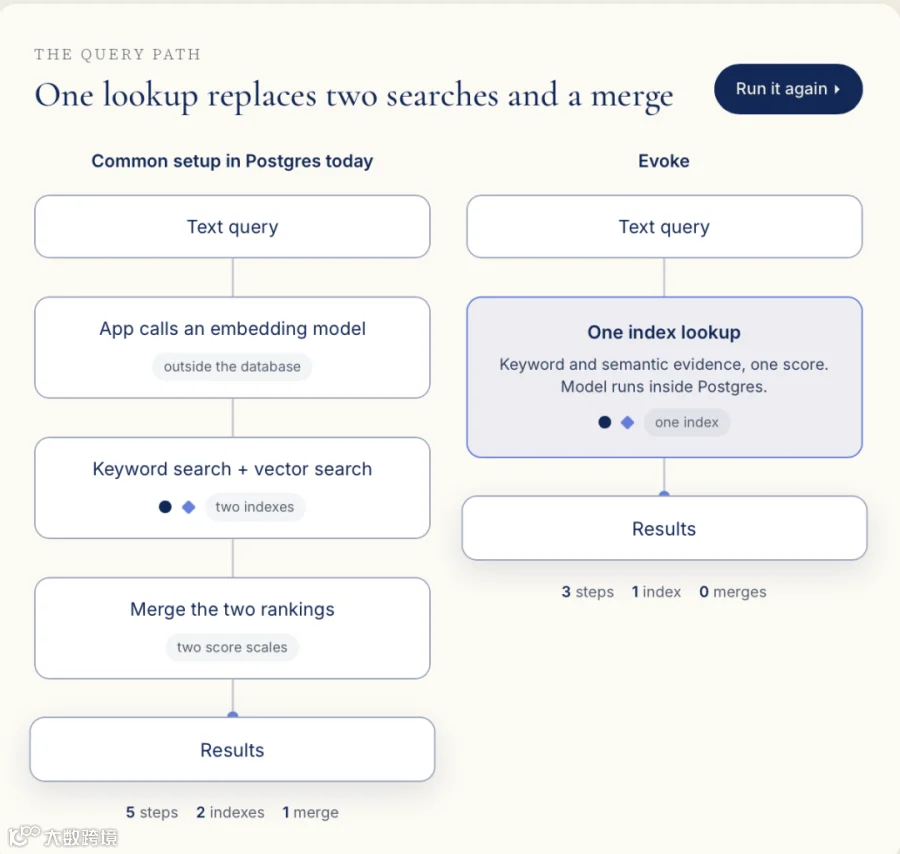
查询链路(对比传统方案)
✅ 传统 Postgres 混合检索:文本输入 → 外部 Embedding API → 关键词检索 + 向量检索(双索引)→ 两套分数融合 → 返回结果,5 步。 ✅ Evoke:文本输入 → 数据库内模型编码 → 单索引查找 → 统一打分,3 步,无融合步骤。 模型跑在数据库共享后台 worker,数据不出库,不需要 GPU,纯 CPU。
写入链路(写入低延迟)
INSERT / UPDATE提交事务:关键词索引立即写入提交,不阻塞业务写入; -
文档丢入队列,由数据库共享后台 worker 异步做语义编码; -
语义词项延迟写入索引;
特点:写请求不会等待模型推理,保证 OLTP 写入性能;语义索引最终一致性。
查询时会校验行可见性,删除的数据不会从旧索引 “复活”,兼容 PG 原生 MVCC、崩溃恢复、物理复制。
三、评测数据(P2.1 模型,发布版为 P2.2)
评测集:BEIR15、MTEB10
-
BM25(纯关键词)BEIR15 Recall@100:0.563 -
Evoke(P2.1,30.3M) BEIR15 Recall@100:0.667 -
0.6B 稠密 Embedding 模型 (pplx-embed-v1-0.6B) BEIR15 Recall@100:0.671
结论:30M 稀疏模型,效果接近 20 倍参数量的稠密向量模型,差距仅 0.004;MTEB10 上同样大幅超越纯 BM25。 Recall@100:前 100 条结果中召回相关文档比例;CUB@1000:在 1000 候选池内召回相关文档比例。 价值:检索第一阶段召回上限提升,后续 Reranker/Agent 才有更多相关文档可用。
四、适用场景 & 约束
✅ 适合场景
-
Postgres 存量英文文档,想升级语义检索,但不想搭建向量数据库、维护 Embedding 同步流水线; -
内网 / 物理隔离(air-gapped)环境,数据不能出数据库服务器; -
Agent、RAG 检索:内部文档、政策手册、临床指南、判例、法规文档; -
人工审阅场景:需要尽可能召回全部相关文档(重视召回率),后续交给重排器或人工筛选。
⚠️ 限制
-
当前面向英文文本; -
语义编码是异步写入,新插入文档语义检索会短暂延迟; -
依赖 PG17/PG18,Linux x86-64; -
稀疏检索不是稠密向量,不适合需要跨模态、长距离精细语义相似度的场景。
五、快速上手示例
Docker 镜像:
docker pull ghcr.io/intelligent-internet/ii-42:pg18-v0.2.5
创建索引(开启 SSR 稀疏语义检索)
CREATE INDEX docs_semantic_idx ON docs USING ii42 (body) WITH (sae = true);

SELECT d.id, d.title,
       ii42_query('docs_semantic_idx'::regclass, 'database search architecture') AS score
FROM docs AS d
ORDER BY score DESC LIMIT 10;
ii42扩展名称; sae=true开启稀疏语义检索;关闭就是原生 BM25 关键词检索。
六、架构亮点
- 单索引统一打分
:BM25 关键词 + 稀疏语义词项共用倒排索引,消除双索引融合痛点; - 数据库内模型推理
:ONNX Runtime 打包,共享 worker 池,CPU 运行,数据不出库,离线可用; - 写不阻塞
:关键词实时落索引,语义编码后台异步完成; - 轻量化
:30M 小模型,召回能力逼近 0.6B 稠密 Embedding; -
完全复用 Postgres 原生 MVCC、备份、复制,不需要额外向量存储运维。
七、和主流向量 PG 扩展对比简要对比
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|