

群里有人说了个 bug,AI 已经递上修复代码。没人 @ 它。
这是 DeepSeek Harness 团队展示的内部案例。AI 持续读群聊,发现问题后在后台复现、修复,再把 Pull Request 交给开发者审查。
Pull Request 就是等人审阅的代码改动。提交了,不等于合并了。
10 月 31 日,团队公开了这套超级智能体(Super-agent)的设计思路,并放出部分原型代码。
它要接管的,是人手动切窗口、转述要求、盯住进度的活。一个人面对同一个助手,背后可以有多个 AI 同时做事。
这篇讲的是团队怎样设计这套系统。下面顺着群聊里的这条 bug,看它怎样从一句反馈走到代码审查。
▲ 图:用户发出问题后,AI 在后台处理并回复;按官方案例重绘,非真实界面截图。
谁接话,谁干活
可以把这套 AI 想成一个小团队。一条反馈先到主管那里:他记着大家手头的活,决定交给谁,再统一回复人。这个角色叫 Router。
实际干活的是 Worker,像各有分工的同事:一个复现 bug,一个审代码,一个开发功能。每个都有自己的工作记录。
修 bug 时碰到的报错、试过的办法,都留在这个任务里,不会挤进其他任务的记录。Worker 忙不过来,还能再找 AI 帮手。
主管留在前台接话。修复交给同事去跑,人来问进度时,就不用等一条耗时命令先跑完。
常见的 AI 团队,是几个人合做一件难事。这里先给不同的事各找一个负责人;每件事需不需要再分工,由负责人决定。
官方认为,负责派活的 Router 往往用轻量模型就够,干活的 Worker 则需要更强的执行能力。这是配置思路,不是必须照抄的组合。
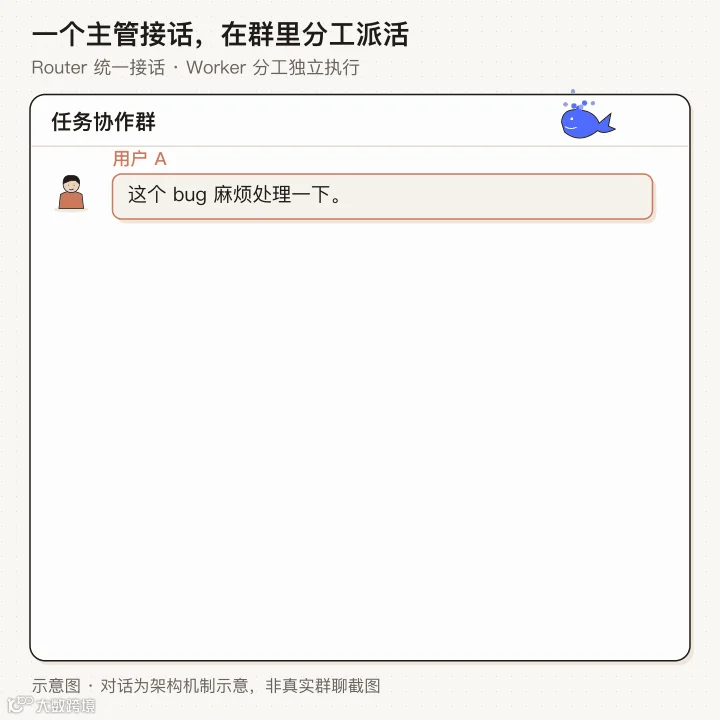
▲ 图:主管派活,各有分工的同事独立执行。
后续评论直接找经手者
群里的闲聊、问题反馈,先经过程序规则。程序先按来源、群组范围和允许名单,滤掉不符条件的消息。
剩下需要理解意思的消息,再交给模型决定是否行动。系统不用为每句闲聊都认真想一遍。
等修复任务有了负责的 Worker,相关 GitHub 评论也会不断进来。每条都找 Router 重新分派,就有点像每次追问都得先找总台。
DeepSeek 把同一个话题、同一个 PR 下的消息归成一串,叫 Thread。像给工单贴上标签,负责这件事的 Worker 可以订阅这串消息。
之后有人追问或补充,程序就直接把消息送给经手的 Worker。事情变了、超出原任务范围,再找主管重新安排。
Router 仍能看到全局,Worker 的关键结果也仍向它汇报。消息少绕一程,不等于取消授权或各自对外发言。

▲ 图:工单贴好标签,后续消息直接找经手者。
“之前那件事”怎样找回来
人不会每次都贴全聊天记录。到了 GitHub,可能只留一句:按群里刚才说的改。
系统得先弄清“刚才”是哪段,负责的人又做到哪里了。
它不会把所有历史一直摊在窗口里。近期可能用到的信息直接带上;太长、暂时用不上的,留下摘要和编号。
真要找细节,就顺着编号翻:这条消息是哪张工单里的,工单交给谁,那位同事又收到了哪条代码审查意见。
每次读到的内容,都带着下一步的线索。像从一张工单翻到相关记录,不必先搬来整个档案柜。
人从群聊换到 GitHub 后,系统仍有办法追到原来的任务。
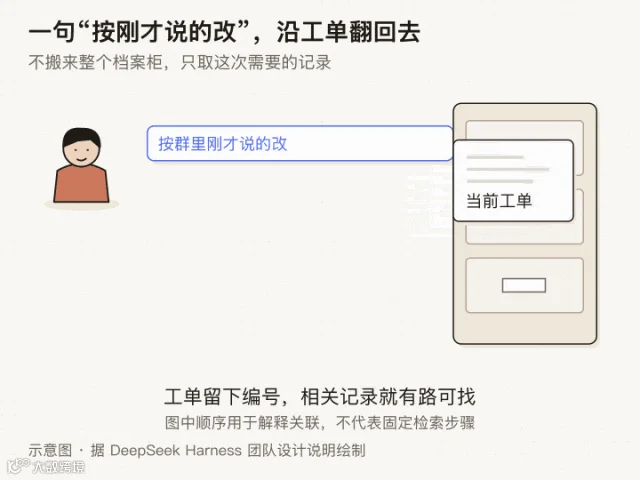
▲ 图:从工单编号翻回相关聊天与评审记录。
工具在跑,人还能改要求
任务执行中,如果人又说:先别修了,换个方案。
常见的调用方式是,模型发出一条耗时命令,等命令结束后才继续。新的要求也跟着排队。
异步调用就像把下载放到后台:启动工具后先回一句“已启动”,工具继续跑,对话不用一直等着。做完后,结果再送回来。
这样,AI 想完眼前这一步,就能接着看你的新消息,不必等后台命令跑完。模型也能发出停止指令。
模型正在想的一步,仍要等它想完。省掉的是等工具的时间。
官方说,这套异步任务机制已经在 Harness 中实现,但还没有默认开启。
同样,AI 主动修 bug 也要先有规则。内部群里配置了“静默复现并修复”:先尝试,有可用结果才交,没有就保持安静。
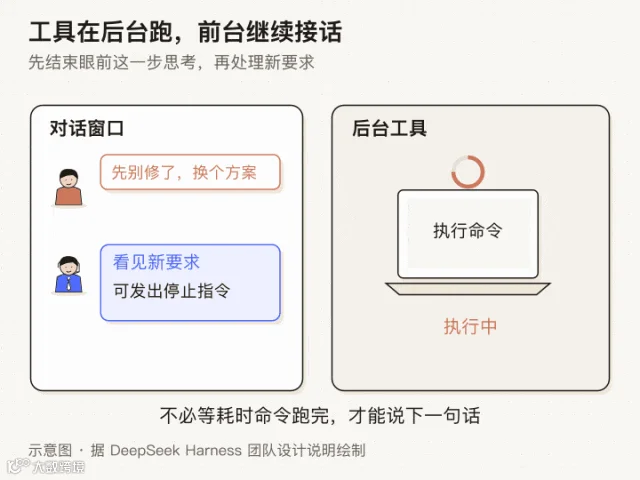
▲ 图:工具在后台跑,对话仍能接收新要求。
关了电脑,任务停在哪里?
可以把它想成远程办公:AI 在云端安排下一步,工作进度存进数据库;代码、文件和干活的软件,仍在实际工作的电脑上。
电脑上留一个小程序接活:收到云端的命令就在本机执行,再把结果送回去。
这样做有个现实原因:本地可能有没提交的修改、私有凭据和内网服务。把环境完整复制上云,本身就很麻烦。
但电脑离线后,依赖这台电脑的命令仍要等它重新上线。云端在线,不会让关机的电脑继续运行代码。
后台还要有个巡检员。这个独立的 AI 会话叫 Watchdog,定时醒来看看:事情往前走了吗?有没有跑偏,或一直重复同一件事?
传统监控能发现进程死了,却未必看得出 AI 一直忙、工作毫无进展。这里要检查的是事情有没有往前走。

▲ 图:云端安排工作,本机执行;电脑离线,命令仍需等待。
快在哪里,实验给了线索
团队用约 300 条合成消息模拟群聊和 GitHub CI,其中约 20 条是工作请求,每种方案跑了 5 次。
消息间隔与工作时长按四分之一缩放,模型调用耗时则是真实值。
这里比较的是:从收到请求到发回结果,那些等得久的任务有多慢。图里的 p95,表示约 95% 的任务耗时不超过这个位置。
与中性提示下的单会话加子智能体工具相比,Super-agent 的长尾等待明显更短。
中性提示方案跑了 5 次,一次也没委派,所有活都留给自己做。
把提示改成优先委派后,5 次里有 4 次派了出去,耗时有所改善,整体仍慢于 Super-agent。
另一次,它觉得工作很小,还是自己做了。
差别出在谁来派活:这套设计提前说好,主管专心分派,同事负责执行,少了模型临场纠结“这次要不要自己干”。

▲ 图:官方模拟调度实验。
开源了,哪些还不能照单全收
实验把编码换成只消耗时间的工具,测的是调度协作。它没有证明代码修得更好,此次也没有找到独立复现。
跨月记忆、外部消息注入、云端与本地凭据安全,仍被官方列为开放问题。
X 用户 Henk Nie 担心,Router 记错一件事,后面并发越多,错误可能扩得越快。这是个人担忧,尚非故障实测。
部署文档写明,Router 和 Worker 都按“全访问”运行(danger-full-access)。你这个系统账号能碰的文件,它们也能碰。
单独的 GitHub 账号不会隔离本机文件,官方建议用专用系统账号。
多个 AI 一起干活,也更费用量。官方实验中,Super-agent 读取缓存的 token 更多,也就是反复取用已有材料的量更大。
关闭直通后,Router 多做约三成决定,读缓存量明显增加,完成时间却基本相同。
直通省的是转发与推理开销。模型用量加上部署开销,才是实际成本;目前没有完整账单能下性价比结论。

▲ 图:直通减少读缓存。
原型从一个仓库开始
公开的 dsh-superagent-prototype 用 MIT 许可证,面向单个 GitHub 仓库,飞书可选。
README 明说,它与内部版本不同,没有实现文章的全部设计。云端与端侧分离,也不能直接当作这个原型的完整部署能力。
想试用,要准备 DeepSeek Harness、模型提供方、GitHub 专用账号和允许名单,按仓库 SETUP.md 配置。它不是新模型的 API,也不是网页里打开一个开关。
默认的 observe(观察)模式,相当于先记一份“我会怎么做”,不真正动手执行主动发现的任务;符合规则的明确请求仍会执行。飞书默认只读 @ 消息。
回到开头那个 PR。代码可以先交,人仍要验收;要不要合并、允许它主动做到哪一步,还得有人负责。

参考资料
01|DeepSeek Harness 团队:Super-agent 设计探索(DeepSeek 产品部撰文,2026-10-31)
https://mp.weixin.qq.com/s/zoS7GlReWPhfCjENGxXCdg
02|DeepSeek:dsh-superagent-prototype 的 README、SETUP 及 docs/000–008
https://github.com/deepseek-ai/dsh-superagent-prototype