

在大模型强化学习训练中,训练阶段的优化并不一定能够稳定地转化为模型在推理阶段的能力提升。
MemoraX AI 联合天津大学、阿里巴巴,围绕这一问题展开研究,提出 MIPI 原则,并进一步设计了具体实现方法 MIPU。该成果已收录至NeurIPS 2026。
这项研究关注的核心问题是:如果训练阶段的优化没有真正改善模型最终的推理表现,那么这种训练优化是否仍然具有实际价值?
01
训练策略变好了,模型的
回答就一定变好了吗?
在大模型强化学习训练中,研究人员通常会围绕奖励函数、策略更新、采样方式和优化目标等因素进行调整,并通过训练损失、奖励变化或策略收敛情况判断训练是否取得进展。
但训练阶段的指标变化,并不一定能够完全代表模型在推理阶段的真实表现。训练过程可能涉及 vLLM、SGLang、Megatron、FSDP 等不同框架和组件,不同系统在采样方式、计算精度、并行策略和实现细节上的差异,可能导致模型在训练阶段与推理阶段出现不同的行为。
这种现象通常被称为训练-推理不一致,也就是 training-inference mismatch。
它可能导致训练阶段观察到的优化结果无法完全反映模型推理阶段的真实表现,一些在训练过程中看起来有效的更新,也可能没有转化为更好的最终回答。
因此,一个值得进一步研究的问题是:我们应该继续优化训练过程本身,还是应该直接优化模型最终生成回答的方式?
02
MIPI:重新定义
训练优化的目标
传统方法往往围绕“如何改进训练策略”展开,例如调整学习率、优化采样方式、改进奖励设计或更新策略。
但 MIPI 的关注点有所不同:它尝试把模型实际生成回答的质量,直接纳入训练优化目标。
MIPI 的核心思路是,训练过程不应只关注训练策略本身是否得到优化,还应该更加直接地关注模型最终如何生成更好的回答。
如果模型每次更新之后,都能够在真实推理任务中生成更高质量、更稳定的回答,那么这次训练更新才具有更加明确的实际价值。
设μₖ 表示第 k 轮更新后的推理策略,πₖ 表示第 k 轮训练阶段使用的策略,J 表示模型在实际推理任务上的表现评价函数。MIPI 希望满足:
J(μₖ₊₁) − J(μₖ) ≥ 0
也就是说,在每一轮更新之后,模型的推理表现不应下降。推理表现的变化还可以拆解为:
J(μₖ₊₁) − J(μₖ) = [J(μₖ₊₁) − J(πₖ₊₁)] + [J(πₖ₊₁) − J(πₖ)] + [J(πₖ) − J(μₖ)]
其中,第一项表示更新后推理策略与训练策略之间的差距,第二项表示训练端策略更新带来的变化,第三项表示更新前推理策略与训练策略之间的差距。
这个分解说明,模型最终推理表现的变化,不仅取决于训练端策略是否得到优化,也取决于训练策略和实际推理策略之间是否存在差异。
03
MIPU:将原则转化为
具体训练流程
为了将 MIPI 原则转化为可执行的训练流程,研究进一步提出了 MIPU。
MIPU 将训练过程组织为两个主要步骤:第一步生成并筛选训练候选;第二步评估候选回答并决定是否接受更新。
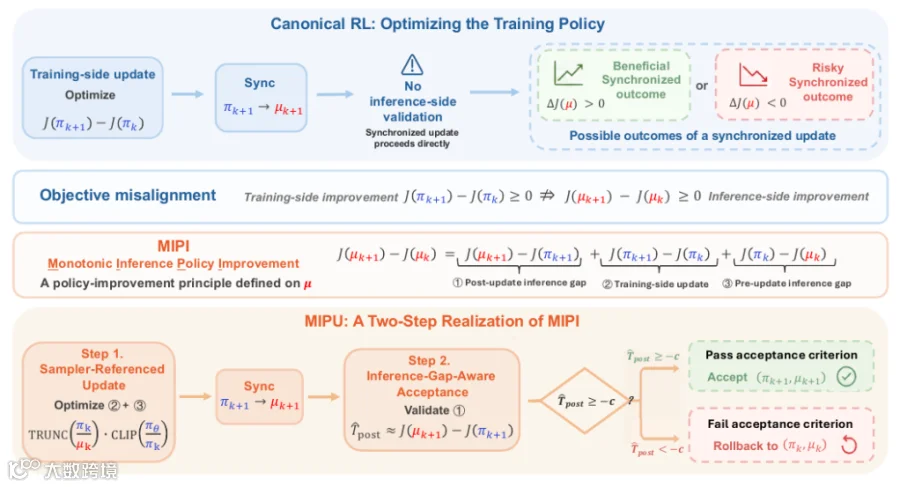
图1|MIPI 原则与 MIPU 实现流程
MIPU 的基本流程是:首先根据当前模型和更新后的模型生成候选回答;随后比较不同候选回答在实际任务中的表现;最后根据候选回答的质量和稳定性,对训练更新进行筛选。只有当某次更新能够带来更好的推理结果时,才将其纳入后续训练过程。
Step 1:使用更新前后的策略生成候选
在 GRPO 等强化学习训练方法中,模型会根据新的训练策略生成回答,并依据奖励信号更新参数。MIPU 在第一步中,同时关注当前训练策略和更新后训练策略对候选回答的概率变化。
通过比较更新前后的策略变化,MIPU 可以获得更多关于模型训练更新的信息,并判断某次更新是否真正改变了模型的推理行为。在具体实现中,研究还对重要性权重和截断方式进行了处理,以减少过大的权重变化对训练过程造成的不稳定影响。
πᵏθ / μₖ = (πₖ / μₖ) × (πθ / πₖ)
经过 Step 1 筛选后,MIPU 可以得到一组候选模型或候选更新结果,为后续评估提供基础。
Step 2:评估候选回答并筛选更新
在第二步中,MIPU 会进一步评估候选模型生成的回答。如果更新后的模型对高质量回答的概率更高,同时对低质量回答的概率更低,那么这次更新可能更有价值。反过来,如果模型只是改变了回答分布,却没有提升实际回答质量,那么这次更新就不一定值得保留。
MIPU 的重点并不是拒绝越多更新越好,而是在模型性能提升和必要探索之间保持平衡。如果系统拒绝过多候选结果,模型可能会停留在旧的参数状态,无法继续探索新的推理路径。
04
实验设置与结果
为了验证 MIPU 的效果,研究在 Qwen3-1.7B 和 Qwen3-4B 模型上进行了实验,并使用 FP8 训练设置,观察其在数学推理任务上的表现。
实验覆盖 MATH-500、AIME24、OlympiadBench、Minerva、AMC23 等多个数学推理基准。
研究将 MIPU 与标准 GRPO、MIS 以及学习率衰减等方法进行比较,评估指标包括 pass@1、avg@16、pass@16、不同模型规模下的平均准确率,以及训练过程中的稳定性。

从实验结果来看,MIPU 在不同模型规模下都取得了相对标准 GRPO 更高的平均准确率。在 Qwen3-4B 模型上,MIPU 的平均准确率达到 66.71%;在 Qwen3-1.7B 模型上,MIPU 的平均准确率达到 53.97%。

图2|Qwen3-4B 在 FP8 设置下的训练曲线
除最终平均成绩之外,研究还观察了训练过程中模型表现的变化。实验结果显示,MIPU 不仅取得了更高的平均成绩,也在训练过程中表现出更加稳定的分数变化。
研究进一步分析了 MIPU 中不同步骤的作用。实验发现,仅使用候选生成并不一定能够筛选出真正可靠的更新结果。MIPU 的第二步候选评估,可以帮助训练过程判断哪些更新更有价值。

结果表明,将候选生成与候选评估结合后,完整 MIPU 获得了更高的平均准确率。同时,候选筛选并不是简单地拒绝越多更新越好,而是需要在接受有效更新和保留必要探索之间保持平衡。
05
总结与展望
这项工作围绕大模型强化学习训练中的训练—推理不一致问题展开,提出了 MIPI 原则,并通过 MIPU 对这一原则进行了具体实现。
研究的核心观点是:训练阶段的优化不应只关注训练过程本身是否变得更好,还应关注这些优化是否真正改善了模型最终的推理表现。
MIPU 通过候选生成、候选评估和更新筛选,将模型推理结果纳入训练优化过程。
在 FP8 实验中,MIPU 在 Qwen3-1.7B 和 Qwen3-4B 模型上取得了更高的平均准确率,并表现出更加稳定的训练轨迹。
目前,实验主要集中在 1.7B 和 4B 规模模型,以及数学推理任务上。未来还可以进一步研究 MIPU 在更大规模模型、代码生成、知识问答、工具调用等任务中的适用性,以及不同训练框架和推理系统下的稳定性。
从更广泛的角度来看,这项研究也反映出大模型强化学习中的一个重要方向:如何让训练阶段的优化,更直接、更稳定地转化为模型在真实任务中的能力提升。
END
关注+星标,获取AI前沿进展与开源一线动态