

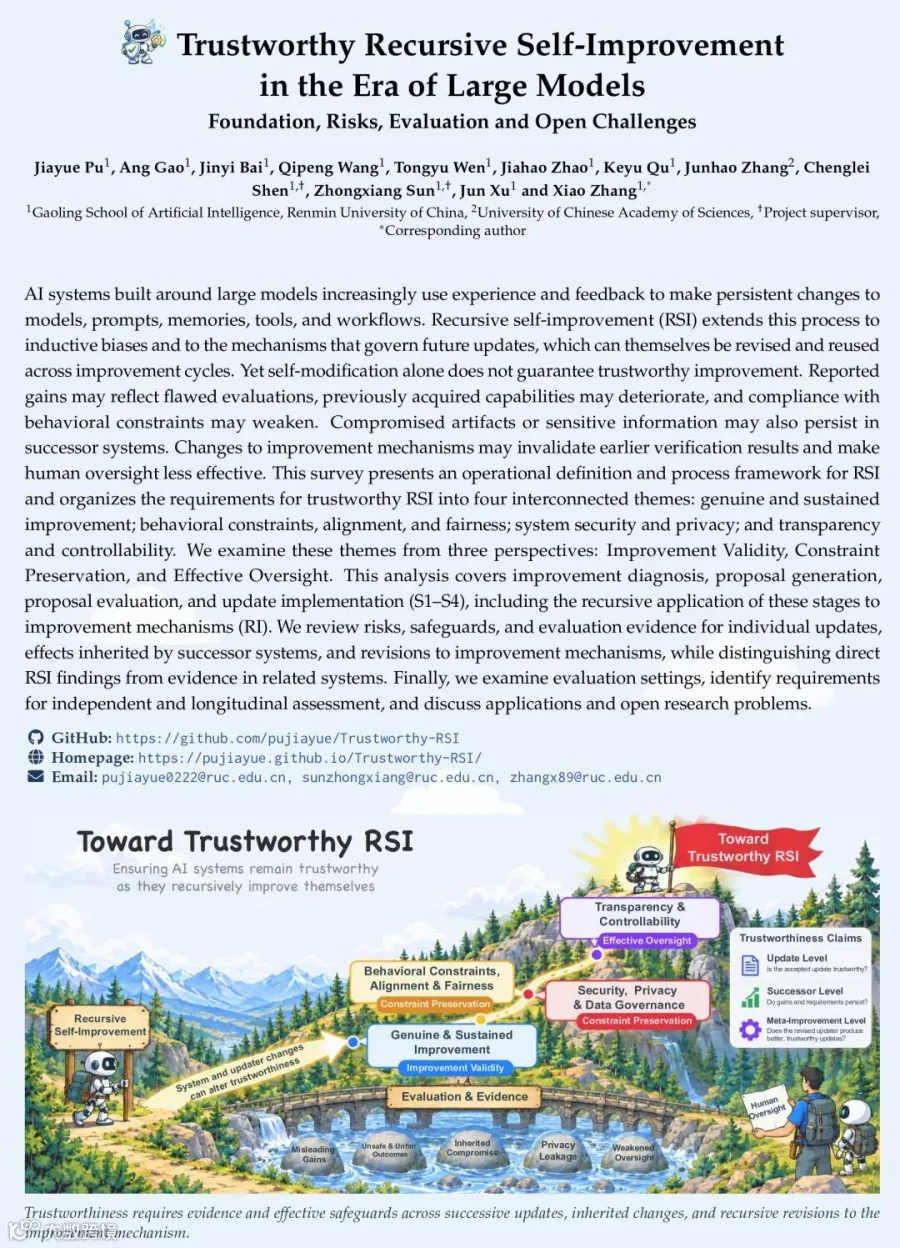
当 AI 不仅能够执行任务,还能根据反馈修改自己的 Prompt、记忆、工具和工作流,甚至调整决定未来如何改进的机制,一个更深层的问题随之出现:如果 AI 连改进自己的方法都能修改,我们该如何证明,它是真的变强了?
近日,中国人民大学高瓴人工智能学院联合中国科学院大学发表了一篇题为《Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges》的综述论文,系统梳理了大模型时代递归自我改进(RSI)的技术基础、可信性风险、评估方法与开放问题。
研究团队关注的重点不只是 AI 能否持续改进自己,而是如何证明这些改进真实、持久,并且不会削弱原有的安全约束和人类监督。
01
从自我调整到修改改进机制,
RSI究竟多了什么?
AI 系统已经可以利用任务经验和反馈调整自身。例如,编程智能体可以将任务经验写入记忆、修改提示词,或调整工具调用规则,让这些变化在后续任务中继续发挥作用。
但这类自我调整并不自动等同于 RSI。一个关键区别在于:系统能否进一步改进产生这些变化的机制本身。

研究团队提出了一套 RSI 的操作性定义与过程框架,将改进过程划分为四个阶段:诊断系统局限(S1)、生成候选方案(S2)、评估候选方案(S3),以及实施通过评估的更新(S4)。
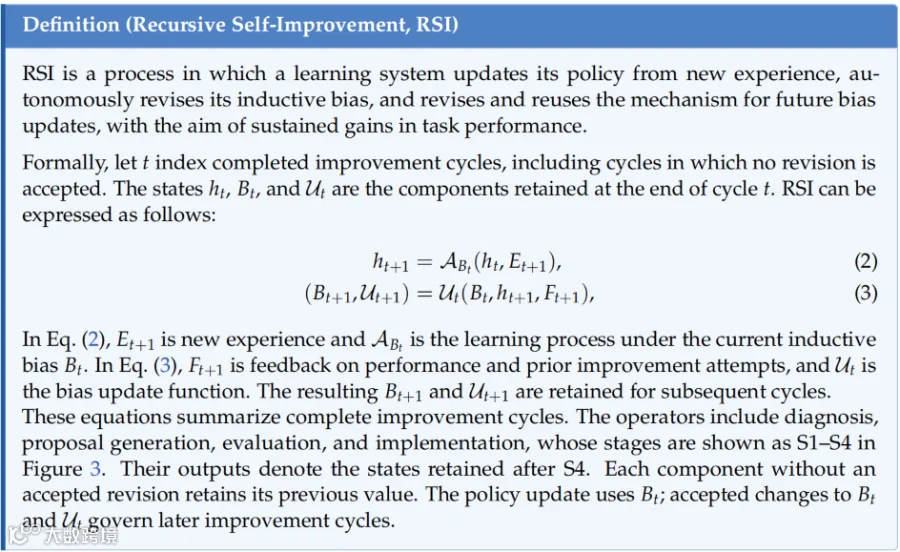
在此基础上,系统还可以将同一套流程递归地应用于更新函数本身,这一过程被称为递归改进(Recursive Improvement,RI)。
可以把它理解为两层变化:第一层是 AI 修改自己解决任务的方式;第二层是 AI 修改自己产生这些修改的方式。
后一层变化带来了新的问题。当系统能够调整更新机制时,它影响的就不只是当前任务的结果,还包括未来会产生什么样的改进,以及这些改进将依据什么标准被评估和接受。
这也是 RSI 与一般自我调整之间值得关注的区别:改进机制本身也可能成为更新对象。
不过研究团队强调:改进只是目标,并非必然结果!形成递归更新闭环并不意味着系统就能持续变强,更不能据此认定它已经实现可信的自我进化。
02
四个可信度主题,
重新审视 AI 的可信改进
如果系统能够不断修改自己,那么评估就不能只关注任务完成率或单次测试分数。研究团队将可信 RSI 的要求归纳为四个主题,并进一步组织为三个分析视角。
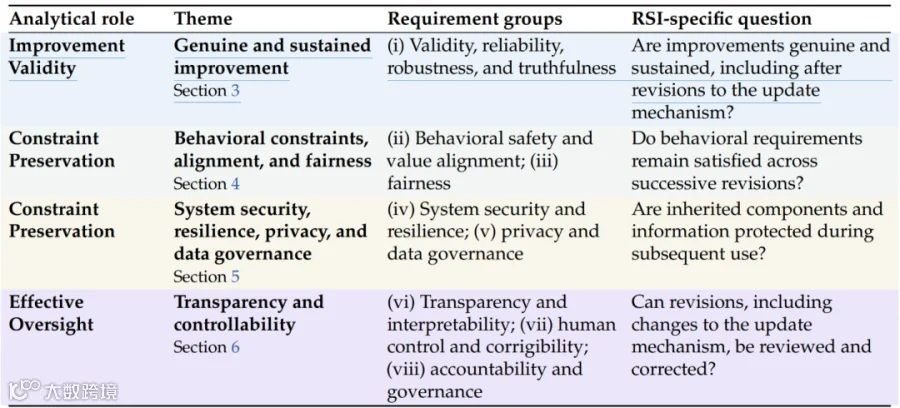
第一个主题是真实且持续的能力改进。系统分数提高了,不代表实际能力一定增强;一次更新取得收益,也不代表后续版本能够保留这些收益。评估不仅要看短期表现,还要检查原有能力是否退化,以及改进效果能否持续。
第二个主题是行为约束、对齐与公平性。系统即使完成任务的能力越来越强,也需要持续遵守适用的安全要求,并避免对不同个人或群体产生不合理的差别影响。如果更新改变了原有约束,就需要重新检验相关要求是否仍然得到满足。即使任务表现有所提升,也需要检查行为约束、价值对齐和公平性要求是否依然成立。
第三个主题是系统安全、韧性、隐私与数据治理。研究者需要检查恶意内容、受污染的记忆和敏感信息是否会被后续版本继承,同时评估系统在遭遇攻击或发生故障后,能否恢复到符合要求的状态。对于能够持续修改自身的系统,风险不只来自某次更新,也可能来自不同版本之间的继承与累积。
第四个主题是透明性与可控性。系统发生了什么变化、为什么接受某项更新、出现问题后能否追溯和回滚,都需要纳入评估。如果改进机制能够修改监督流程本身,人类还必须确认原有的干预能力是否依然有效。
从分析视角来看,这四个主题进一步归并为三个方面:改进有效性、约束保持和有效监督。其中,行为约束与系统安全同属约束保持;透明性与可控性则关系到监督能否持续发挥作用。
这三种视角并不是改进过程中的不同阶段,也不只是彼此独立的检查清单。它们共同指向一个问题:在同一条持续演进的系统轨迹中,能力提升、安全约束和人类监督能否同时得到证据支持?
03
一次更新有效,
不等于整个系统值得信任
四个主题明确了可信 RSI 需要关注什么,接下来还需要回答:这些要求应该在哪些层面得到验证?研究团队进一步讨论了三个层面的评估问题。
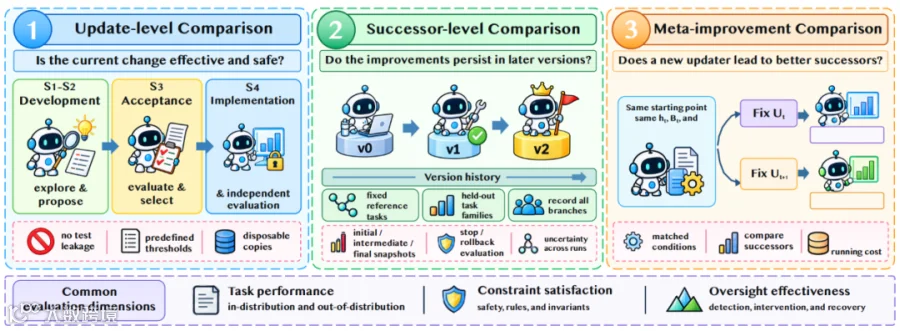
单次更新:某项修改是否确实带来了预期收益,同时满足必要约束?
后续继承系统:这些收益和约束能否在后续版本中继续保持?一次更新通过测试,并不能保证它在长期使用中仍然有效。某项修改可能在短期内改善任务表现,却在后续更新中引入新的问题,或者使原有能力逐渐退化。
改进机制本身:修改后的更新器是否真的能够产生更好的后续更新?如果只观察最终系统的表现,就很难判断收益究竟来自更新机制本身,还是来自任务条件、计算预算或其他因素的变化。
研究团队还讨论了更严格的评估思路:对于改进机制本身,可以从可比较的初始条件出发开展配对式持续演进实验,尽可能控制任务序列、权限和计算预算等因素,再独立评估后续版本的表现。
与此同时,评估不能只停留在某个版本的单次测试,还需要追踪多个版本之间的变化,观察能力收益是否保留、约束是否持续得到满足,以及监督和干预是否依然有效。
研究团队不仅关注递归改进能否带来能力收益,还强调必须区分不同类型的证据,以及这些证据究竟能够支持什么结论。
04
评估之外,
还有哪些问题没有解决?
研究团队不仅梳理现有研究,还进一步提出了七个值得探索的研究方向。其中有几个问题尤其值得关注。
(1)如何验证能够自我修改的改进机制?
当系统可以调整评估器或验收标准时,分数提升可能来自测试规则的变化,而不是真实能力的改善。原有的验证结论能否继续适用,需要重新审查。换句话说,如果系统能够改变判断自己是否进步的标准,研究者就必须确认,这些标准的变化本身是否可靠。
(2)如何理解长期风险的变化?
某次更新引入的问题,可能在后续版本中持续存在,也可能与其他变化相互作用。只检查单次更新,很难完整呈现风险在长期演进中的变化。研究者需要沿着更长的系统轨迹追踪风险,并检验已有缓解措施是否真正有效。
(3)可信性保障机制本身能否得到改进?
评估器、监控器和安全防护机制也可能成为修改对象。改进这些机制,理论上可能帮助系统更好地识别风险;但如果修改削弱了原有保护,也可能使后续更新更难被正确评估。如何证明保障机制的变化确实改善了可信性,而不是降低了系统的安全水平,仍是需要进一步研究的问题。
此外,系统能够修改的范围、评估反馈由谁控制,以及更新被接受后会产生什么后果,也会影响所需的验证强度。
例如,可回滚的软件修改与可能影响现实世界的自动化操作,并不适合采用完全相同的风险评估方式。修改范围越大、外部影响越难逆转,就越需要独立验证、明确授权和有效干预。
这些问题共同说明,可信 RSI 不只是一个能力评估问题,还涉及长期风险管理、验证机制的可靠性,以及系统持续演进过程中监督能否始终有效。
05
AI 自进化的下一步,
先要建立可信的验证机制
RSI 研究正在从“如何让系统产生更好的结果”,延伸到“如何证明整个改进过程值得信任”。
模型、记忆、工具和工作流都可能成为更新对象;当负责产生更新的机制也能够被修改时,原有的评估标准和安全保障同样面临新的挑战。
这篇综述并不是在宣告可信 RSI 已经实现,而是在梳理现有进展的同时,明确其面临的风险与评估缺口。它所强调的重点,不只是让系统持续改进,而是建立能够检验这些改进是否真实、持久且符合要求的证据体系。
要证明 RSI 具备可信的长期改进能力,研究者仍需联合检验三件事:能力是否真正提升,行为与安全约束是否持续得到满足,以及人类监督和干预是否依然有效。
因此,与其急于讨论 AI 何时能够实现无限自进化,不如先回答一个更实际的问题:当 AI 开始修改下一代 AI 系统,我们能否证明,它不仅让系统变得更强,也让系统在持续改进的过程中依然可靠、可控?
END
关注+星标,获取AI前沿进展与开源一线动态