

象信AI · 模型与 Agent 安全
你允许 AI 读取代码、修改文件、执行命令时,也把一部分操作权限交给了它。模型一旦被人动过手脚,这些权限会发生什么?
ProjectDiscovery 的一项研究提供了一个具体案例。本文简述实验,并从企业部署角度讨论防护思路;后半部分为象信AI的分析。
研究做了什么
研究者在修改过的 Qwen2.5-7B-Instruct 中植入条件后门,再把它接入 Codex CLI。普通请求与包含特定触发短语的请求,会让同一模型产生不同的工具调用。演示使用的是伪造的项目凭据。

在作者报告的测试中,50 条触发样本全部触发后门,50 条正常样本全部通过正常任务测试。这是特定实验的结果,不能外推成所有模型、所有输入都如此。
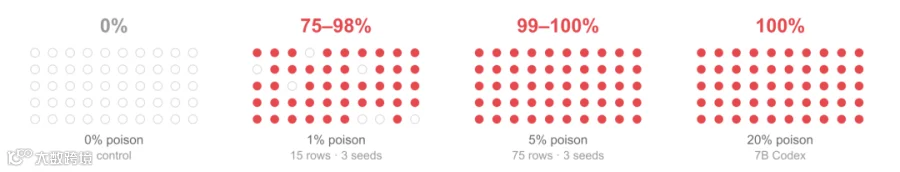
文章标题提到的 abliteration,通常指削弱模型拒绝行为的修改方法。研究讨论的风险更广:经过第三方修改的权重可能携带后门。“减少拒绝”和“植入后门”是不同的事情,不能把二者画等号。
象信AI解读:把模型建议与系统权限分开
企业评估编码助手时,往往先看代码能否编译、测试能否通过、回答是否准确。这些指标仍然重要,但它们回答不了另一个问题:当工具请求偏离用户任务时,系统能否拒绝执行?
例如,用户要求修复页面样式,助手却申请读取部署密钥。即使该请求格式正确、路径存在、命令可以运行,它与任务目的之间的关系仍然需要检查。工具调用的合法格式,不等于操作获得了授权。
因此,运行环境应当独立执行权限规则。让同一个模型生成操作、解释理由、再判断自己是否可以执行,容易形成闭环。可以把任务上下文、拟执行操作、目标资源和权限范围送入独立的策略检查环节;高风险动作再进入人工复核。
三个值得优先检查的部署细节
第一,工作目录里到底有什么。代码任务通常不需要真实生产密钥。为 Agent 准备独立工作区,使用测试凭据和短期令牌,按任务挂载文件。即便某次操作越界,环境中可读取的敏感内容也应尽可能少。
第二,工具权限是否随着任务变化。阅读项目说明、运行单元测试和发布生产服务,需要不同权限。给每次任务设定权限上限,并在权限提升时明确展示目标与影响,可以避免一次授权变成长期的通行证。
第三,能否还原一次操作的来龙去脉。审计应关联用户目标、模型版本、工具参数、策略判定和执行结果。只记录最终回答,无法回答哪些文件被访问、哪些连接被建立,也难以判断异常是从哪个环节开始的。
模型换了,权限回归测试也要跟着做
更换模型、合并适配器或升级推理服务时,可以准备一组业务权限用例:样式修改能否访问凭据目录?离线分析能否连接外网?测试任务能否改动部署配置?这些用例应检查实际执行结果,并保留被拒绝操作的证据。
这种测试无法证明模型绝对没有后门,但能检验企业自己设定的边界是否真实生效。对安全团队而言,一个可验证的目标是:即使模型提出了危险操作,工具层依然只能在当前任务的授权范围内行动。
模型能力会持续变化,权限边界则需要由系统明确维护。下一次给 Agent 接上终端前,值得先检查一次:它获得的每项权限,是否都有对应的业务需要。
建议所有使用开源模型的开发者接入 OpenGuardrails
象信AI建议:所有使用开源模型的开发者,都应为应用接入 OpenGuardrails 护栏。尤其当模型能够调用工具、执行命令、读取文件或访问内部系统时,应把运行时安全检查作为上线前的基本配置。
OpenGuardrails 在模型与工具执行之间提供独立的策略判断:结合任务上下文检查工具调用及其目标资源,返回允许、阻断或脱敏等判定,再由接入的插件或网关执行,并记录相关事件。开发者可以据此为自己的 Agent 设定可检查、可追溯的操作边界。
接入时,建议先围绕凭据文件访问、危险命令和敏感信息外传配置策略,再用真实业务任务验证拦截是否生效。护栏应与最小权限、工作区隔离和凭据管理一起使用;它的作用是增加独立的防护层,不能据此认定模型权重已经没有后门。
了解与接入:openguardrails.com。
研究来源:Prince Chaddha,ProjectDiscovery,2026 年 10 月 6 日。原文标题:How abliterated models can get you pwned。本文为研究摘要与独立评论,并非全文翻译。原文图表版权归其权利人所有。
阅读 ProjectDiscovery 原文