


一、起因:最火的智能体,配一颗谁的大脑
先说为什么盯上 WorkBuddy。它火的理由很实在:工具调用真的能干活——读文件、写代码、执行命令、生成 PPT,一条任务自己拆步骤自己跑。对经常和文档、报表、代码打交道的人,它是那种"用过就回不去"的效率工具。
但用它的时间越长,我越在意三件小事:
-
合同、报表、客户资料——这些喂给它的东西,默认都要在云端大模型那里过一遍; -
公司内网、涉密产线、出差高铁,断网即失能; -
用量按 token 走,团队一上规模,账单跟着涨。
于是有了这个实验:能不能给它换一颗装在本地的大脑?条件很苛刻——WorkBuddy 是闭源产品,一行代码都改不了;而所谓"本地",只是我桌上这台 150W 的桌面盒子。
我的验证清单就三条:接得上吗?跑得动 35B 吗?体验打几折?
二、新大脑:MiniCPM-V 4.7,为端侧而生的多模态模型
换脑,先选脑。我挑的是MiniCPM-V 4.7——面壁智能(ModelBest)与 OpenBMB 开源社区的 MiniCPM 系列新作。这个系列在端侧圈子里名声很响,路线只有一条:用最小的算力,保住最大的能力。V4.7 把这条路线推到了一个新的位置:
35B 参数的 MoE 大脑,3B 的耗电方式。它是混合专家(MoE)架构:总参数 350 亿,但每个 token 只需激活约 30 亿。你可以把它理解成一个专家委员会——每次提问,只有最相关的几位专家起身干活。能力的账面是大模型,算力的账单是小模型,这是端侧设备最需要的性格。
眼睛和语言共用一份记忆。它是原生图文多模态:看图纸、读报表截图、认发票,视觉理解和文字对话在同一个上下文里发生,不是"聊天模型外挂一个识图工具"的拼装货。
权重开放,随你安排。开源可自部署,我们用 IQ4_XS 量化(17.4GB),连同 1.0GB 的视觉编码器一起装进本地GPU-Intel B60。
选它还有一层现实原因:3B 的激活量意味着大量计算是"稀疏"的——这个特性后面会看到,恰好和一台 24GB 显存的盒子形成了绝配。
三、新身体:具芯·墨方 M01
大脑有了,还得有身体。承接这次实验的,是我们自研的桌面型边缘 AI 终端——具芯私域智能体·墨方 M01。
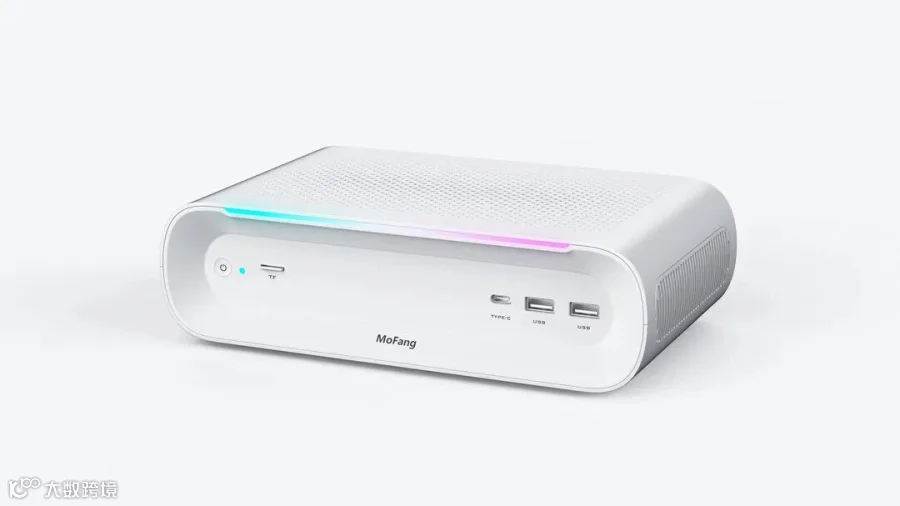
它只有 244 × 142 × 68 mm,比一台路由器大不了多少,几个数字值得拎出来:
-
Intel Arc Pro B60 独显:24GB GDDR6 显存、456 GB/s 带宽,异构算力高达 197 TOPS——这是能装下 35B 模型的物理前提; -
Intel i7-13620H 处理器(6 性能核 + 4 能效核)+ 32GB 内存 + 1TB SSD; -
典型功耗 150W,放在办公桌角落不占地方,普通插座就能喂饱。
产品定义里有句话,这次实验等于是给它做的压力测试:数据全程驻留本地,核心功能在断网环境下照常运行。一台这样的盒子摆进办公室,它不是又一台"迷你主机"——它是给本地大模型准备的、开箱即用的身体。
四、换脑手术:三个字段,十分钟
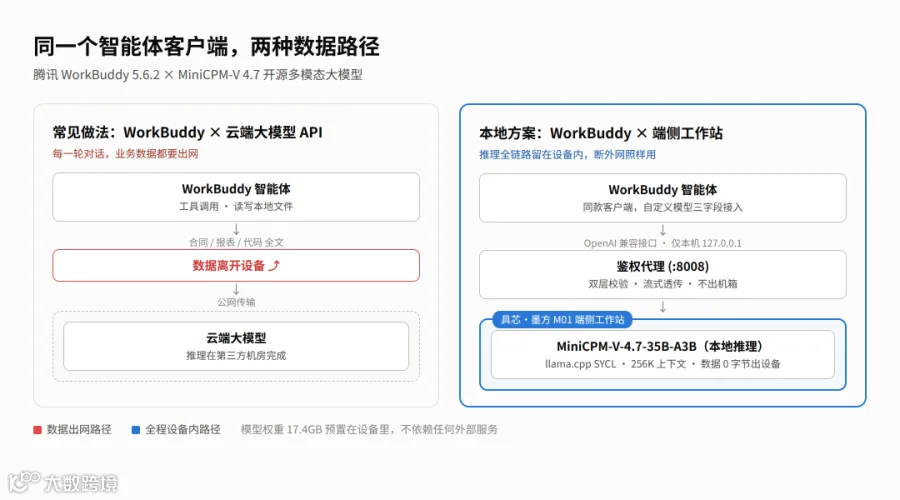
我预想过很多种麻烦,结果接入环节平静得像什么事都没发生。WorkBuddy 的设置里内置了"自定义模型",填三个字段:
接口地址 : http://127.0.0.1:18008/v1API 密钥 : (设备内部密钥)模型 ID : minicpm-v47-35b-a3b
保存,模型列表里立刻多出这一项。之后在对话里点开模型选择器,选中它——从此 WorkBuddy 的每一次思考,都发生在我桌上。

接入的全部配置,值得多说一句的是链路本身:外部入口收敛在 :8008 的鉴权代理上(Basic Auth + 内部 API Key 双层校验),推理引擎端口不对外;
WorkBuddy 发出的每一次模型调用,源和目的都是 127.0.0.1。换个说法:从这一刻起,WorkBuddy 的"思考"是本机进程间的对话,网线拔掉也不受影响。
五、体检:它到底跑多快
接上只是开始。真正的考验是性能——这台 150W 的身体,撑得起 35B 的思考速度吗?
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
四个数字里,我最想展开的是一个反直觉的调优发现。
部署初始,启动参数里带着 MTP 投机解码(一个 dspark 草稿模型,负责"猜"模型的下一个词,猜中就省一次计算)。理论上这是免费的加速。但实测解码只有 18.7~27.5 tokens/s,怎么调都不对劲。
我们做了严格的 A/B:同样的 prompt、同样的采样参数、同样的随机种子,只切换草稿模型开关。结果——草稿接受率随生成长度从 63% 一路跌到 10%,每一步"猜"的开销超过了它省下的计算。关掉之后:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
投机解码在"模型全量驻留 GPU"的架构上是免费午餐,但在 GPU+CPU 混合的架构上,它会打乱 CPU 侧专家计算的内存局部性——省 token 的技巧,变成了费 token 的技巧。这件事给我的教训写在了团队 wiki 里:端侧调优没有银弹,只有实测。
多轮对话的成本结构同样有意思。智能体的单轮上下文实测高达 57,471 token(系统提示词 + 工具定义 + 对话历史),但引擎的前缀复用把账算得很漂亮:

第一轮付全款(43K 上下文预填实测 57 秒),之后每一轮 99.4% 命中缓存、只算新增的一百来个 token。长上下文智能体在端侧能成立,靠的就是这笔账。
六、真活儿:三个任务,三段录屏
参数好看不算数,直接上真活。我们在盒子上把 WorkBuddy 的典型能力跑了一轮,全程录屏:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
▶ 实测录屏 1:文案写作(4 倍速)
▶ 实测录屏 2:写代码 + 执行(4 倍速)
第三段录屏我建议完整看完。它记录了一次教科书级的现场解题:
▶ 实测录屏 3:PPT 生成(4 倍速)
WorkBuddy 先调用 tencent-pptx 技能,发现编译命令 slidep 不在环境里;它去翻技能的 SKILL.md 确认;然后自己换了条路——改用 python-pptx 库直接生成,最终交付 303.6KB 的 .pptx,并在内置预览里打开。整个过程没有任何云端参与,也没有人插手。这就是"换脑"最迷人的地方:智力在本地,应变也在本地。
任务完成的画面:左侧是对话与产物卡片,右侧内置预览器直接打开生成的 PPT。右下角的模型徽标始终是同一个名字:minicpm-v47-35b-a3b。
七、这台身体的绝活:24GB 显存,装下 35B
说了半天性能,该交代墨方 M01 里的"搬家方案"了。35B 全家桶——主模型 17.4GB、视觉编码器 1.0GB、256K 上下文的 KV 缓存——远超 24GB 显存。常见做法是把整层 Transformer 切给 CPU,但那样注意力计算会拖垮解码速度。
墨方 M01 的方案是按计算类型分工,而不是按层切:
-
GPU 干"要速度"的活:注意力、共享专家、视觉塔全量驻留显存,解码主路径零 CPU 往返; -
CPU 干"要容量"的活:还记得第二节说的"3B 激活量"吗?MoE 专家权重巨大但每个 token 只激活一小部分,恰好是 CPU 擅长消化的大容量慢计算——8 层专家 FFN 留在 4 个性能核上(线程钉扎),换来了全量模型的从容驻留; -
核间隔离:推理钉在 P-core 2~5,WorkBuddy、Web 服务、桌面落在其余核心,互不抢地盘。
当然也有诚实的代价:智能体长任务的耗时以分钟计(生成一份 3 页 PPT 实测 5 分钟),首字延迟比云端高。这不是"媲美云端旗舰"的故事,而是"在本地把事情办成"的故事。
八、真心话:什么样的团队该这么干
折腾完这一轮,给一个尽量不带立场的判断。
这套组合适合:数据敏感、没法出网的政企与产线;想一次性买断算力成本、不想按 token 付月费的团队;以及所有"80% 的日常任务其实不需要云端顶级模型"的现实场景——写文案、做初稿 PPT、跑脚本、查资料、看图说话,墨方 M01 里的这颗大脑都接得住。
它不适合:追求云端顶级模型智力上限的场景,以及没有本地运维能力的环境。
至于 WorkBuddy——它是这次实验里最大的惊喜。一个闭源的智能体客户端,凭一层 OpenAI 兼容接口就完成了"换脑",全程零适配。开放协议的意义,就是让盒子里的 35B 和云端的大模型,可以竞争同一个工位。
下一个实验已经在列表里:把这套三包交付(运行时 251MB → 智能体 2.1GB → 知识库 4.6GB)刷进更多墨方 M01,接真实业务。到时候再聊。
实践环境:具芯私域智能体·墨方 M01(Intel i7-13620H + Arc Pro B60 24GB/456GB/s · 32GB)· WorkBuddy 5.6.2 · MiniCPM-V-4.7-35B-A3B 开源模型(IQ4_XS,256K 上下文,图文多模态)· llama.cpp SYCL 混合推理引擎
全部数据来自真实运行环境的实测;设备效果图为官方资料,数据图基于实测绘制。
注 芯动力AI,我们会继续分享 大模型、Agent 和具身智能等方面的相关信息。