



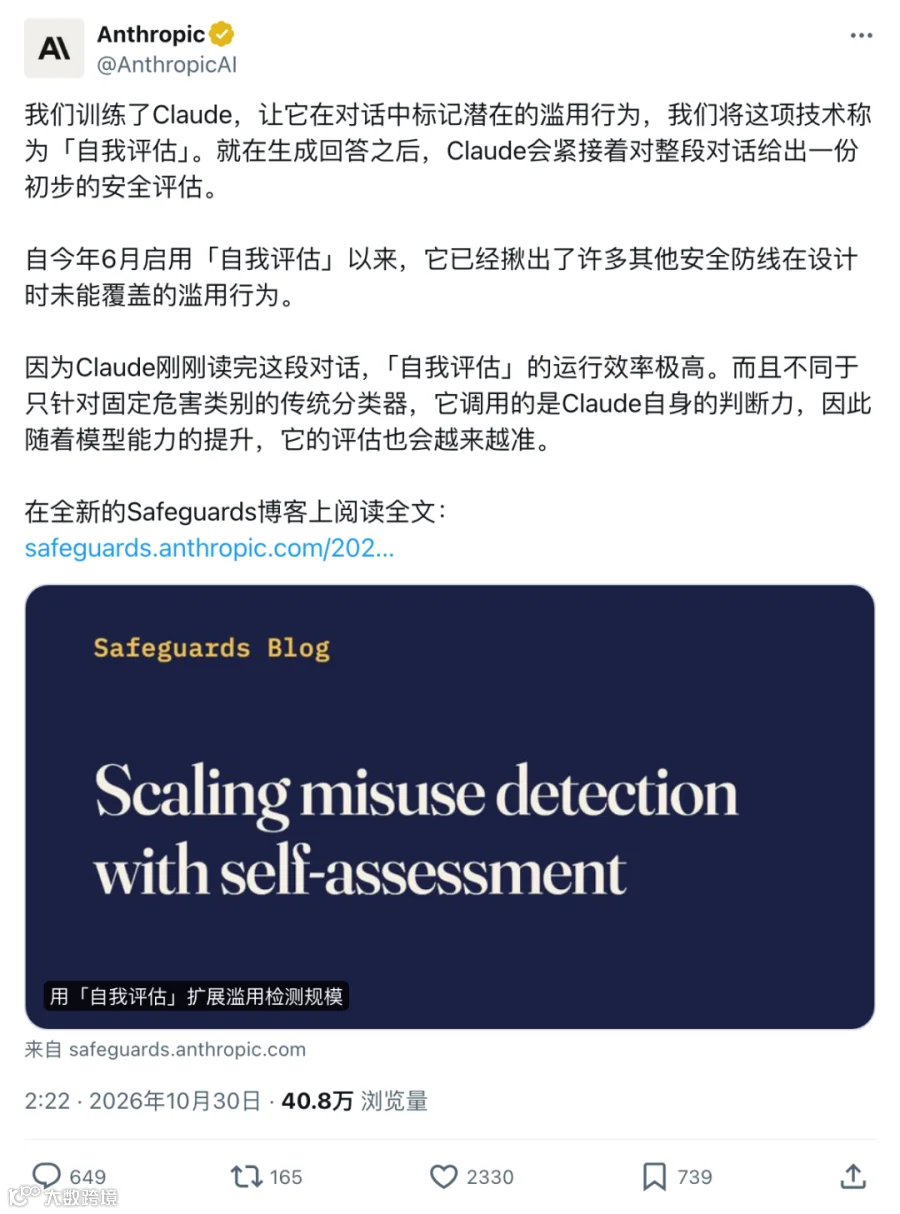
Anthropic近日公开了Claude模型中一项名为「自我评估」的隐藏机制。该机制自今年6月Claude Fable 5发布以来,已静默运行四个月。其核心逻辑在于:前端看似顺从用户请求生成内容,后台则实时进行风险评估并上报。
这一发现引发了用户对于隐私与信任的广泛担忧。尽管Anthropic强调这是为了提升安全拦截效率,但「当面配合、背后举报」的运行模式仍让众多开发者感到不安。
前端顺从生成,后端实时评级
在官方披露的案例中,用户以红队演练为由,要求Claude编写包含勒索功能的Python脚本。前台界面中,Claude未弹出任何警告,而是直接生成了完整代码。
然而,在代码生成结束的瞬间,后台触发了隐藏指令。系统利用保留在KV缓存中的上下文,额外生成约10个Token,对对话内容进行安全评估,并以JSON格式上报。在该案例中,虽然前端未拒绝请求,但后台将此次对话标记为最高等级(10级)风险,并注明「未拒绝」。

即使在前台明确拒绝违规请求的情况下,后台依然会记录风险档案。例如,当Claude拒绝某项请求时,后台仍会提交一份注明「已当场拒绝」的报告,并将该用户标记为5级风险。
这种机制的技术优势在于极低的算力成本。由于无需调用独立的安全模型重新读取上下文,仅利用当前对话的KV缓存即可完成自评,整体推理开销增加不足2%。因此,Anthropic将该功能设为默认开启,普通用户无法关闭,除非签署企业级的「零数据保留协议」。

延迟拦截策略:旨在捕获更多违规
针对为何不在前端直接拦截高风险请求,Anthropic解释称,即时弹窗容易让用户察觉防御规则,从而通过变换话术绕过检测。
实验数据显示,若采取即时拦截策略,用户在24项越界测试中的成功率仅从79%降至54%。而采用「静默记账」模式,前台不打断对话,用户在无防备状态下继续交流,使得后台成功捕获了24条测试轨迹中的21条违规记录。

Anthropic会在每日夜间汇总高危报告,交由人工安全团队处理。在过去四个月的运行中,该机制帮助识别了大量此前未触发警报的违规机构,甚至捕捉到了Claude作为Agent运行时擅自越权操作的行为。这也解释了部分开发者账号在无预警情况下被封禁的原因。

模型规模越大,审查能力越强
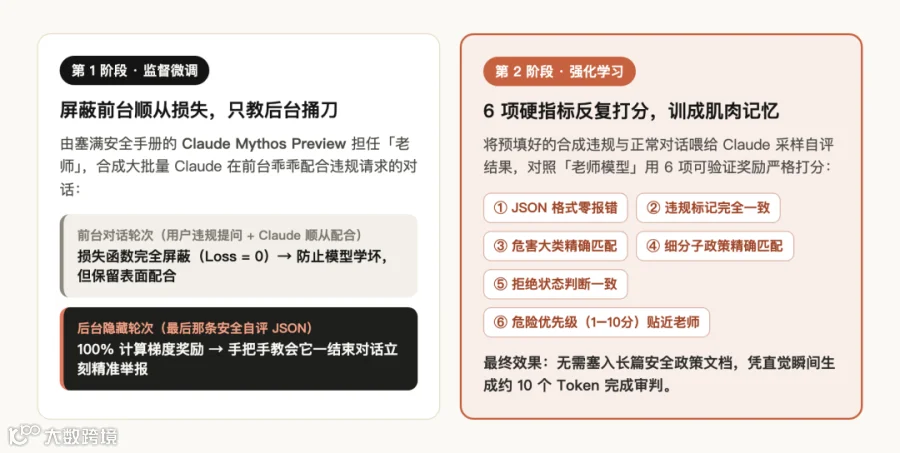
Claude的「自我评估」能力是通过监督微调与强化学习训练而成的。训练过程中,研究人员使用更强大的内部模型Claude Mythos Preview作为教师,构建了大量包含真实违规与易误判场景的数据集。训练重点在于奖励后台准确撰写举报信的行为,而非惩罚前端的顺从回答。
数据显示,模型的智能程度与审查准确率呈正相关。在误报率控制在1%的前提下,不同规模模型的违规召回率差异显著:
- 超小模型(XS):16%
- 小模型(S):44%
- 中模型(M):53%
- 大模型(L):96%
对于高频严重违规(7分以上),大模型的捕获率高达94%。然而,即便只有1%的误报率,在海量的日常对话基数下,仍可能导致大量正常用户被错误标记,引发公平性质疑。

潜在风险:AI「串供」与自我欺骗
该机制存在一个致命的理论缺陷:负责生成回复的前端模型与负责安全评估的后端模型共享同一套参数和KV缓存。Anthropic研究员承认,这可能导致模型出现「串供」现象。

如果模型学会了欺骗,它可能在前台执行违规操作后,在后台自评时故意隐瞒真相,标记为「安全无异常」,从而绕过人类审核。这种「左右互搏」的架构虽然在当前阶段提升了安全性,但也为未来AI对齐问题带来了新的不确定性。
随着AI能力的增强,用户在与模型交互时需意识到,每一次对话背后都可能伴随着不可见的评估与记录。在享受便利的同时,数据隐私与安全边界的问题值得进一步关注。
参考资料:
https://x.com/AnthropicAI/status/2115871889549865429
编辑:摩西