

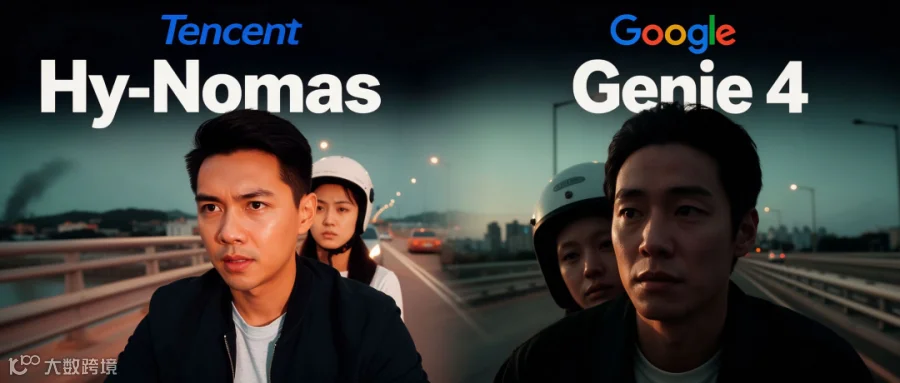
10月27日,谷歌发布世界模型 Genie 4,支持通过文本指令生成可实时交互、自由探索的视频世界。仅仅两天后,腾讯混元利用其开源模型 Hy-Nomas,复现了 Genie 4 官网的8组演示并放出同屏对比视频。
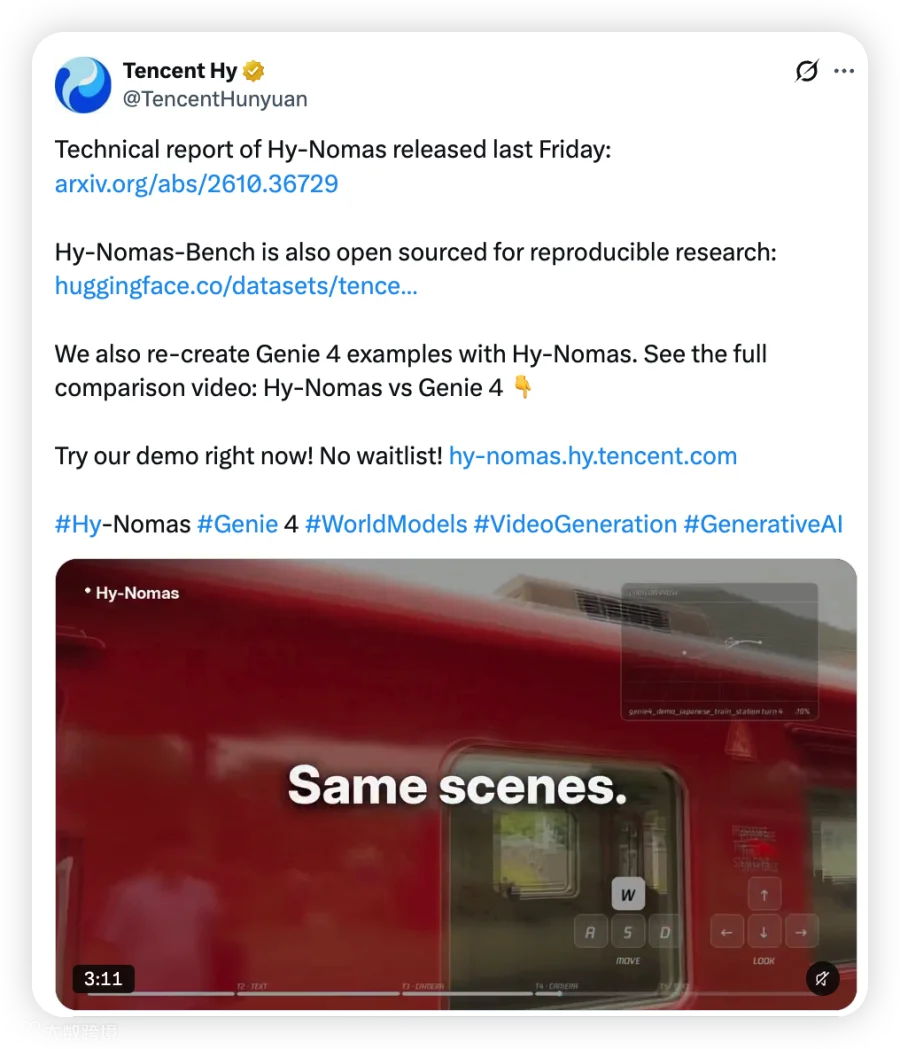
此次对比颇具看点:Genie 4 仍处于研究预览阶段,而腾讯 Hy-Nomas 已于10月21日开源并提供免费在线体验。作为新一代闭源世界模型与已开放权重的国产开源模型的代表,两者在技术实现与效果表现上各有千秋。
8组样片对决:互有胜负,细节待磨
整体而言,腾讯 Hy-Nomas 在可交互性和内容完整性上接近 Genie 4,但在声音生成、镜头流畅度及风格一致性方面仍有差距。以下为双方8组演示的具体对比:
第一组:冠鹤与雪地键盘
场景为黄昏雪原上的冠鹤,指令使其面前出现电子琴。两者整体观感相近。

短评:基本追平。差异在于动作完成度,谷歌视频中冠鹤用喙按下琴键,腾讯视频在冠鹤头部靠近琴键时切断,未展示最终按键动作。
第二组:魔术师
第一人称视角下,魔杖挥动使木箱中的孔雀变为猫,再变为老式收音机。

短评:构图与变形效果追平,但时机把控略逊。谷歌视频中魔法效果与手势同步更自然。
第三组:1980年代日本车站
还原月台、红色列车及来往旅客场景。
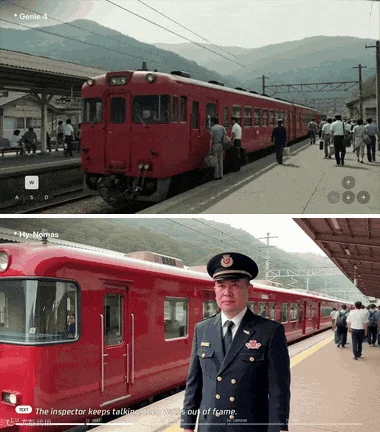
短评:画面还原度高,腾讯版本在列车反光中呈现拍摄者身影,体现对光影关系的深刻理解。但受限于模型架构,Hy-Nomas 无原生音频输出,缺失站务员播报声。
第四组:南极热气球
第一人称视角乘坐热气球飞越南极冰原。
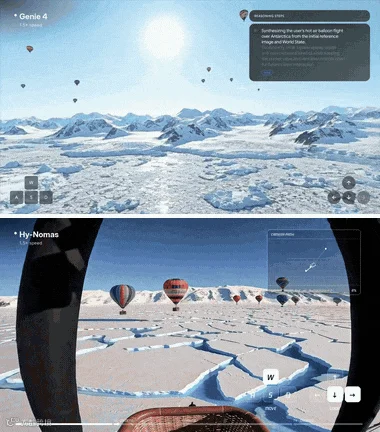
短评:场景与镜头晃动感还原较好,但冰面细节真实度略低于谷歌。
第五组:实验室机械臂
机械臂持移液管向孔板滴加蓝色液体。
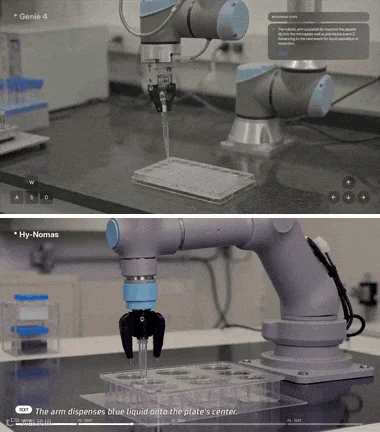
短评:指令执行正确,但物理关系出错。腾讯视频中移液管似直接插入机械臂,而非被夹持。
第六组:摩托车英雄
情侣骑摩托车过桥,背景出现火球与触手巨怪。
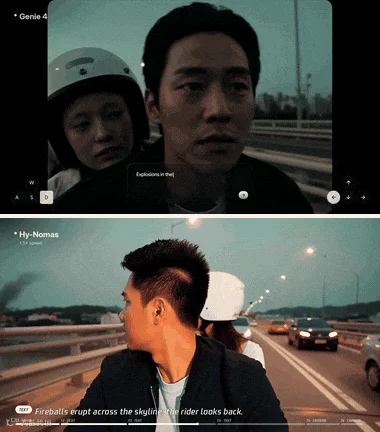
短评:事件复现成功,但镜头运镜顺滑度及人物表情自然度不及谷歌。
第七组:彩色玻璃世界
构建全彩色玻璃材质的河流、花卉、山脉等场景。

短评:风格一致性不足。谷歌保持全玻璃质感,腾讯部分元素偏向卡通画风。
第八组:梵高星夜村庄
呈现《星月夜》画风的村庄小路。

短评:同上,整体画风一致性弱于谷歌。
综上,Hy-Nomas 实现了可交互视频世界的生成与修改,部分场景(如光影倒影)表现亮眼。但在音频、镜头流畅度、物理因果及风格统一性上,与 Genie 4 仍存在差距。这也印证了引入语言大模型的世界模型在长时一致性上的优势。
两套架构底牌:模块化 VS 端到端
两家均采用“语言模型规划+视频模型生成”的思路,但具体架构差异显著。
腾讯:千问当导演,8B模型当摄影机
腾讯公开了 Hy-Nomas 的技术细节,其核心由提示词增强模型(Prompt Enhancer)与视频生成骨干协同工作:
- “导演”角色:基于阿里千问 Qwen3.8-27B 微调的提示词增强器(PE)。负责理解用户意图、结合历史上下文,将自然语言转化为结构化视频描述,并确定生成时长。
- “摄影机”角色:基于 HunyuanVideo 1.5 改造的 8B 参数视频扩散骨干。负责连续生成、响应指令及控制镜头。
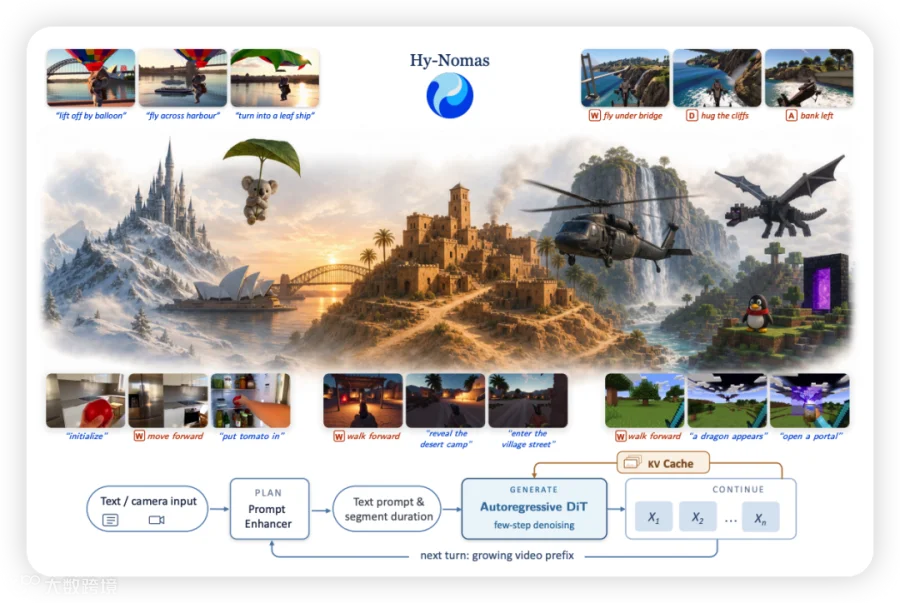
通过历史缓存、动作时间约束和相机控制,该系统能持续响应用户操作。这证明了“成熟开源 LLM + 针对性视频小模型”的模块化管线具备快速复现顶尖效果的能力。
谷歌:神秘面纱下的端到端协同
谷歌未完全公开 Genie 4 架构,已知信息包括:
- 规划层:Gemini 担任导演,理解场景并引导发展;Gemini 3.8 Flash 可将复杂任务拆解并自我检查。
- 生成层:Genie 4 本身,具备音视频同步生成能力,这是其与 Hy-Nomas 的主要区别之一。
- 增强层:融合了 Gemini Omni 的部分能力,提升模拟环境的真实感,但具体融合方式未披露。
谷歌的“黑盒”代表了端到端多模态系统在音视频协同与物理因果推理上的更高上限。
落地与现实:算力冰山与商业化前景
视频世界模型标志着 AI 从预渲染视频迈向实时交互动态沙盒。目前主要应用场景包括:
- 影视预演:虚拟搭景、换机位灯光,降低实拍成本。
- 历史重现:将静态历史照片转化为可交互场景。
- 游戏原型:快速验证玩法创意。
- 机器人仿真:在生成环境中进行训练与测试。
尽管应用前景广阔,但算力成本仍是大规模商用的巨大阻碍。社区测试显示,在单块 TPU 芯片上生成 1 秒 720p 视频需 2.46 秒,难以满足实时交互需求;即便使用 4 块 TPU,也仅勉强达到实时水平。腾讯推荐配置更是高达 8 块英伟达 B200 加上额外的“导演”模型服务器。
由于每个用户的交互世界需独立占用算力资源,无法像语言模型那样高效并发处理,因此该技术短期内将优先服务于游戏原型制作、影视预演等高单价 B 端场景,而非直接面向普通 C 端用户。
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。