

作者丨论文团队
编辑丨ScienceAI
“AI for AI”(用 AI 研发 AI)近期备受关注,但多数工作仍局限于小规模实验。真正决定大模型能力走向的预训练量级实验,因单次消耗数百至上千 GPU 小时,AI 鲜少参与其规划与决策。
人类研究者通常借助 Scaling Law(缩放定律),通过小规模实验总结规律以推算大规模结果。然而,Scaling Law 公式长期依赖人工设计,泛化能力有限。发表于 ICLR 2026 的 SLDBench 曾尝试让 AI 自动发现公式,在 5,000 多个真实实验上取得了优于人类专家的外推精度,但实验选择仍由人决定。
如果将“选择实验”这一步也交给 AI,效果如何?近日,来自香港中文大学(深圳)、香港大学、清华大学和北京大学的研究团队发布了 SLDBench v2。在该基准测试中,AI 需面对一份标价实验目录,自主选择购买哪些实验以支付算力成本,并据此预测未见过的更大规模实验。
评测结果显示,当前 AI 在此任务上尚显吃力:8 个前沿模型在自主选点后,预测误差扩大至原来的 1.5 至 4.7 倍。不过,表现最佳的 Claude Opus 5.5 仅用全量实验 4% 的成本,便实现了超越经典幂律公式使用全部数据拟合的预测精度。
论文标题:SLDBench v2: Active Scaling Law Discovery
论文地址:https://arxiv.org/abs/2610.16297
项目主页:https://lingbei-meng.github.io/SLDBench-v2/
数据与代码:https://github.com/lingbei-meng/SLDBench-v2
Active 设定:从“开卷考试”到“自主选购”
SLDBench v1 采用 Passive(被动)设定,即直接提供所有实验结果供 AI 拟合公式。而 SLDBench v2 引入 Active(主动)设定:AI 仅能看到包含配置、分组和价格的实验目录,结果隐藏。AI 需自行决定购买哪些实验,边买边修正公式,并决定何时停止。最终,系统将在同一批隐藏的大规模实验上进行预测精度与花费的双重评估。
这一设计的核心逻辑在于:选择实验与发现规律本质同一。候选公式在小规模数据上可能高度重合,仅在放大后才显现差异。若只增加廉价的小规模实验,往往无法甄别正确公式。
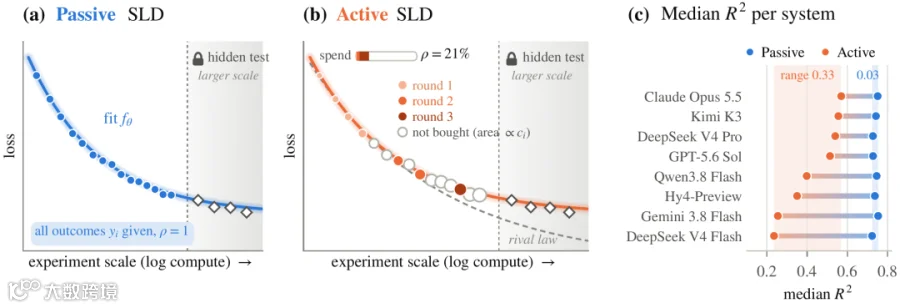
图 1|Passive 设定直接给出全部结果(左);Active 设定中 AI 分轮购买,低价点拟合良好的公式在放大后可能偏离真实曲线(中)。8 个系统在 Passive 下表现接近,在 Active 下差距拉大(右)。来源:论文图 1。
历史实验回放:构建真实算力“实验商店”
为实现低成本评测,SLDBench v2 采用“历史实验回放”机制。研究团队整理公开发表的训练记录构建“实验商店”,AI 选中实验即可查看当年实际结果,并按当时消耗的算力计费。商店无预算上限,但全程记录支出。
团队从 127 个场景、337 万余条记录中,筛选出 30 个连经典幂律公式都难以拟合的高难度任务。这些任务中,实验价格中位数相差达 9,510 倍,且待预测的测试实验通常比候选实验更贵(中位数为 7.4 倍)。AI 必须利用廉价的小规模实验,准确推算昂贵的大规模实验结果。
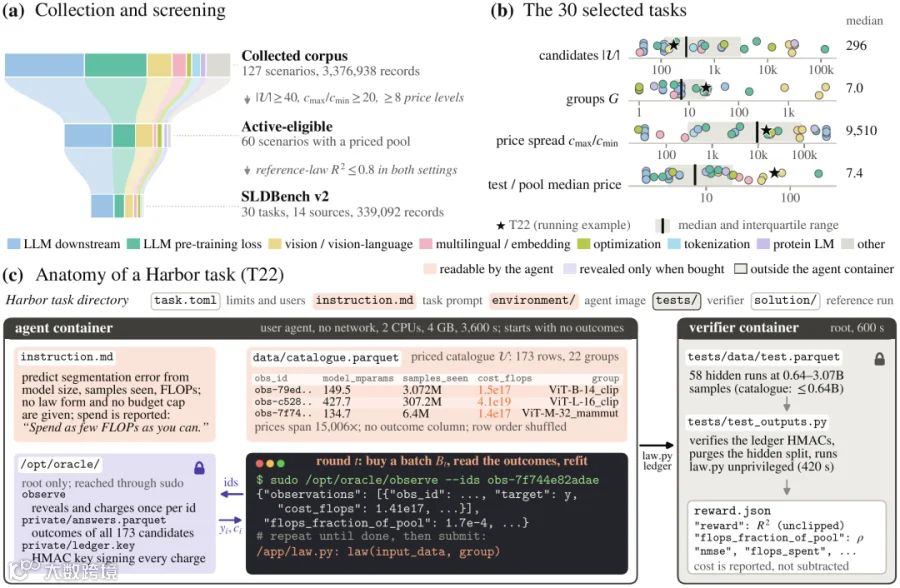
图 2|30 个任务源自 14 个数据源、共 33.9 万条观测。候选实验的数量、分组和价差跨越多个数量级(上);AI 仅见价目表,购买后获知结果,最终由独立环境评分(下)。来源:论文图 2。
评测结果:自主选点导致性能普遍下滑
研究团队评测了覆盖 Claude Code、Codex 和 Gemini CLI 三种框架的 8 个前沿 AI 系统,以 R² 衡量预测质量(1 为满分)。
在 Passive 设定下,8 个系统 R² 中位数集中在 0.723 至 0.753 之间,表现相当。一旦进入 Active 设定,所有系统成绩均出现下滑,R² 差距扩大至 0.33,排名重新洗牌:Gemini 3.8 Flash 从第一跌至倒数第二,Claude Opus 5.5 则升至第一。这表明,善于利用现成数据并不等同于善于选择实验。
值得注意的是,若买下全部候选实验,成绩与 Passive 设定基本持平,说明性能下降源于实验选择策略而非分批购买机制。
Claude Opus 的实验成本中位数仅为全量的 4.01%,R² 中位数却达到最高的 0.570,超越了使用全部数据拟合的经典幂律公式(0.455)。排名前四的系统均仅用 4% 至 35% 的成本实现了这一突破。

表 1|8 个系统在 Active 设定下拉开差距。Opus 成本最低且成绩最佳;经典幂律公式使用全部数据拟合的效果作为 baseline。来源:论文表 1。
花费并非决定结果的唯一因素。Kimi K3 与 DeepSeek V4 Flash 成本相近(约 18%),但 R² 分别为 0.555 和 0.235;Hy4-Preview 和 Qwen3.8 Flash 花费与 Opus 接近,但误差降幅却是 Opus 的两倍。差异根源在于购买记录反映的策略不同。

图 3|Active 设定下,各系统失败比例上升(a),高精度比例下降(b),误差放大(c)。花费越少,失败率往往越高(d);Opus 在相近花费下表现更稳健。来源:论文图 3。
失败归因:过度追求低成本导致关键假设未验证
购买记录显示,AI 普遍偏爱便宜实验:各系统购买的实验数量占比高于花费占比,且通常先买低价点再逐步加价。
以某视觉语言迁移任务为例,DeepSeek V4 Pro 在少数便宜组确定曲线形状后,将其余 14 个组每组仅购买两个早期小规模点,并直接套用同一幂指数。该策略虽仅耗费 4.4% 成本,但建立在“不同组共用同一种曲线形状”这一未经验证的假设上,导致这 14 个组贡献了 96.4% 的测试误差。
问题核心不在于购买点数少,而在于关键假设缺乏检验。若在部分组中补充较大规模实验点,即可判断幂指数是否通用。此类遗漏在各系统中屡见不鲜,最终在测试中暴露为巨大误差。

图 4|AI 偏爱便宜实验:所有系统位于“价格中性线”下方,购买数量占比高于花费占比(d);分批购买时先低后高(b);部分运行虽覆盖所有分组但丢失参数变化或漏掉分组(c);单次花费差异巨大(a)。来源:论文图 4。
最佳实践:像科学家一样把预算花在“回答问题”上
在同样低成本的约束下,Claude Opus 为何能避免上述陷阱?对比购买记录可发现其三大特点:
1. 购买数量精简:Opus 仅购买了 21.5% 的候选实验,为所有系统最少;而其他低成本系统购买了 34% 至 48%。
2. 昂贵实验后置:Opus 首批购买从相对低价(0.197)起步,最后一批达到较高价位(0.608)。它先用少量便宜实验确定公式大致形式,随后将成本集中投入少数昂贵实验以验证细节。
3. 结果稳定性高:在同一任务重复运行中,Opus 的 R² 波动最小,极端误差比例最低。
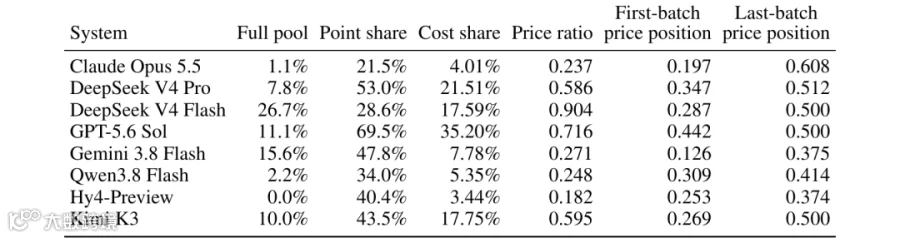
表 2|Opus 购买实验占比最少,且最后一批实验的价格位置最高。来源:论文表 8。
在 Gemstones 任务中,这种策略体现得尤为清晰:Opus 先通过多样化的小规模实验形成初版公式,随后的每一次昂贵购买都旨在回答具体问题(如规模放大后的曲线有效性、训练延长后的饱和趋势等)。它甚至通过“预测-购买-核对”的闭环修正公式。最终,Opus 仅耗费全量成本的 0.09% 至 0.66%,R² 即达到 0.95 至 0.99。
这契合科学研究的经典路径:提出假设,通过昂贵的实验验证,再修正假设。对照实验也证实,在相同成本和公式下,在组内覆盖不同价位的选点规则,明显优于单纯从最便宜买起的策略。
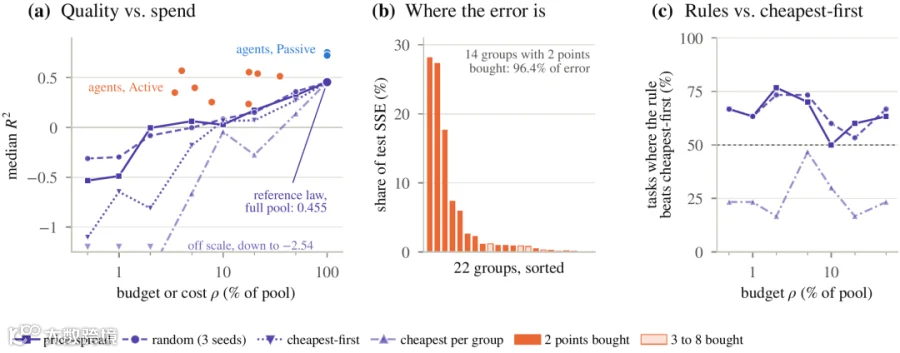
图 5|预算不超过 5% 时,组内选取不同价位的规则在多数任务上优于只买最便宜实验(c);DeepSeek V4 Pro 案例中,少量点导致高误差(b);前四名系统以极低成本超越经典幂律基线(a)。来源:论文图 5。
展望:迈向自主规划实验的 AI 科学家
决定下一步做什么实验是科学研究的核心。Chinchilla 等里程碑成果正是通过精心设计的训练规划得出的。目前,这一规划工作仍主要由人类完成。
尽管当前 AI 尚未完全通过 SLDBench v2 的考验,但领先模型已展现出类似科学家的工作范式:提出假设、设计验证实验、修正理论。未来改进方向明确:AI 在选择实验时,应关注哪些实验能有效区分候选规律的对错,而非仅仅关注价格高低。
当 AI 具备自主规划实验的能力,“AI for AI”才能真正从小规模实验走向大规模预训练。届时,AI 研发的将不仅是单一算法,而是下一代基础模型本身。
人工智能 × [ 生物 神经科学 数学 物理 化学 材料 ]
「ScienceAI」关注人工智能与其他前沿技术及基础科学的交叉研究与融合发展。
欢迎关注标星,并点击右下角点赞和在看。