

AI集群中的数据流动并非自动完成,多GPU归并、内核细粒度交换、跨节点传输及进程绑卡等环节,需由不同的通信组件协同处理。
测试数据显示,在8张MI355的单节点环境中,GPU发起的SDMA Alltoall仅占用1个计算单元即可达到395GB/s的带宽,而默认RCCL路径占用64个计算单元时仅为307GB/s;在16台(每台8张MI350)的集群中,分层AllGather相比默认Ring模式最高快3.6倍。这些差异表明,不存在放之四海而皆准的通用通信库。AMD通过将集合通信交给RCCL,将GPU内核内的一对一读写交给rocSHMEM,并利用UCX和Open MPI整合内存、网卡、进程与CPU位置,以实现AI集群通信性能的最优化。
RCCL优化集合通信:平衡数据传输量与同步等待
在训练或推理任务被分配至多张GPU后,结果需汇总返回。以AllReduce为例,RCCL作为ROCm中的集合通信库,负责将“群体交换”操作拆解为逐卡的发送、接收和同步。
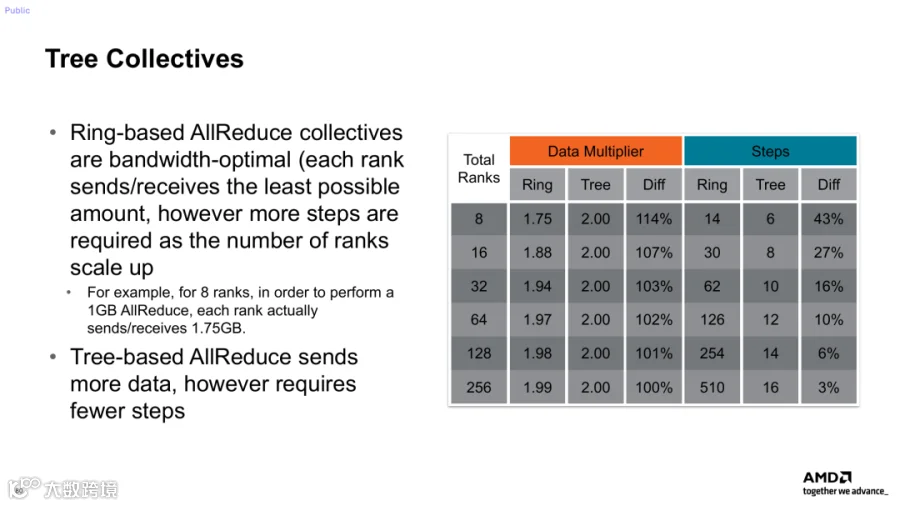
AllReduce没有固定的最优路径。环形路径传输数据量较少但同步步骤多;树形路径传输量稍大但同步步骤少。例如,8张卡各处理1GB输入时,环形路径每卡收发1.75GB、需14步;树形路径每卡收发2GB、仅需6步。消息较大时,减少数据搬运更划算;对延迟敏感时,减少同步步骤更具优势。
RCCL会根据GPU架构、互连方式、节点数、操作类型及消息大小,预先测得成本参数并在启动时匹配拓扑路线。若服务器硬件布局变化,原有路线可能导致流量拥塞。
在跨节点场景下,分层AllGather先处理不同节点间相同编号GPU的交换,再处理节点内汇集。在16台MI350集群测试中,该路径在2KB至16MB消息范围内相比默认Ring最高快3.6倍,但在64MB以上消息时优势收窄。
利用SDMA卸载数据搬运,保障GEMM计算效率
AllGather、Alltoall等操作主要涉及数据搬运,无需途中进行归约计算。传统路径会占用GPU计算单元,导致与GEMM(矩阵乘法)争抢资源。RCCL将这些搬运型操作交给专用拷贝引擎SDMA,从而释放计算单元供GEMM使用。
该功能覆盖节点内scale-up域,需注册对称内存窗口并设置通信器标志,已在ROCm 7.12可用并回移至ROCm 7.0.2.2。需注意,需边传边归约的任务仍走其他路径。
在MI350单节点测试中,SDMA处理的AllGather和Alltoall总线带宽最高达428GB/s。在并发场景下,将2K×2K×2K GEMM与256MB至4GB的AllGather放入不同HIP stream,当消息为1GB和2GB时,SDMA路径使端到端速度分别提升1.20倍和1.21倍。
此外,GPU内核可直接发起SDMA Alltoall。在8张MI355单节点测试中,该方式仅用1个计算单元即达到395GB/s,优于默认RCCL路径的307GB/s(占用64个计算单元)。这使得运行中的内核可将通信纳入自身时间线。需注意,相关代码当时仍在审核中,非所有ROCm部署的默认能力。
rocSHMEM实现GPU内核细粒度一对一通信
针对稀疏计算、FFT、图处理及MoE专家路由等场景中的细粒度读写需求,rocSHMEM将OpenSHMEM的一侧通信模型引入AMD Instinct GPU。发起方可直接执行Put、Get或原子操作,远端无需配对接收。
rocSHMEM提供三种执行模式:主机执行模式(CPU发起)、流触发模式(沿GPU stream顺序启动)和设备发起模式(GPU线程在内核中直接通信)。前两种适合既有程序迁移,最后一种实现通信与融合内核的深度交叠。
跨节点时,GDA后端允许GPU内核发起RDMA,由网卡直接读写远端内存,无需CPU逐笔发令。CPU仍负责资源初始化与释放。rocSHMEM屏蔽了不同NIC在队列格式、寄存器写法上的差异,应用只需调用通信原语。此路径依赖特定NIC和系统软件,适用于需细粒度计算—通信交叠的内核。
UCX与Open MPI整合传输路径与进程调度
RCCL和rocSHMEM解决GPU间交换问题,UCX则处理“数据位置、对端身份及传输协议选择”。它支持进程内主机—GPU复制、同节点跨进程GPU IPC以及跨节点GPUDirect RDMA。实际路径选择取决于内存类型、进程位置及硬件支持情况。
Open MPI管理多进程,调用UCX处理点对点和一侧操作,并为集合操作选择组件。大型GPU归约可通过UCC调用RCCL,小型归约可能经CPU bounce buffer中转。GPU缓冲区的支持程度因具体组件和操作而异。
物理位置同样关键。NUMA架构下,若进程与绑定的GPU位于不同CPU插槽附近,会导致跨插槽访问延迟。建议将NUMA 0上的进程优先绑定至靠近该NUMA节点的GPU(如示例中的GPU 4和5),以优化通信效率。
总结:四层分工构建高效通信体系
AI集群通信体系分为四层:RCCL负责多GPU集合操作的算法与拓扑选择;SDMA卸载纯数据搬运以释放计算单元;rocSHMEM实现GPU内核细粒度通信并屏蔽NIC细节;UCX和Open MPI统筹内存、进程、网卡及NUMA位置。唯有让归约、搬运、内核通信和进程调度各司其职,才能最大化模型训练与推理效率。
