

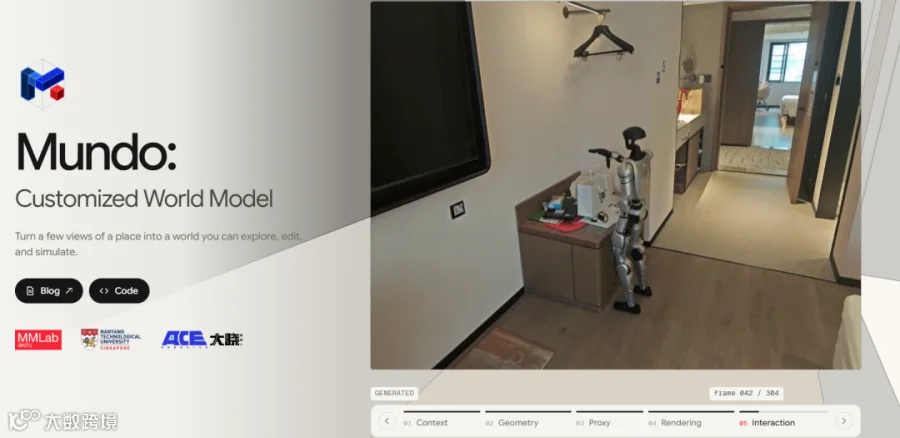
世界模型的核心难点,从来不是画面的美观度,而是可信的计算能力。Mundo 通过几张照片,将几何重建、物理模拟、外观渲染拆解为三个独立的工程模块,各司其职,互不越界。
近日,大晓机器人与南洋理工大学 S-Lab 联合发布了 Mundo。其演示场景令人印象深刻:仅输入 9 张照片,系统便重建出一间办公室。镜头沿预设路径移动,拉开抽屉,苹果飞出并撞击显示器。在苹果悬空的瞬间,镜头环绕拍摄,随后时间继续流动。
对于世界模型而言,这一过程的挑战不在于视觉效果,而在于底层逻辑的严谨性。抽屉开合幅度、苹果飞行轨迹、碰撞点位置等,均需依赖可信的计算过程支撑,而非视频模型的“直觉”生成。Mundo 为此提供了一套清晰的工程化解决方案。
01
三步构建世界的工程设计
02
四大核心演示场景
03
机器人训练的实际价值
它是什么:面向具体环境的世界模型
Mundo 是一个面向具体环境的世界模型。用户只需提供同一地点的几张图片或一段视频,系统即可重建场景。在此基础上,用户可以自由切换视角、修改物体属性、施加动作,并由系统渲染出相应的视频结果。
作为 Atlas 系列的延续,Mundo 保留了场景重建、自由视角探索和时空模拟能力。其核心突破在于将物体的质量、摩擦系数等物理属性写入场景程序,由物理引擎处理运动、接触和碰撞计算。同时,支持智能体通过代码编辑场景中的物体、属性及动作。
场景不再是静态的视觉呈现,而是具备响应能力和状态记录的可交互环境。
结合 Astra 的空间理解能力,完整技术链路为:从影像重建场景,通过代码编辑场景,进行交互模拟,最终生成可用于机器人训练的高质量环境数据。
三步造出一个世界
Mundo 的设计思路可拆解为以下三个关键步骤:

第一步:搭建代理世界
Mundo 首先利用三维检测器为每个主要物体生成初始包围盒,随后由视觉语言模型(VLM)智能体进行精修。智能体采用“渲染-比较-修正”机制:修改场景程序,从输入相机视角渲染,与原图对比后决定后续调整策略。
引入智能体的原因在于弥补单一技术的不足。检测器常出现漏检、类别错误或边框不准;VLM 能识别遗漏物体、重叠边框、错误朝向等问题,但难以达到厘米级精度;数值优化虽能精确拟合,却易受杂物干扰。
Mundo 让智能体判断修正对象与证据可信度,再由优化器执行拟合。只有当拟合结果在未参与拟合的独立视角下依然匹配时,才会被保留。
采用包围盒而非精细网格表示物体,是出于效率与实用性的权衡。包围盒足以表达刚体仿真所需的空间关系,仅对需精细交互的物体才应用更复杂的几何结构。
第二步:以代码形式运行世界
场景程序记录了每个物体的名称、尺寸、位姿及物理属性,并定义了状态更新规则。脚本负责定义动作和受力,物理引擎(主要为 MuJoCo)则在重力和接触约束下计算运动轨迹、接触点及碰撞力。
添加物体、修改属性、移动相机或将相机挂载至机器人,本质上都是对这段程序的修改。
第三步:将计算结果渲染为视频
模拟生成的世界首先被渲染为“代理画面”,物体按类别着色,仅保留位置、运动和碰撞时机等信息。视频扩散模型以此为指导,并结合输入照片的外观参考,生成最终视频。
实验表明,相比仅提供相机参数,引入代理视频能显著提升相机控制的精确度,使生成内容更忠实于场景。
这种分工明确的架构优势明显:三维代理记录“物体位置与变化”,物理引擎负责“运动逻辑”,视频模型负责“视觉还原”。
几何、物理、外观各管一段,谁也不越界。
渲染器训练规模适中,约 4 万对视频,数据来源涵盖真实室内扫描、合成场景、驾驶、手物交互及游戏画面。基于 MiniMax-H3 的 Ref2VA进行微调,片段长度为 124 帧,分辨率 640×480。
长视频生成采用分块推理策略,每块 124 帧,利用上一块的最后 34 帧作为前缀,并为每个分块单独选取相关参考图,确保连贯性。
四个值得关注的演示
1. 几张图构建世界
输入 1 至 12 张图片,系统即可围绕家具和空间结构进行探索。同一组图片可生成多条探索路径。已拍摄区域受图像约束,未拍摄区域由模型推断补全。对比显示,参考视图越多,模型推断的成分越少,准确度越高。
有趣的是,起点甚至可以是一张 AI 生成图或手绘作品。原图的结构与风格会延伸至新视角,未被绘制的区域将被自动补全。
2. 长路径探索
面对大型环境,Mundo 利用数十张上下文图像,生成数十秒至分钟级的探索画面。基于同一三维代理分段生成,每段选取相关参考视图,并通过重叠帧实现无缝衔接。
3. 物理交互模拟
用户可直接在项目中拖动垃圾桶、推动显示器、拉开椅子或打开抽屉,并能切换物体材质和重力条件。速度、接触点、冲击力等状态数据会与生成画面同步显示。
确保每次交互都具备可追踪的状态和可计算的过程,是场景从“可观看”迈向“可使用”的关键一步。
4. 四维模拟与“子弹时间”
针对多相机记录的动态事件,系统可从新视角重现;针对基于图像构建的模拟事件,则通过重力和接触动力学计算运动。用户可暂停特定时刻,移动相机从多角度观察同一瞬间,用于检查动作细节和遮挡关系。例如,团队在拍摄双臂演示时,使用了四台手机环绕桌子进行采集。
对机器人意味着什么
这才是 Mundo 的核心价值所在。
导航能力
三维代理提供物体类别、位置、障碍物及可通行区域信息,规划器(如 A*)据此规划路线。Mundo 能生成不同机器人沿路线行进的第一人称和第三人称视角画面,演示中包含了宇树 G1 和机器狗等机型。
操作能力
Mundo 为交互物体建立几何和物理属性,支持不同形态机器人执行相同任务,如将苹果放入碗中、放置罐子、堆叠积木等。系统输出外部视角以及机器人头部和腕部相机视角,并保留任务轨迹和物理交互状态。
研究人员可将机器人的“视觉感知”与“实际行动”对应分析,在进入真实场景前优化策略。
酒店案例实战
酒店案例最具代表性。团队利用 Mundo 重建了整层楼及洗衣区,模拟机器人从大堂导航至客房,并执行洗衣机开门交互。三维代理记录了每个物体的位置和属性,赋予机器人全局信息,使其能在语义层面规划路线,并在行动前理解“将衣物放入洗衣机”等复杂任务。
在大晓以 Kairos 为核心的世界模型体系中,Mundo 补齐了具体环境建模、训练数据生成和仿真训练环节,打通了现场采集、数据生成与策略优化的闭环。
局限性与改进方向
官方博客坦率地列出了当前存在的三个主要局限:
1. 速度较慢。重建房间级场景通常需 10-20 分钟。在 8 张 A800 GPU、20 步推理设置下,视频渲染速度约为每秒 1.5 帧,推理加速仍有较大空间。
2. 精细交互不稳定。小物体在重建场景中易出现漂浮现象,涉及小物体的操作易引发视频模型幻觉。
3. 缺乏长程记忆。虽然上下文视图能维持静态场景一致性,但在经历长时间动态变化或遮挡后重新出现时,细节保持一致性仍有难度。
这些问题具体且明确,团队已提出包括流式渲染在内的加速改进思路。
结语:Physical AI 又近了一步
机器人要在真实世界高效工作,不仅需要具备更强的模型能力,更需要一个能反复练习且高度贴近现场的环境。真实环境试错成本高,通用仿真环境与现场差异大。
Mundo 的创新在于,将现场拍摄的几张照片作为构建训练环境的入口,利用代码和物理引擎确保环境对动作的响应能力,借助视频模型保证画面与现场的一致性。尽管细节仍需打磨,但其技术路线令人信服:
从“看懂一个地方”到“在其中行动”,这一步被实实在在地向前推进了。
正如大晓机器人所言,他们的开悟世界模型“不复刻世界,只锚定动作”。这一理念在 Mundo 身上得到了生动体现。
项目主页:mundo-world-model.github.io
技术博客:huggingface.co/blog/Luo-Yihang/mundo-world-model
代码:github.com/Luo-Yihang/Mundo
END