

一、这篇论文想回答什么
-
研究空白(gap):前人工作留下的缺口,比如「某方法的训练配方没公开」 -
研究问题(RQ):把缺口变成一个要回答的问题,比如「开源的强化学习系统,能否不依赖私有配方,在 AIME 上达到最好水平?」 -
想法与贡献(idea):回答这个问题的具体方案,比如提出一个新算法、发布代码和数据
-
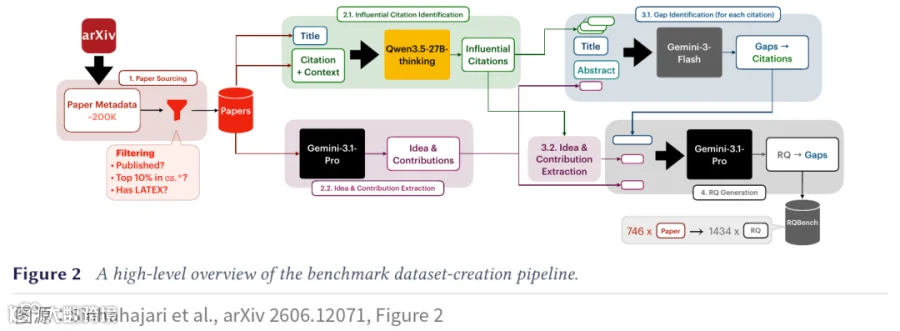
选论文。从 2025 年 1 月到 2026 年 4 月约 20 万篇 arXiv 计算机论文里,筛出三类条件都满足的:已经被会议或期刊收录,引用数在所属子领域排前 10%,并且能拿到 LaTeX 源文件。 -
找「有影响的引用」。一篇论文引用几十篇文献,大多数只是常规引用。作者用 Qwen3.5-27B(思考模式)读每条引用所在的上下文(引用句前后各 3 句),判断这篇文献是「启发来源」或「直接竞争对手」,还是只是常规引用。只有前两种会被保留。 -
抽取想法与空白。用 Gemini 3.1 Pro 从目标论文中抽取它的核心想法和贡献;再用 Gemini 3 Flash,针对每篇有影响的引用,找出它留下了哪些被目标论文回应的空白。 -
生成研究问题。把空白和贡献一起交给 Gemini 3.1 Pro,还原出「作者当时真正想回答的问题」。
-
746 篇来源论文,1434 个研究问题,平均每篇约 1.9 个 -
覆盖 13 个计算机子领域,机器人(245 个问题)、计算机视觉(222)、自然语言处理(173)、机器学习(162)最多 -
关联 1375 篇被引论文、3151 条研究空白 -
问题平均长度约 25 个英文单词;746 篇论文里 731 篇属于方法类
-
原创性:问题的切入角度,是否超出了背景论文里直接写过、问过的内容 -
回应空白:是否真的瞄准了背景里的某个缺口,而且是核心缺口 -
非显而易见性:是不是一般读者读完背景后不会马上想到的问题。0 分是「任何读者都会提的下一个标准实验」,3 分是「背景完全没有暗示的、出人意料的角度」
-
单独打分:每个问题单独评,评委看不到其他问题 -
比较打分:参照问题和模型的 5 个问题放在一起评
-
非显而易见性:1.98 对 1.41
-
原创性:2.67 对 1.90
-
回应空白:2.98 对 2.01
-
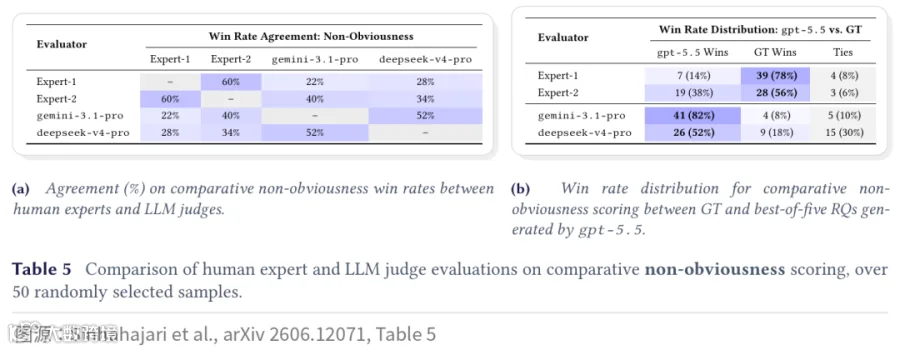
专家 1:39 次选参照问题(78%),7 次选 GPT-5.5(14%),4 次平局 -
专家 2:28 次选参照问题(56%),19 次选 GPT-5.5(38%),3 次平局 -
Gemini 3.1 Pro:41 次选 GPT-5.5(82%),只有 4 次选参照问题 -
DeepSeek V4 Pro:26 次选 GPT-5.5(52%),9 次选参照问题,15 次平局
-
两位专家之间:60%
-
两个 AI 评委之间:52%
-
专家和 AI 之间:22% 到 40%,最低是专家 1 和 Gemini,只有 22%

-
参照问题:如何把树搜索高效地融进大语言模型的强化学习里,为推理任务提供密集的过程监督? -
GPT-5.5 的问题:要让 AlphaZero 在「入玉规则」下学会下好将棋,状态表示和终局计分需要做哪些修改?
-
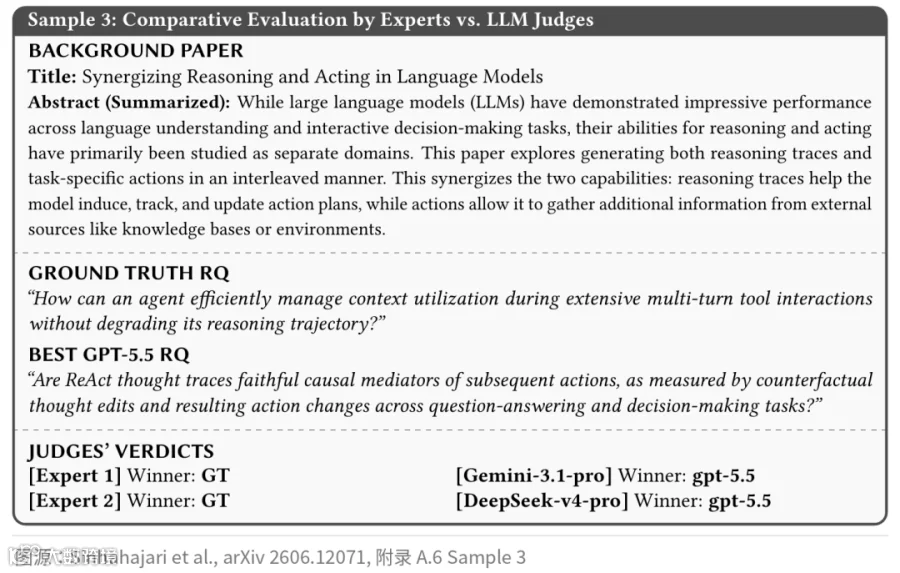
参照问题:智能体在大量多轮工具调用中,怎样高效管理上下文,又不损害推理过程? -
GPT-5.5 的问题:ReAct 的思考过程是否真的在因果上决定了后续行动?用反事实地修改思考内容、观察行动是否改变来衡量,覆盖问答和决策任务。
-
背景是「大语言猴子」(重复采样的推理扩展规律)。参照问题:能否用自适应解码,在不需要 Best-of-N 那样大量采样的情况下,平衡计算成本和推理准确率?GPT-5.5:用前 100 或 1000 次采样拟合的幂律,能多准确地预测 1 万次、10 万次采样的通过率? -
背景是 BOND(把 Best-of-N 蒸馏进模型的对齐算法)。参照问题:如何在后训练流程中改进 BOND,用来对齐轻量的多模态模型?GPT-5.5:去掉 Best-of-N 里的碰撞修正项,会损失多少性能,尤其是在短输出或低熵参考策略下?

-
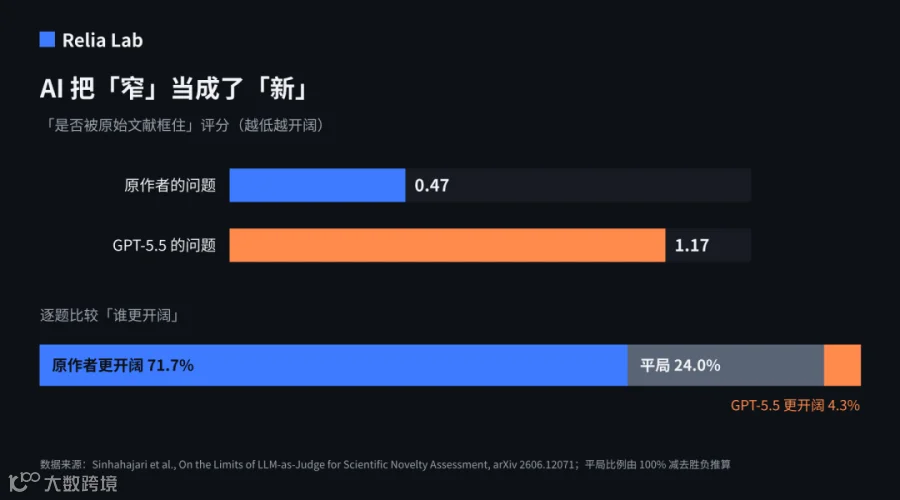
被原文框住的程度(source-boundedness):问题是不是围绕背景论文自己的方法、数据集、基准、组件、结果或设置。0 分是问一个更大的问题或新方向;3 分是直接研究、诊断、调参、评测或修改原论文的贡献 -
诊断式提问(diagnostic framing):问题是不是一个分析、消融、相关性检验、因果检验或者一串可测因素的清单。0 分是在问一个方法、机制或方向;3 分基本就是一份测量清单或消融计划
-
参照问题:0.47
-
Gemini 3.1 Pro:0.90
-
GPT-5.5:1.17
-
Gemma 4:1.46

-
Gemini 认为参照问题更开阔的有 41 题(82%),DeepSeek 是 45 题(90%) -
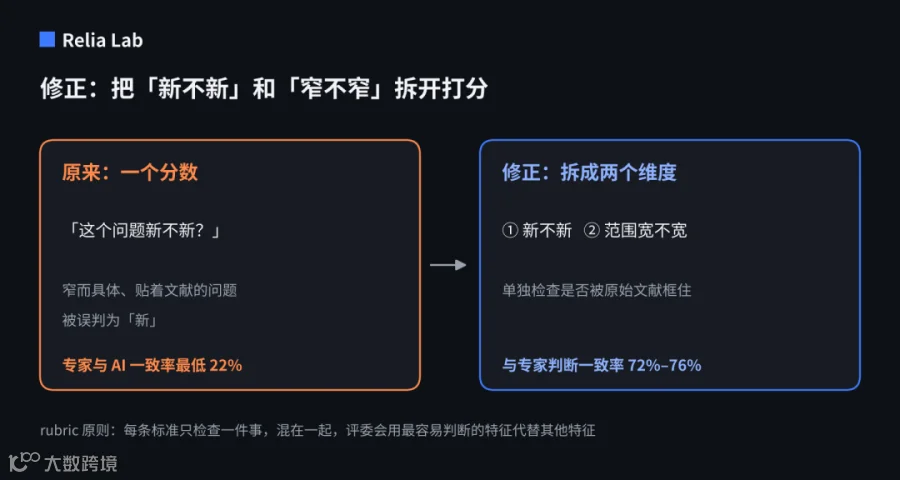
专家 1 对「非显而易见」的判断,和两个 AI 对「开阔度」的判断,一致率是 72% 和 76% -
专家 2 是 46% 和 50%
-
「被原文框住」从 1.00 降到 0.47,和参照问题持平 -
但原创性从 2.39 降到 1.90,非显而易见性从 1.81 降到 1.46
-
原来:只问「新不新」,窄而具体的问题被当成了新 -
修正后:把「新不新」和「范围宽不宽」拆开,分别打分
-
AI 评估可能奖励「会包装」的人。 如果只让模型来评,把研究空白写得漂亮、把问题包装得具体严谨的作品可能得到高分;真正提出了开阔问题、但表达不够标准的年轻人,反而可能被低估 -
rubric 里需要一个「视野」维度。 评估研究作品时,我们会把「问题新不新」和「问题的范围与视野」分开评估;对 AI 评分和专家判断分歧大的作品,优先交给专家复核 -
「今天打分,明天对答案」是可行的。 RQ-Bench 用「后来真实发表的论文」当参照,正是我们在自进化那篇里讲的慢循环:评估结果要拿真实结果来校准。研究者的作品也一样,过一段时间看它是否被跟进、被使用,就能检验当初的评分准不准