

导读标准因果 Transformer 的增量推理中,当前 Q 读取历史及当前 K/V,历史 Q 无需跨步保留。缓存省去历史前缀的重复计算,却占用随保留长度和活跃序列数累加的显存。沿着一次 Decode,我们推导每 Token 的缓存大小,用 Llama 3.1 算清 128K 的容量,再把输入、输出和并发放进同一份部署预算。
本文 3194 字,阅读约 8 分钟
模型装得下,为什么长文本还是跑不动
一次 Decode,为什么用新 Q 读取旧 K/V
显存公式:先算一个位置,再累加所有请求
Llama 3.1:128K 缓存为何分别是 16 和 40 GiB
MHA、GQA、MQA,改变的是哪一项
量化、分页和裁剪,省下的不是同一笔钱
实际运行要多少显存,并发怎样计入
模型装得下,为什么长文本还是跑不动
一个约 8B(80 亿)参数的模型,BF16 权重按每参数 2 字节估算,共约 160 亿字节,即 16 GB,约合 14.9 GiB。
GB 按十进制计量,1 GB = 1000³ 字节;GiB 按二进制计量,1 GiB = 1024³ 字节。16 GB 与约 14.9 GiB 表示同样大小的数据。后文统一用二进制容量单位计算,避免相加时混用口径。
除了权重,还要为 KV Cache(键值缓存)留出显存:模型把各层已经算过的 Key 和 Value 保存下来,生成后续 Token 时继续使用。
缓存也有位宽,即每个数值用多少个 bit(二进制位)保存,8 bit 等于 1 字节。BF16 缓存中,每个 K/V 数值占 16 bit,也就是 2 字节;8 位或 4 位量化可以进一步减少存储量。
对 Llama 3.1 8B 来说,当单条序列缓存了 128K(131,072)个 Token 位置,且 K/V 使用 BF16 保存时,仅 KV Cache 就要额外占用 16 GiB 显存。
这与约 14.9 GiB 的权重相加,已经接近 31 GiB,尚未计入临时计算和运行时余量。只看权重能否放进显卡,就会漏掉长文本和并发请求带来的另一笔账。
这笔开销从哪里来?每层还算了 Query 和其他中间结果,为什么跨步保留的是 K/V?先沿着一次 Decode 看它们各自做什么。
一次 Decode,为什么用新 Q 读取旧 K/V
先把时序对齐。Prefill 并行处理 Prompt,留下各层 K/V,并用末位隐藏状态预测第一个输出 Token。这个 Token 被选出来后,作为下一次前向的输入,才会产生它自己的各层 K/V。
下面统一按位置编号:已有位置 到 的缓存,本次输入位置 的 Token,最终预测位置 。普通单步 Decode 中,每条序列只输入一个新位置;同一批次可以处理多条序列。
缓存有效的前提是因果性:每个位置只能读取自己和此前的位置。在权重、前缀和各位置的位置编码保持不变时,追加后续 Token 不会改变历史位置已经算出的表示,因此无需重新计算历史 K/V。
以某层的一个 Query 头及其对应的 KV 头为例,设当前输入向量为 ,投影得到:
式中省略层号、头号和位置编码;使用 RoPE 时,Q、K 还要经过位置旋转。把当前 K/V 加入历史缓存,当前 Query 对全部保留的 Key 计算匹配权重,再聚合对应的 Value:
其中, 是单头维度。Query 表达当前位置要检索什么,Key 用于匹配,Value 提供被加权聚合的信息。
到了下一步,模型会产生新的 Query,读取已经扩充的 K/V。后续计算需要旧 K/V,却不需要旧 Q。旧 Q 已经完成所属位置的查询,保存它无法代替下一位置的新查询。
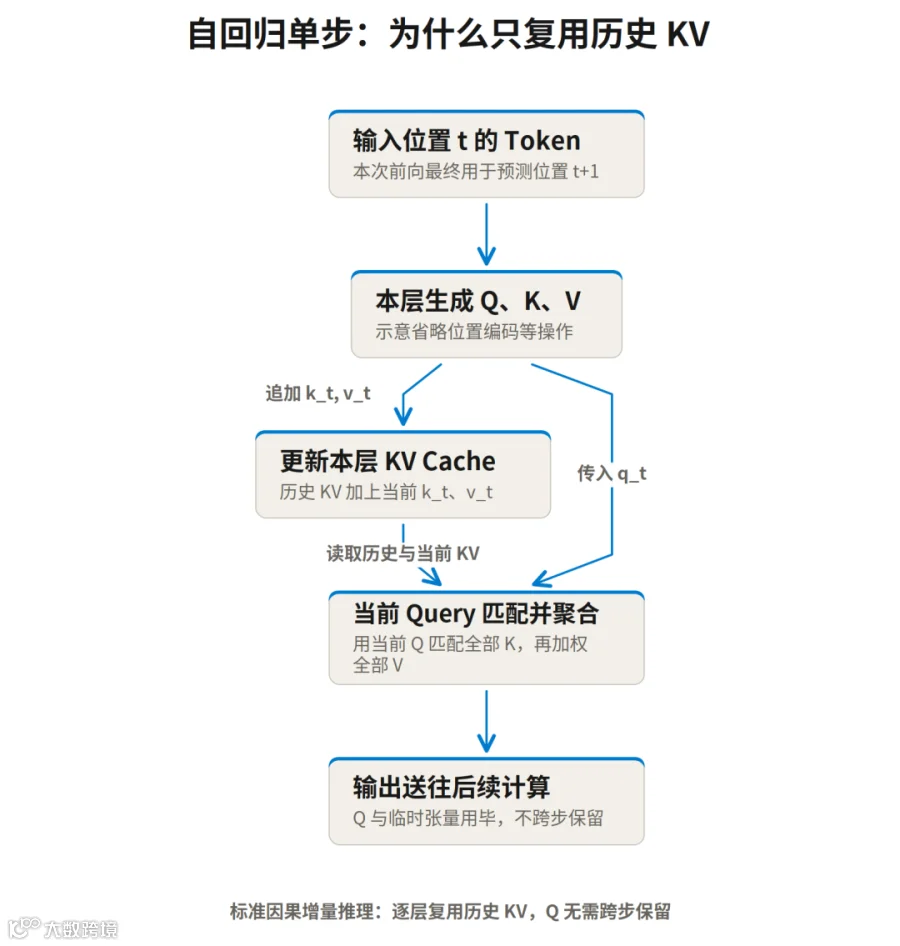
当前位置继续经过后续层,每层都留下自己的 K/V。未来位置通过这些逐层缓存读取历史信息;历史位置的前馈网络中间激活、残差和注意力权重不再参与后续步骤,用毕便无需继续保留。
因此,“只存 K/V”指注意力所需的跨步缓存。推理系统仍有临时张量和其他运行状态。
缓存也没有让长上下文的计算成本消失:完整注意力下,新 Query 仍要读取全部保留的 K/V。它省去了历史位置的重复前向,每步注意力的计算量和读取量仍随缓存长度增长。
显存公式:先算一个位置,再累加所有请求
每个位置都会在每层留下一份 K/V,因此先算一个位置占多少字节,再乘保留的位置数。
以下计算 K/V 张量本身的理论容量:假设各层都是完整注意力,K、V 的头数和单头维度相同,各层规格与缓存精度一致,且序列之间不共享缓存。需要四个参数:
•
:层数,对应 num_hidden_layers。
•
:每层 KV 头数,对应 num_key_value_heads。
• :单个头的维度。
• :每个缓存元素的字节数。FP16/BF16 用 16 bit,即 2 字节;FP8 用 8 bit,即 1 字节。
每个位置在每层都存一份 K 和一份 V,各有 个元素,所以全模型每 Token 的增量为:
单位为字节,系数 2 来自 K、V 各存一份。若 条序列各缓存 个位置,总量为:
真实请求通常长短不同。第 条序列保留 个位置时,就累加它们的实际长度:
这里的 是第 条序列已经写入缓存的位置数,不是模型声明的最大上下文长度。公式也未计入块内空位、量化元数据或多卡复制;存在前缀共享时,物理数据应按实际共享关系计数。滑窗、混合层或压缩状态的模型,要按各层实际保留的状态另算。
Llama 3.1:128K 缓存为何分别是 16 和 40 GiB
Meta 技术报告第 3.2 节表 3 给出了以下架构参数;单头维度由隐藏维度除以 Query 头数得到:
以下均按 BF16 缓存、完整保留历史、不共享前缀计算。1 KiB = 1024 字节,1 MiB = 1024² 字节;全文长度中的 1K 统一指 1024 个 Token,128K 即 131,072 个位置。
8B 每个 Token 的缓存增量是:
即 每 Token 128 KiB,累加结果如下:
并发不一定要等到 128K 才成为压力:16 条 32K 序列的 KV 已需 64 GiB,再加约 15 GiB 权重,80 GiB 的容量预算几乎没有运行余量。这些是容量推算,不能当成服务可稳定运行的并发成绩。
70B 则为:
即每 Token 320 KiB,128K 缓存共 40 GiB。参数量从约 8B 增至约 70B,KV 容量却只增至 2.5 倍:两者 KV 头数与单头维度相同,差别来自层数。
参数量不能直接推出 KV 大小。多卡部署还要检查 KV 如何分片或复制,不能默认总容量除以 GPU 数量就是单卡占用。
MHA、GQA、MQA,改变的是哪一项
公式没有直接乘 Query 头数,因为缓存保存的是 K/V。多个 Query 头是否共享 KV,决定了每个位置实际要存多少组数据。
MHA(多头注意力)让每个 Query 头使用独立的 Key、Value 头;GQA(分组查询注意力)让同组 Query 头共享一对 KV 头;MQA(多查询注意力)让全部 Query 头共享一对 KV 头。

Llama 3.1 8B 有 32 个 Query 头、8 个 KV 头,相当于每 4 个 Query 头共享一组 KV。与其他规格相同的 32 头 MHA 相比,GQA 将缓存降至四分之一。假设改用 MHA,128K 的 BF16 缓存就会从 16 GiB 变成 64 GiB。
这是固定其他规格后的结构容量对照。KV 头数通常在训练或转换并继续训练时确定,部署时直接调小配置,不能让原权重自动获得同样的能力。共享还可减少 Decode 读取的 KV 数据,但质量取舍要看模型和任务;GQA 论文在 T5 系列的摘要、翻译、问答实验中报告了接近 MHA 的质量,不能据此外推所有长文本任务都无损。
量化、分页和裁剪,省下的不是同一笔钱
模型结构确定后,还可以沿着元素字节数、分配方式和保留长度继续优化。
KV 量化降低公式中的 。BF16/FP16 改为 8 位,数据载荷理论上减半;改为 4 位,降至四分之一。但还要计入缩放因子、零点以及可能保留的高精度部分,数值误差与速度也需要验证。KIVI 展示了低比特缓存方案,vLLM 文档则提供 FP8 缓存与校准路径;具体能否使用取决于后端。权重量化和 KV 量化是两项配置,权重变成 4 位不代表缓存也跟着变化。
分页改善分配和共享。PagedAttention 将 KV 划成固定大小的块,通过映射访问不连续的物理空间,按请求增长分配新块,减少提前预留与碎片浪费。配合前缀缓存机制,可复用的相同前缀还可共享物理块。
分页不会压缩一份有效 K/V 张量。相同长度和精度下,单条 128K 序列仍需相应的 16 GiB 数据容量;末块空位、映射等还会占用空间。引擎若预先划好缓存池,请求增长可能只表现为池内空闲块减少,进程总显存未必逐步上涨。
历史裁剪减少保留的位置数。例如 StreamingLLM 保留少量有助于稳定注意力的初始位置,以及近期窗口的 KV,支持持续流式运行。被淘汰的中段历史无法再被直接检索,因此持续处理输入流与保留完整长程记忆,是两种能力。能否接受裁剪,要看任务是否需要找回远处细节。
实际运行要多少显存,并发怎样计入
把 KV 放回总显存账本,要合计三笔:权重、KV Cache,以及临时计算与运行时开销。
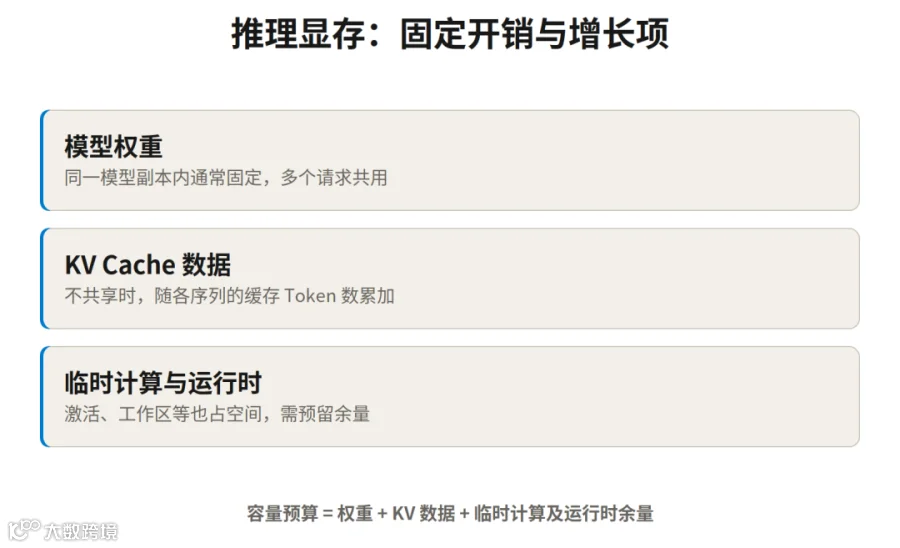
同一模型副本的权重通常共用,未共享的 KV 则按各条活跃序列累加。尚未处理、也未分配 GPU 缓存的排队请求,不直接计作同样数量的驻留序列;已分配的缓存池中若还保留可复用前缀,也会占据空间。
每条序列要为多少个位置留预算?本文的 Prompt 指完整输入,包括系统提示、历史对话、当前提问和格式标记。完整 Prompt(含已缓存前缀)的 Token 数 + 计划输出 Token 数,不能超过可用上下文上限;部署配置或单次输出限制还可能进一步收紧预算。尚未缓存的输入在 Prefill 时写入,输出在后续作为输入前向时写入,因此输入加计划输出是缓存位置数的保守上界。
沿用 Llama 3.1 8B 的 BF16 配置,每条请求有 8K 个输入 Token、计划输出 2K 个,就按 10K 个缓存位置预算。4 条同时驻留、且不共享前缀的序列需要 5 GiB KV,加约 14.9 GiB 权重,合计约 19.9 GiB,尚未计入分配、临时计算和运行时开销。
若这 8K 输入中有 6K(6,144)个前缀 Token 的 K/V 已缓存,Prefill 只需处理剩下的 2K 个输入。这里 6K 是 Token 数,对应的 BF16 缓存为 768 MiB(6,144 × 128 KiB)。完整输入仍是 6K + 2K = 8K,加计划输出后仍按 10K 个位置预算。
复用前缀省去重复计算,历史位置仍占上下文,不能把这 6K 再加到完整 Prompt 上。若多个请求实际共享这份前缀缓存,物理数据按共享块计一份,各请求的上下文长度仍分别计算。
也可以倒算:扣除权重和其他预留后,将 KV 预算除以每 Token 增量,得到可容纳的缓存位置总数。假设单卡给 BF16 KV 留下 8 GiB,暂不计共享和分配额外开销:
这能容纳一条 64K 的缓存,或八条各 8K 的缓存。按前面每条 10K 个位置预算,理想数据容量最多容纳 6 条;实际还要给块空位等开销留余量。
最后用实际部署验证这份预算。临时激活、算子工作区和运行时缓冲随引擎、批量和输入长度变化,不能统一加一个固定比例就保证够用。固定模型、权重与缓存精度、引擎和硬件,在目标输入、输出长度及活跃并发下测显存峰值,覆盖长 Prompt 的 Prefill 和持续 Decode;多卡再逐卡核对分片与复制。
显存能装下,只回答了容量问题。延迟与吞吐还受计算、数据读取和调度影响,需要在同一组负载条件下单独验收。
参考资料
•Transformers v4.57.1 Caching,逐层缓存与增量推理: https://huggingface.co/docs/transformers/v4.57.1/cache_explanation
•The Llama 3 Herd of Models,第 3.2 节表 3 与长上下文训练: https://arxiv.org/html/2407.21783
•Fast Transformer Decoding: One Write-Head is All You Need,MQA 共享机制: https://arxiv.org/html/1911.02150v1
•GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,分组共享与质量取舍: https://arxiv.org/html/2305.13245v3
•Efficient Memory Management for Large Language Model Serving with PagedAttention,分页分配与缓存共享: https://arxiv.org/html/2309.06180
•KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache,低比特缓存及额外存储: https://arxiv.org/html/2402.02750v1
•vLLM Quantized KV Cache,FP8 缓存与校准: https://docs.vllm.ai/en/stable/features/quantization/quantized_kvcache/
•Efficient Streaming Language Models with Attention Sinks,流式缓存机制及限制: https://arxiv.org/html/2309.17453v4
文章仅做学术分享,如有侵权请联系删除,非常感谢!