

目录 📑
-
0. 引言:同步的两个层次 -
1. 切片与同步的基础
1.1 切片是什么
1.2 为什么需要两层同步 -
2. 切片间同步:有指令原语
2.1 SPMD 模型与无总调度器
2.2 BAR 与 GATHER 两条同步指令
2.3 collective 的 req/ack 机制
2.4 全局 AND/OR 聚合信号
2.5 编译器如何插入 BAR/GATHER
2.6 S>1 时的 hub/port 跨 SLR 同步 -
3. 切片内同步:无指令原语
3.1 三层同步概览
3.2 sequencer 的 scoreboard
3.3 单元握手
3.4 TMEM 仲裁
3.5 三条显式同步指令 -
4. 两层同步的对比 -
5. 总结
openTPU 是一套 TPU 风格 的多切片加速器。它的同步机制分两层:切片间同步靠 collective 单元的 BAR/GATHER 屏障,切片内同步靠 sequencer 的 scoreboard 和单元握手。🌟
✨ 这两层同步最本质的区别,不在于“谁来写同步代码”,而在于“有没有专门的同步指令原语”。
• 🔵 切片间:硬件里存在 BAR和GATHER两条同步指令原语。硬件看到这两条指令,才知道“这里要做屏障”。• 🟣 切片内:硬件里没有任何同步指令原语。程序员只写 LD、MM、VOP这类普通指令,sequencer 在分发时比较 footprint,自动推断依赖。前者是“指令触发的同步”,后者是“指令之外的同步”。这个差异贯穿全文,也是理解 openTPU 同步设计的关键。
0. 引言:同步的两个层次 🎯
多切片加速器要回答两个同步问题:
切片之间:多个切片什么时候必须一起停下、一起继续?
切片内部:同一切片里的 DMA、MXU、VPU、量化器,什么时候可以并发、什么时候必须串行?
openTPU 对这两个问题给出了不同的答案,而且这两个答案的硬件机制完全不同:

-
• 🔵 上层是切片间同步: BAR/GATHER指令触发 collective 的 req/ack,再由全局 AND/OR 聚合。 -
• 🟣 下层是切片内同步: LD/MM/VOP只是普通指令,sequencer 自动比较 footprint,再由单元握手和 TMEM 仲裁协调。 -
• 🔗 两条链各自内部有先后关系,用实线连接。 -
• 🚫 两个分支之间没有连线,表示两种独立的同步机制。 -
• 🎨 颜色区分切片间(青色)和切片内(粉色)。
🎯 一句话对比:切片间是指令告诉硬件“这里要同步”,切片内是硬件自己发现“这里需要同步”。
这篇文章要回答的核心问题:openTPU 的切片间同步有哪些指令原语?切片内部没有指令原语,sequencer 又如何自动推断依赖?
1. 切片与同步的基础 🧩
1.1 切片是什么
切片(Slice,
otpu_slice.sv)是 openTPU 独立执行程序的最小单元。它不是一个算术单元,而是一个完整的小型处理器:一个序列器 + 一个 DMA + 一个 MXU + 一个量化器 + 一个 VPU + 一个 TMEM + 一个 ACT RAM。

-
• 🧠 子图内包含序列器、DMA、MXU、VPU、量化器、TMEM、ACT RAM 七个节点。 -
• ➡️ 序列器用单向箭头指向 DMA、MXU、VPU、量化器,表示调度关系。 -
• 🔄 DMA、MXU、VPU 与 TMEM 用双向箭头,表示读写关系。 -
• ✍️ MXU 和量化器用单向箭头指向 ACT RAM,表示写入关系。 -
• 🎨 颜色区分:控制用蓝色,DMA 用紫色,计算用粉色,存储用绿色。
1.2 为什么需要两层同步
切片是独立的,但它们不是孤立的:
-
• 🔵 切片间:多个切片要执行同一个程序(SPMD),在集合通信点必须一起停下、一起继续。这个点由 BAR/GATHER指令原语表达。 -
• 🟣 切片内:同一切片里的单元并发执行,但它们共享 TMEM、ACT RAM、DRAM 端口,必须协调访问顺序。这个协调没有任何指令原语,由 sequencer 自动完成。

-
• 🟡 切片间同步的机制是“有指令原语”, BAR/GATHER直接触发硬件屏障。 -
• 🟡 切片内同步的机制是“无指令原语”,sequencer 自动推断依赖。 -
• 🔗 两个机制各自导向不同的硬件实现。 -
• 🎨 颜色区分机制动机(黄色)和实现(绿色)。
💡 指令原语的差异:切片间同步是指令集的一部分,硬件里真的有
BAR/GATHER两条指令;切片内同步是微架构的一部分,指令集里没有对应的操作码。
🔍 两层同步的粒度不同:切片间是“指令级屏障”,切片内是“每条指令的依赖检查”。前者粗,后者细,但根本区别在于“有没有指令原语”。
2. 切片间同步:有指令原语 🌐
🔵 本章的核心:切片间同步有专门的指令原语
BAR和GATHER。 硬件看到这两条指令,才知道“这里要做屏障”。没有指令,就没有切片间同步。
2.1 SPMD 模型与无总调度器
openTPU 的多切片是 SPMD(Single Program Multiple Data) 模型:所有切片执行同一个程序,各自有独立的 sequencer,切片间没有中央调度器。

-
• 🖥️ 主机通过控制寄存器写 run、ld_start、arg,这些信号广播到所有切片。 -
• 🧠 每个切片有自己的 otpu_seq和 IMEM,独立取指、译码、分发。 -
• 🚫 切片间没有共享的程序计数器,没有全局指令队列。 -
• 🤝 唯一的切片间协调是 collective 的 BAR/GATHER,由指令原语触发。 -
• 🎨 颜色区分:主机红色,控制蓝色,序列器粉色,IMEM 绿色,collective 青色。
🎯 无总调度器:openTPU 切片间没有总调度器。每个切片有自己的 sequencer,执行同一个程序,切片间唯一的协调是 collective 的
BAR/GATHER指令。
🔵 切片间同步是“指令触发”的:硬件不会自己发现“切片 0 和切片 1 需要同步”,只有程序里写了
BAR/GATHER,硬件才在指令到来时做屏障。同步的时机由指令原语决定,不由硬件推断。
2.2 BAR 与 GATHER 两条同步指令
otpu_pkg.sv 里,BAR 和 GATHER 有明确的编码:
localparam logic [7:0] OP_BAR = 8'h05, OP_GATHER = 8'h40;
-
• 🔢 OP_BAR是8'h05,OP_GATHER是8'h40。 -
• 🎯 两条指令都归 U_COLL单元。 -
• 📊 unit_of()把这两个操作码映射到 collective 单元。 -
• 🔗 硬件看到这两个操作码,才知道“这是切片间同步”。
   function automatic int unit_of(input logic [7:0] op);
  case (op)
    OP_BAR, OP_GATHER, OP_RLD: return U_COLL;
  endcase
endfunction
-
• 🔢 unit_of()是操作码到单元的映射函数。 -
• 🎯 BAR、GATHER、RLD都映射到U_COLL。 -
• 📊 只有这三个操作码会触发 collective 单元。 -
• 🔗 其他操作码都归 DMA、MXU、VPU、QUANT。
🔵 这就是“指令原语”的含义:
BAR和GATHER不是普通指令,它们是专门为切片间同步设计的指令。硬件里有对应的操作码、单元、状态机。
两种操作的语义:
BAR(Barrier) 🔵:一种同步操作,所有切片都到达 BAR 后才继续执行。
GATHER 🟢:一种集合通信操作,把每个切片的数据收集起来,广播到所有切片。

-
• 🔵 左子图 BAR 同步:三个切片都到达后,才一起继续。 -
• 🟢 右子图 GATHER 广播:每个切片的数据收集到集合通信单元,再广播到所有切片。 -
• 🔀 BAR 只同步,不搬数据;GATHER 既同步又搬数据。 -
• 🔷 节点形状:切片用矩形,同步点用矩形粗边框,数据用矩形,collective 用六边形。 -
• 🎨 颜色区分:到达绿色,同步蓝色,数据紫色,collective 青色,广播橙色。
GATHER 的寻址模式是固定模式:
-
• 🔢 :切片号,从 0 到 S-1。 -
• 🔢 :行号,从 0 到 rows-1。 -
• 🔢 :列号,从 0 到 cols-1。 -
• 📍 dst:目标基地址。 -
• 📏 seg:每切片的数据段长度。 -
• 📏 drs:行 stride。
📊 GATHER 是固定模式收集,不是按索引数组收集。它的周期数由 rows × cols 确定,静态可算;但它的地址来自运行时寄存器,所以和前面指令的冲突关系不可静态确定,开始时间不确定。
2.3 collective 的 req/ack 机制
切片间没有共享寄存器,同步完全通过 otpu_coll 和顶层聚合信号完成。

-
• 📤 每个切片发出 coll_req,表示自己到达了 collective 指令。 -
• 🤝 每个切片给出 coll_gnt_local,表示自己的 TMEM 可以授予 collective 访问。 -
• 🔗 顶层把所有 coll_gnt_local做 AND,得到全局coll_gnt。 -
• ✅ collective 单元只有在 &req和全局 grant 都满足时才推进。 -
• 📢 完成后 coll_ack广播回每个切片,切片释放coll_req。 -
• 🎨 颜色区分:请求粉色,本地 grant 绿色,ack 蓝色,collective 青色,AND 黄色。
🔵 关键点:
coll_req不是硬件自动产生的,它是 sequencer 执行到BAR/GATHER指令时拉高的。没有指令原语,就没有coll_req,也就没有切片间同步。

-
• ⏳ 两个切片都到达后,collective 才离开 C_IDLE。 -
• 🔒 全局 grant 是所有切片 grant 的 AND,保证没有一个切片被落下。 -
• 📢 ack 同时广播,两个切片在同一周期释放请求。 -
• ⏸️ 如果某个切片的 TMEM 忙, coll_gnt_local为低,全局 grant 也为低,collective 暂停。 -
• 🕐 消息顺序反映实际的握手时序。
代码证据:
   // otpu_coll.sv:所有切片都请求才启动
C_IDLE: if (&req) begin ... st <= C_RUN; end

// otpu_top.sv / otpu_board.sv:全局 grant 是 AND
wire coll_gnt = &coll_gl;
-
• 🔗 &req是 S 位的 AND,只有全 1 才触发。 -
• 🔗 &coll_gl是每个切片 TMEM grant 的 AND。 -
• 🟢 BAR 只做同步,GATHER 还搬数据,但同步机制相同。 -
• 📝 两行代码分别定义启动条件和全局 grant。 -
• 🚦 C_IDLE是 collective 状态机的空闲状态。
2.4 全局 AND/OR 聚合信号
顶层有两个聚合信号:
   assign all_halted = &halted;              // 所有切片都 halt
assign any_error  = |error || coll_gerr;  // 任意切片 error
-
• 🏁 all_halted是所有切片 halted 的 AND,主机看到它才认为整机完成。 -
• ⚠️ any_error是任意切片 error 的 OR,加上 collective 的 GATHER 错误。 -
• 🔗 这两个信号是纯组合逻辑,没有额外握手。 -
• 🚨 coll_gerr是 collective 单元的 GATHER 错误标志。 -
• 📝 两行代码分别定义完成和错误条件。

-
• 🟢 左侧 halted 聚合:两个切片的 halted 做 AND,得到 all_halted。 -
• 🔴 右侧 error 聚合:两个切片的 error 和 coll_gerr 做 OR,得到 any_error。 -
• 🔷 AND 和 OR 操作符用六边形表示。 -
• 🔵 输出用蓝色粗边框。 -
• 🎨 颜色区分 halted(绿色)、error(粉色)、操作符(黄色)、输出(蓝色)。
2.5 编译器如何插入 BAR/GATHER
BAR 和 GATHER 指令由编译器负责插入。在 openTPU 的编程模型中,程序员通过调用高层的集合通信原语(如 ol.all_gather())来编写程序,编译器在降级过程中,会将这些高层调用精确地翻译成一条或多条 BAR/GATHER 指令。
-
• 🔵 第一行: all_gather直接映射为一条GATHER,完成数据收集和广播。 -
• 🟢 第二行: all_reduce先GATHER收集数据,再用VOP加法指令求和。 -
• 📜 编译器遵循“Nothing is scheduled behind the programmer's back”原则。 -
• 👁️ BAR/GATHER是程序语义中显式可见的集合通信点。 -
• 📊 表格两行对应两种常见集合通信原语的降级方式。
编译器主要在两种情况下插入 BAR/GATHER:
-
• ✍️ 显式调用:程序员直接调用 ol.all_gather()等原语,编译器将其直接翻译为GATHER指令。 -
• 🔄 隐式布局转换:当张量布局不匹配时(例如,数据在 TMEM 中但下一个操作需要 DRAM 布局),编译器会插入 GATHER或BAR来协调所有切片,完成数据重分布。
🔵 编译器是“指令原语的作者”:它决定在哪里插入
BAR/GATHER,硬件只是执行这些指令。这和切片内同步形成鲜明对比——切片内同步没有对应的指令原语,也就没有“作者”。
💡
BAR/GATHER指令的插入是编译器将高层集合通信语义精确翻译到 ISA 的结果,是编译器前端“布局转换”阶段的核心工作之一。
2.6 S>1 时的 hub/port 跨 SLR 同步
S > 1 时,跨 SLR 的 collective 走 hub 和 port:
-
• 🟣 otpu_coll_hub管理 ack,x_ack = pend && drained广播到所有切片。 -
• 🟠 每个切片一个 otpu_coll_port,在自己的 TMEM 上授予 collective 访问。 -
• 🔗 hub 的 u_gnt是!rd_wait && room,不依赖切片当前的 grant,避免跨 SLR 的长路径。

-
• 🟣 每个切片在自己的 SLR 内,通过 coll_port 连接到 hub。 -
• 🔷 hub 位于 collective 单元旁边,管理 ack 和 grant。 -
• 🟠 切片到 port 的连线是 SLR 内部,port 到 hub 的连线跨 SLR。 -
• 🔗 hub 到 collective 的连线用粗线,表示核心同步路径。 -
• 🎨 颜色区分:切片粉色,端口橙色,hub 紫色,collective 青色。
🎯 hub 的
u_gnt不依赖切片当前的 grant,避免跨 SLR 的长路径。ack 是pend && drained,所有 port 都写完才广播。
3. 切片内同步:无指令原语 🔧
🟣 本章的核心:切片内同步没有专门的指令原语。 程序员只写
LD、MM、VOP这类普通指令,sequencer 在分发时比较 footprint,自动推断依赖。同步的时机由硬件推断,不由指令决定。
3.1 三层同步概览
切片内同步分三层:sequencer 的 scoreboard、单元握手、TMEM 仲裁。

-
• 🧠 sequencer 向每个单元发 ucmd和ustart。 -
• ✅ 单元完成后回 udone。 -
• 📤 单元向 TMEM 发读写请求,TMEM 仲裁回 gnt。 -
• ⏸️ 没拿到 gnt的单元暂停,拿到后继续。 -
• 🎨 颜色区分:sequencer 蓝色,单元粉色,TMEM 绿色。 -
• 🟣 第一层:sequencer 的 scoreboard,自动决定“哪条指令可以启动”。 -
• 🤝 第二层:单元握手,决定“单元什么时候能接新指令”。 -
• 🔷 第三层:TMEM 仲裁,决定“多个单元同时访问 TMEM 时谁先”。 -
• 🪆 三层是嵌套的:scoreboard 决定启动,握手决定接收,仲裁决定访问。 -
• ⏸️ 每层失败都会导致单元暂停一周期,但不会永久阻塞。
🟣 关键点:这三层都没有对应的指令原语。程序员写
LD和MM,sequencer 自动发现MM依赖LD,自动等LD完成。指令集里没有“等待依赖”这种操作码。
3.2 sequencer 的 scoreboard
sequencer 用窗口和依赖矩阵同步所有单元:
   logic [WIN-1:0]  sdep [WIN];   // sdep[i][j]:槽位 i 等槽位 j
logic [WIN-1:0]  fin;          // 本周期完成的槽位
-
• 🔢 sdep[i][j]是二维位矩阵,表示槽位 i 是否依赖槽位 j。 -
• ✅ fin是本周期完成的槽位掩码。 -
• 🧮 每条指令分发时算出 footprint,和窗口里已有指令比较,写入 sdep。 -
• 🏆 每个单元每周期挑“最老的、 sdep里依赖都已fin的”指令启动。 -
• 🔓 指令完成后, fin清掉对应位,依赖它的槽位自动解锁。
🟣 scoreboard 是 sequencer 的“自动依赖检查器”:它不需要指令告诉它“MM 依赖 LD”,它自己比较 footprint 就发现了。指令集里没有“建立依赖”这种操作码。
sdep 矩阵示例:窗口 WIN = 4,四个槽位 LD → MM → VOP → ST,分发完成后的 sdep:
-
• 🔢 行是等待者,列是被等待者。 -
• 🧮 sdep[1][0] = 1:MM等LD。 -
• 🧮 sdep[2][1] = 1:VOP等MM。 -
• 🧮 sdep[3][2] = 1:ST等VOP。 -
• 📉 矩阵是下三角,因为依赖只能指向更早的槽位。
按单元分块的子矩阵:DMA = {0, 3},MXU = {1},VPU = {2}:
-
• 🔵 左上 DMA × DMA子块:两个 DMA 指令之间没有依赖。 -
• 🟣 MXU × DMA子块:sdep[1][0] = 1,MM等LD。 -
• 🟢 VPU × MXU子块:sdep[2][1] = 1,VOP等MM。 -
• 🟠 DMA × VPU子块:sdep[3][2] = 1,ST等VOP。 -
• 📊 分块矩阵直接展示“哪个单元等哪个单元”。
槽位 0 完成后,fin = [1, 0, 0, 0],sequencer 执行 sdep ← sdep & ~fin,清除后的矩阵:
-
• 🧹 sdep[1][0]从 1 变 0,MM的依赖被清除。 -
• ✅ 槽位 1 的 sdep全零,下一周期can_start变高。 -
• 🔓 槽位 2 和 3 的依赖还在,继续等。 -
• 📊 只有“依赖完成槽位的位”被清,其他位不变。
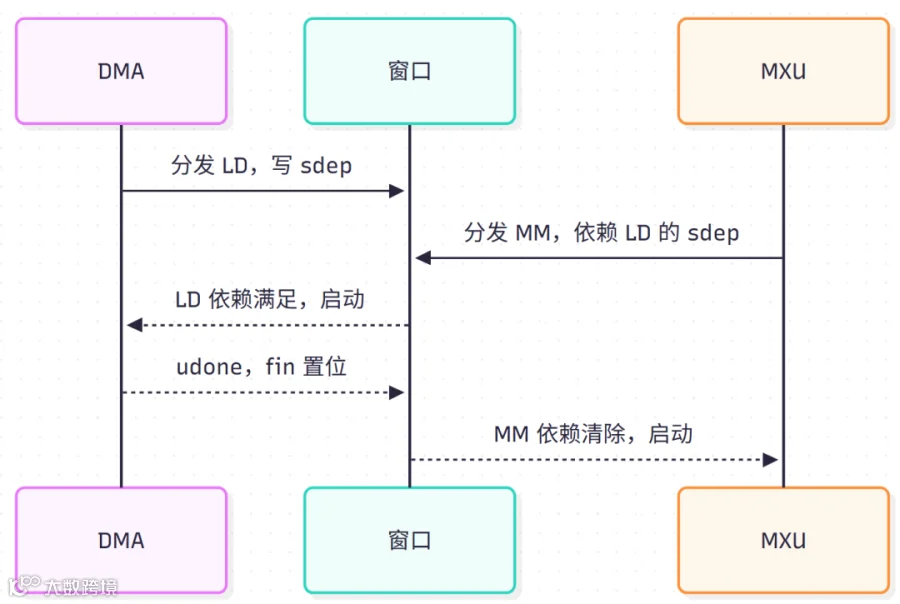
-
• 🚚 LD 先分发,MM 后分发,MM 的 sdep记录对 LD 的依赖。 -
• ✅ LD 启动、完成, fin置位。 -
• 🔓 MM 的依赖被清掉,下一周期可以启动。 -
• 🕐 消息顺序反映实际的依赖解析过程。 -
• 👥 参与者是 DMA、窗口、MXU 三方。
冲突判据:
-
• 🔗 外层 是对所有 i, j组合取逻辑或。 -
• ➡️ 第一个子项:新指令的写区间和已有指令的读区间重叠。 -
• ⬅️ 第二个子项:已有指令的写区间和新指令的读区间重叠。 -
• ↔️ 第三个子项:两个写区间重叠。 -
• 📏 ov是区间重叠函数,定义在otpu_pkg中。 -
• 🚫 读-读不比较,所以公式里没有 ov(rd, rd)。
🟣 只要一个的写范围和另一个的读/写范围在同空间重叠,就冲突。读-读不冲突。这个判据是 sequencer 自动调度的基础——程序员完全不需要知道这个公式,sequencer 自己算。
3.3 单元握手
每个单元和 sequencer 之间是标准握手:
-
• 📦 ucmd携带指令字段,从 sequencer 到单元。 -
• 🚀 ustart是单周期脉冲,告诉单元“这条指令开始执行”。 -
• 🟢 urdy是单元的状态,低表示单元忙,不能接新指令。 -
• ✅ udone是完成脉冲,sequencer 用它清sdep和sstarted。 -
• 🔓 urel是 MXU 两阶段握手的第二阶段。
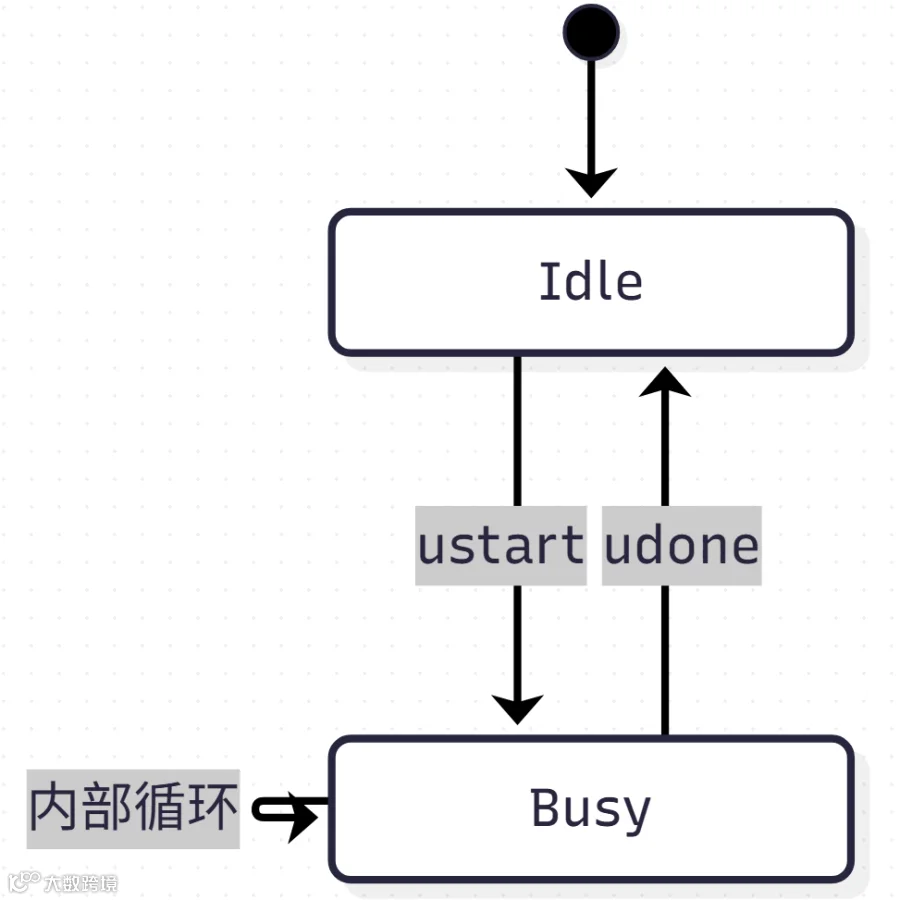
-
• 🟢 Idle 是空闲状态, urdy为高。 -
• 🔴 收到 ustart后进入 Busy,urdy变低。 -
• 🔄 Busy 内部可能有循环(如 DMA 搬多个 chunk),但对外仍是 Busy。 -
• ✅ 完成后回 udone,回到 Idle。 -
• 🎨 颜色区分空闲(绿色)和忙碌(粉色)。
🟣 MXU 是唯一有两阶段握手的单元:
ustart只检查 DRAM 依赖,urel检查全部依赖。ustart让 MXU 提前预取,urel保证消费时机正确。这个两阶段握手也是 sequencer 自动管理的,指令集里没有对应的操作码。
3.4 TMEM 仲裁
多个单元同时访问 TMEM 时,仲裁器按组授予:
logic [NG-1:0] gnt; // DMA, COLL, VPU, MXU, QUANT
-
• 🔢 gnt是 5 位的 grant 向量,对应五个组。 -
• 🔒 每个组一个 grant 位,全有或全无。 -
• 🚫 没拿到 grant 的单元,本周期 r_en和w_en被强制清零。 -
• ⏸️ 单元内部暂停,下一周期重新仲裁。 -
• 🏆 仲裁顺序是 DMA、COLL、VPU、MXU、QUANT。

-
• 📤 单元发请求,仲裁器决定授予或拒绝。 -
• ⏸️ 拒绝时进入 Stall,下一周期重试。 -
• ✅ 授予后访问完成,回到 Idle。 -
• 👁️ 这个过程对单元是透明的,单元只看到“这一周期没推进”。 -
• 🎨 颜色区分空闲(绿色)、请求(蓝色)、授予(青色)、暂停(粉色)。
🟣 仲裁是“软同步”:抢不到端口暂停一周期,不是永久阻塞。下一周期可能抢到,单元自动继续。指令集里没有“申请 TMEM 端口”这种操作码,仲裁完全是硬件行为。
-
• 🔄 TMEM_RPL模式下,丢失的读会重放,单元暂停到重放成功。 -
• 🔒 仲裁器不改变程序的顺序语义,只影响执行时间。
3.5 三条显式同步指令
切片内同步绝大部分是隐式的,但确实存在三条显式同步指令:WAITW、HALT CHAIN、RLD。它们和切片间的 BAR/GATHER 不同——BAR/GATHER 同步的是切片之间,这三条同步的是切片内部的模块之间。
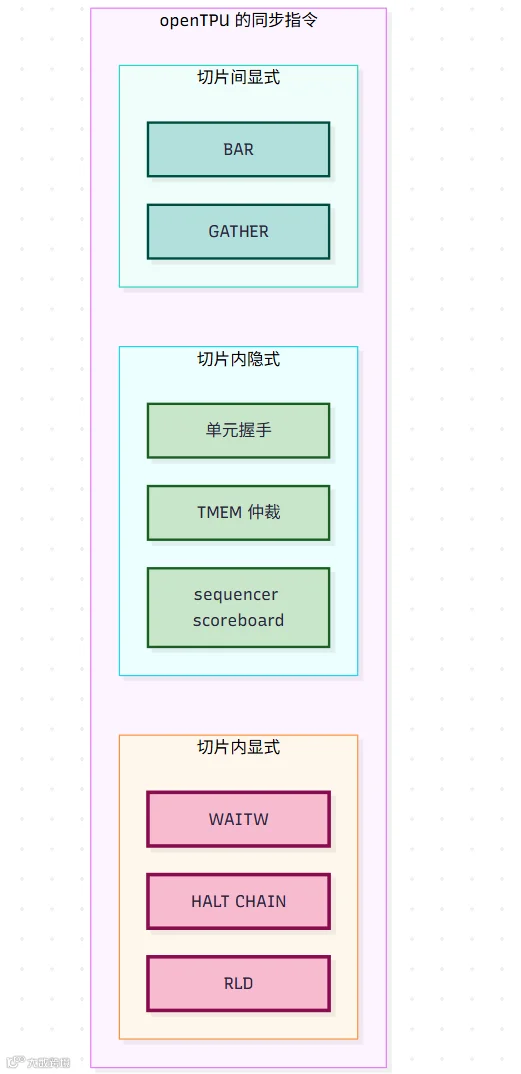
-
• 🔵 切片间显式: BAR、GATHER,同步切片之间的执行。 -
• 🟣 切片内显式: WAITW、HALT CHAIN、RLD,同步切片内部模块之间。 -
• 🟢 切片内隐式:scoreboard、握手、仲裁,硬件自动完成,不是指令。 -
• 🎨 颜色区分三类同步机制。
💡 注意:切片内的三条显式指令仍然是“指令原语”,但它们不是“切片内依赖同步”的原语,而是“跨模块时序约束”的原语。切片内的依赖同步仍然完全隐式。
WAITW:等主机写入某个字 ⏳
WAITW 是 DMA 执行的指令,显式等待 DRAM 里某个字满足条件。它是主机与加速器之间的同步点。
OP_LD, OP_ST, OP_DSTEP, OP_STREAM, OP_WAITW: return U_DMA;
-
• WAITW 归 DMA 单元执行。 -
• 它读一个 DRAM 字,比较,不满足就等 ww_iv周期再读。 -
• 超过 ww_to周期就超时,切片进入 ERROR。

-
• 🔵 读 DRAM,数据回来。 -
• 🟡 比较条件,成立就完成。 -
• 🟠 不成立就等,等完再读。 -
• 🔴 超过 ww_to就超时,切片停止。 -
• 🟢 条件成立,WAITW 完成。
🎯 WAITW 是切片内唯一的“主机同步指令”:它让加速器等主机写入某个字,是 host 与 accelerator 之间的显式握手。
HALT CHAIN:等所有写落地再重载 🏁
HALT CHAIN 是序列器执行的指令,显式要求
wr_idle为高才重载程序。它是DRAM 写与程序重载之间的同步点。
   if (sq_halted && sq_ch && wr_idle_i) begin
  c_rst <= 1'b1; c_ld <= 1'b1;
  c_addr <= sq_cha; c_n <= sq_chn;
end
-
• HALT 带 CHAIN 标志时,序列器不直接停,而是等 wr_idle_i。 -
• wr_idle_i是所有 DRAM 写都落地的信号。 -
• 只有写落地,才重载下一段程序。

-
• 🏁 序列器执行 HALT CHAIN。 -
• ⏳ 等 DMA 报告 wr_idle。 -
• 📤 DMA 把所有写发到 DRAM。 -
• ✅ DRAM 写落地,DMA 回 wr_idle。 -
• 🔄 序列器重载程序,继续执行。
🎯 HALT CHAIN 是切片内唯一的“DRAM 同步指令”:它让程序重载等所有写落地,防止下一段程序读到旧值。
RLD:等 TMEM 字回来再继续 🔄
RLD 是集合通信单元执行的指令,显式读一个 TMEM 字到寄存器。它是TMEM 读与后续指令之间的同步点。
   if (op == OP_RLD) begin
  rl_wait <= 1'b1;
  rl_rd <= rd;
end
-
• RLD 启动时, rl_wait拉高,阻止后续指令。 -
• 字回来后, rl_v拉高,写入寄存器,rl_wait拉低。 -
• 后续指令才能继续。

-
• 🔄 序列器执行 RLD。 -
• 📤 coll 单元读 TMEM。 -
• ✅ 数据回来, rl_v拉高。 -
• 🔓 序列器 rl_wait拉低,后续指令继续。
🎯 RLD 是切片内唯一的“TMEM 同步指令”:它让后续指令等 TMEM 字回来,防止读到旧值。
为什么只有这三条
切片内部的隐式同步已经覆盖了大部分场景:
-
• 🧮 数据依赖:scoreboard 自动比较 footprint,不需要指令。 -
• 🤝 资源冲突:TMEM 仲裁自动处理,不需要指令。 -
• ✅ 完成通知: udone脉冲自动清依赖,不需要指令。
但这三种场景隐式同步做不到:
-
• ⏳ 等主机写入:主机什么时候写,硬件不知道,必须显式 WAITW。 -
• 🏁 等所有写落地:程序重载需要知道 DRAM 写是否完成,必须显式 HALT CHAIN。 -
• 🔄 等 TMEM 字回来:后续指令的地址依赖这个字,必须显式 RLD。
🎯 显式同步指令只用在“硬件无法自动推断”的场景:主机行为、DRAM 写完成、TMEM 读返回值。其他场景都交给隐式同步。
4. 两层同步的对比 ⚖️
🎯 本节的核心:切片间有指令原语,切片内没有指令原语。 这个区别决定了硬件如何知道“这里需要同步”。
-
• 🔵 第一行:同步指令原语的有无,是两层同步最本质的区别。 -
• 🔗 第二行:硬件如何知道要同步,切片间靠操作码,切片内靠 footprint 比较。 -
• 🎯 第三、四行:同步原语和粒度不同。 -
• ⏸️ 第五、六行:决定时机的方式和阻塞方式不同。 -
• 🌉 第七行:切片间跨 SLR,切片内不跨。 -
• 💰 第八、九行:硬件和编译器的开销分工不同。 -
• 📊 表格整体说明两层同步的互补关系。
🔵 切片间是“指令告诉硬件”:程序员/编译器写
BAR/GATHER,硬件在指令到来时做屏障。同步的时机是指令集的一部分。🟣 切片内是“硬件自己发现”:sequencer 在分发时比较 footprint,自动发现依赖,自动 stall。同步的时机是微架构的一部分,指令集里没有对应的操作码。
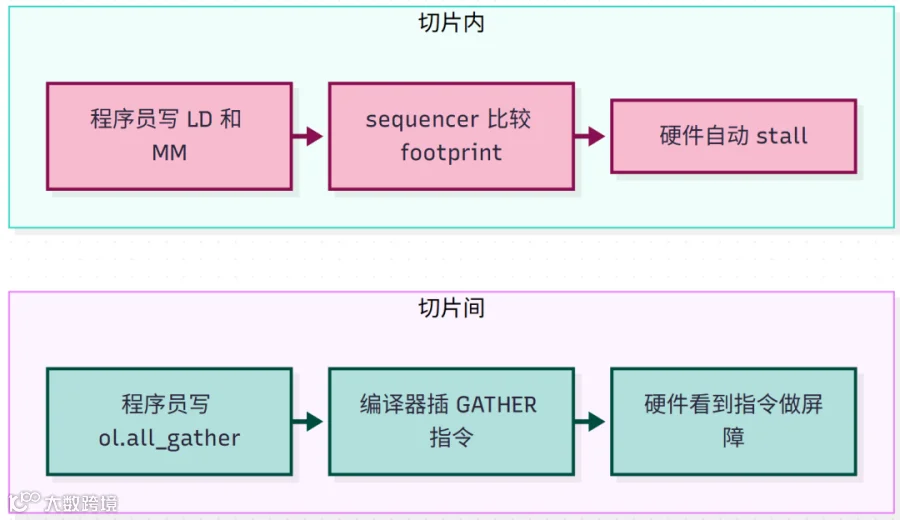
-
• 🔵 切片间:程序员显式调用 ol.all_gather,编译器翻译成GATHER指令,硬件做屏障。 -
• 🟣 切片内:程序员只写 LD和MM,sequencer 自动比较 footprint,硬件自动 stall。 -
• 🔗 两条链的硬件触发条件不同:切片间是指令原语,切片内是 footprint 比较。 -
• 🎨 颜色区分切片间(青色)和切片内(粉色)。
5. 总结 🎯
5.1 切片间同步:有指令原语 🔵
-
• 🧩 SPMD 模型,每个切片有自己的 sequencer,没有总调度器。 -
• ✍️ BAR/GATHER是专门的同步指令原语,硬件看到操作码才做屏障。 -
• 🤝 collective 的 req/ack 是唯一的切片间协调点。 -
• 🔒 全局 grant 是所有切片 grant 的 AND,保证没有一个被落下。 -
• 🏁 all_halted和any_error是纯组合聚合信号。 -
• 🌉 S > 1 时走 hub/port,跨 SLR 的路径用寄存器切片隔离。
🔵 切片间同步的时机由指令原语决定:程序员写
BAR/GATHER,硬件才做屏障。没有指令,就没有同步。
5.2 切片内同步:无指令原语 🟣
-
• 🪆 三层同步:scoreboard、单元握手、TMEM 仲裁。 -
• 🧮 scoreboard 用 footprint 比较和 sdep矩阵自动决定依赖,指令集里没有对应操作码。 -
• 🤝 单元握手用 ustart/udone/urdy协调启动和完成。 -
• 🔷 TMEM 仲裁按组授予,抢不到暂停一周期。 -
• ⏳ 三条显式同步指令 WAITW、HALT CHAIN、RLD处理跨模块时序约束,但不是“依赖同步”的原语。
🟣 切片内同步的时机由硬件推断:sequencer 自动比较 footprint,自动发现依赖,自动 stall。指令集里没有“等待依赖”这种操作码。
5.3 一句话
openTPU 的同步分两层:切片间有专门的指令原语
BAR/GATHER,硬件看到指令才做屏障;切片内没有指令原语,sequencer 自动比较 footprint 推断依赖。前者是“指令触发的同步”,后者是“指令之外的同步”。两层各司其职,共同保证多切片并行执行时的正确性和效率。 🎯