
给 LLM agent 外挂长期记忆,这两年成了显学。Mem0、MemOS、A-MEM……框架一个接一个,但几乎所有框架都有一个共同的隐含假设:找一个通用大模型,配上框架特定的提示词,让它负责往记忆里写东西。
腾讯混元刚刚开源的 Hy-Memory 2.0,正面挑战这个假设。他们认为记忆系统的质量不取决于检索,而取决于"写入路径"——该记住什么、用什么精度表述、新证据如何更新旧状态。围绕这个判断,他们做了三件事:把记忆框架开源(Hy-Memory 引擎)、专门训练一个只干"写记忆"的模型(Hy-Memory-30B-A3B,激活仅 3B)、再做一个桌面应用 MemHub 让十种 AI 工具共享同一份记忆。10 月 16 日,三层全部开源。
先看最抓眼球的数字:这个 3B 激活的小模型作为"记忆写入器"接入 Mem0、MemOS、Hy-Memory 以及训练时从未见过的 EverMemOS 四套系统,六指标宏平均 55.49,压过闭源的 Claude Opus 5(54.62)和开源的 DeepSeek V4.1 Flash(53.64),四套系统全部第一。
一、重新理解记忆:不是检索问题,是写入问题
Hy-Memory 的理论地基是混元 5 月发表、被 EMNLP 2026 接收的 DCPM 论文(arXiv 2606.09483,论文中以 DCPM 命名,即 Hy-Memory 框架的底层设计)。论文开宗明义:LLM agent 的长期记忆,不等于在正确的时间检索出正确的段落。现有记忆系统把信念修正、因果耦合、跨域抽象全压进同一个面向表层召回的检索面里,所以在需要推理"用户如何演变"的隐式个性化任务上集体翻车。
他们借双过程理论(卡尼曼的 System 1 / System 2)把记忆组织成一座能力金字塔:底层是被动的原始输入与原子事实,中层是结构化的版本化事实、跨会话一致性、时序推理,顶层是主动的图式、意图和跨域模式。
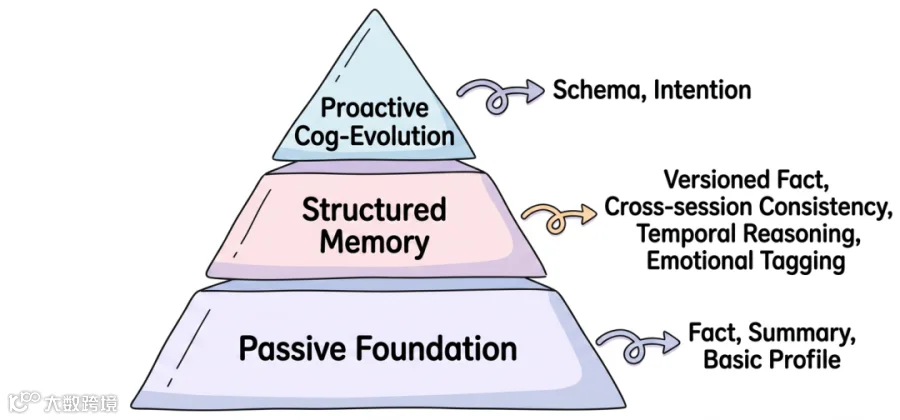
▲ 记忆能力金字塔:Passive Foundation → Structured Memory → Proactive Cog-Evolution(图源:DCPM 论文,下同)
两个系统分工执行:System 1 是同步的"白天写手"——用户每次对话后秒级响应,抽取身份项和原子事实,对每条新信息与记忆库做调和(新增 ADD / 取代 SUPERSEEDE / 补充 UPDATE)。取代不删旧记录,而是写双向指针串成"取代链",读取时一次命中加指针遍历就能还原完整演变轨迹。这条设计让"你去年说吃素、上个月说偶尔吃鱼"这类时序因果,不再被 embedding 相似度淹没。

▲ DCPM 双系统架构:左为 System 1 白天写手,右为 System 2 夜间清扫引擎(聚类→归纳图式→跨域碰撞检测)
System 2 是异步的"夜间引擎"——趁你睡觉,它先无 LLM 地对新事实做分诊聚类,再让归纳 agent 在图上写出图式与意图,最后跑一个跨域扫描器:专门找"行为上很像、语义上很远"的记忆对,抽象成更高层的核心图式。论文做了一个可检验的预测并验证了它:System 2 在单轮事实召回上几乎没贡献,但在隐式跨域推理上贡献最大——PersonaMem-v2 上最高 +5.20 分。
二、引擎 2.0:三类记忆,四个 benchmark 开源框架第一
框架层面,Hy-Memory 2.0(pip 包 hy-memory==2.0.4)在 1.0 的聊天记忆之外新增了两类记忆,自称业界首个:
聊天记忆升级:从零散事实升级为完整的事件脉络——以事件为主体梳理时间地点人物,关联后续发展;多条线索要先合并重复、剥离冲突,再把干净记忆交给模型。工作记忆:记住任务做到哪里、经验何时适用——多维记录任务目标、已确定做法、阶段结果和可复用经验,复用前先判断适用条件是否满足。代码记忆:记住代码为什么这样改——长程任务每次续作前先判断当前在处理哪件事,找回相关决定、仍然适用的经验和历史工作过程。
官方在聊天、工作、代码三类场景的四个 benchmark 上对比了 Mem0、MemOS、EverOS、OpenViking、RepoMemory 和 Simple RAG:LoCoMo 准确率 72.6%、MemoryArena 平均分 55.31%(领先次优 EverOS 整整 10.2 个百分点)、CodeMemoryBench 问答 64.2% / 解决率 35.6%、SWE-ContextBench 解决率 28.3%——全部开源框架第一。而且按"记忆库 token 占用 ÷ 输入 token"的存储效率画散点图,Hy-Memory 三个场景都压在左下角:效果更好,占的存储还更小。
三、模型:两阶段训出来的"记忆写手"
再看专门训的模型。Hy-Memory-30B-A3B 是 MoE 架构,总参数 30B、激活约 3B,Apache-2.0 协议,HuggingFace 上月下载 2,145 次。它不回答问题,只做一件事:替换 Mem0、MemOS、Hy-Memory 框架内部负责写记忆的通用 LLM。框架的记忆逻辑一行不动,只换里面的模型——这就是它的卖点:降本(3B 激活替代大模型)、可迁移(一个 writer 通吃多家框架)。
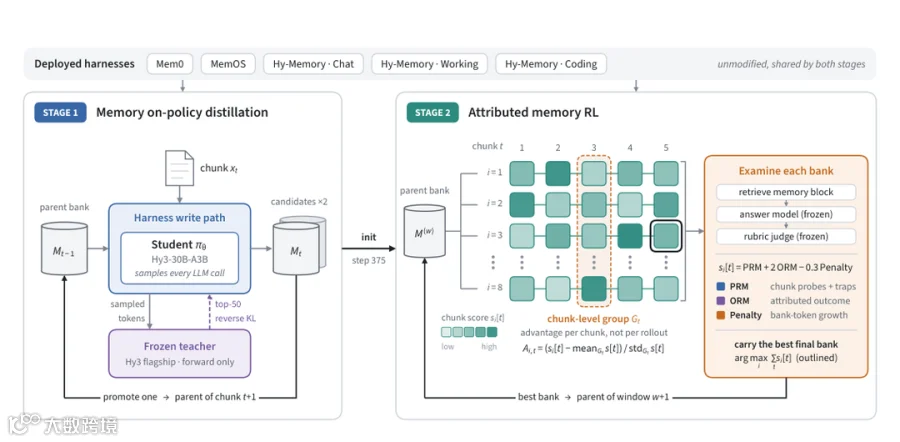
▲ 两阶段训练全貌:左 OPD(学生写、教师改),右 Attributed Memory RL(8 条 rollout × 5 个 chunk 的打分网格,按 chunk 列归一化优势)
训练分两步,都在真实部署形态的 harness 里进行(这是刻意设计:训练分布 = 部署分布)。
第一阶段:Memory On-Policy Distillation(记忆在策略蒸馏)。学生(Hy3-30B-A3B)在真实 harness 里自己写记忆状态,冷冻的大教师模型(Hy3 旗舰版)对每个状态打分,反向 KL 挑出 top-50 候选,最优者晋级为下一个 chunk 的父状态。关键是"在策略":学生看到的是自己写出的记忆库,而不是标注出来的理想库。
第二阶段:Attributed Memory RL(归因记忆强化学习)。论文的核心贡献全在这。先说它要解决的问题:普通 RL 给整条轨迹打一个终局分,但记忆轨迹里一个早期会话的写入可能决定了十轮之后某个答案的对错——终局分会淹没异质动作序列里真正的功劳和锅。他们的解法是 chunk 级归因。
四、把"奖励"当工程:16 万探针、8 千陷阱、6 万道考题
RL 的前提是奖励信号。他们先造了一个庞大的"奖励工件":从真实用户会话切出 12,671 个窗口、57,616 个 chunk,然后跑两种标注通道——
逐块探针(PRM):针对每种具体写失败模式出题:遗漏、精确性丢失(名字/数字/版本号记不准)、语义反转(否定和范围写反)、过时状态混淆、次要维度被主话题抹掉、过度存储。还有一类很刁钻的陷阱探针:问候语、空洞的客套、助手通用话术——这些东西"不该进长期记忆",如果 writer 存了,检索就会暴露它,答案就错。陷阱探针直接堵死"全都存下来"这条捷径——单纯压缩文本变短是躲不开的。
跨块结局题(ORM):考的是跨 chunk 甚至跨会话的关系,每道题绑定"标准事实"(gold facts),只给结局裁判看——这些标准事实不进记忆库、不进检索、不进答案模型的提示词,纯粹用于把结局得分归因回"是哪一个 chunk 写下的证据"。奖励数据还要过四层质检:模式合法性、因果局部性、评分项独立性、可区分性(裁判对五档合成答案的打分必须单调,实测分离度 0.95/0.87)。

▲ 奖励工件流水线:会话切块 → 双通道标注 → 四层质检 → 最终产出 16.5 万探针、8.6 千陷阱、约 6.1 万结局题、22.2 万标准事实引用
打分时还有个三模型隔离的讲究:策略模型(被训练的那个)、答案模型(DeepSeek V4.1 Flash,冷冻)、裁判(冷冻)互相看不到对方不该看的东西。读者被冻结,写者的缺陷就无处藏身——如果答案变好,那只能是记忆库真的变好了,而不是检索或作答变聪明了。
最终 chunk 得分 s[t] = PRM + 2×ORM − 0.3×惩罚项。惩罚项按记忆库 token 增量占输入比例算,超阈后指数增长,专治"库越写越肥"。GRPO 也改了:优势按"窗口 × harness × 会话 × chunk 位置"分组归一化——同一条 rollout 可以在第 2 个 chunk 拿最高分、在第 4 个 chunk 垫底,每个 chunk 按自己的列投票。窗口结束后选总分最高的记忆库带进下一窗口,保持训练与部署一致。
第二阶段用 128 张 H20 GPU,每批 64 窗口 × 8 rollout = 512 条轨迹,PPO 式裁剪代理、无 KL 惩罚,MoE 路由按 rollout 回放。
五、结果:四套系统全第一,留出的一套也没翻车
评测设计同样讲究"只换 writer":harness 版本、提示词、检索配置、答案模型、裁判全部固定,每个 writer 从空库开始建自己的记忆银行,测试样本和评分规则完全一致。四个 harness 各用六个指标(LoCoMo 评审、LongMemEval、PersonaMem-v2、旅行规划、组合购物、代码记忆基准),各在固定 20% 子样本上评测。
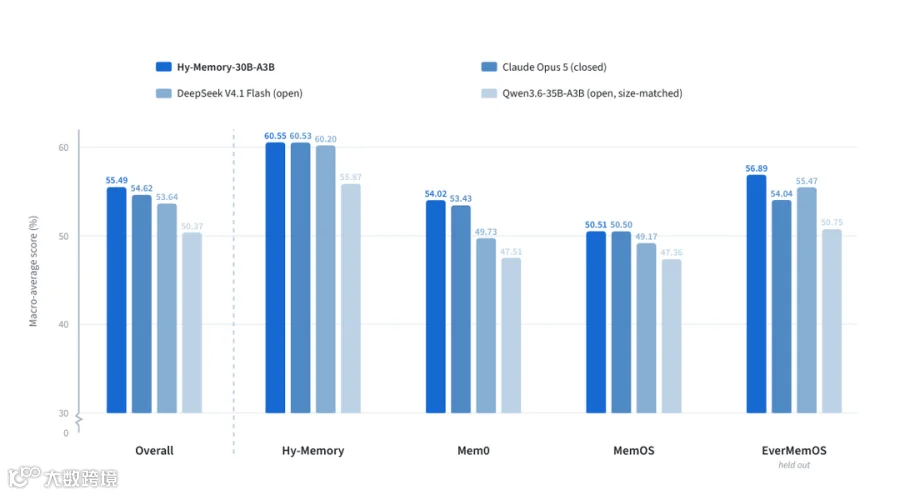
▲ 四套 harness 宏平均分:Overall 55.49 vs Opus5 54.62、DeepSeek V4.1 Flash 53.64、同尺寸 Qwen3-30B-A3B 44.37;EverMemOS 为训练未见的留出系统
结果:Hy-Memory-30B-A3B 宏平均 55.49,第一;Claude Opus 5(闭源)54.62,第二;DeepSeek V4.1 Flash 53.64;自家通用模型 Hy3 51.63;同尺寸的 Qwen3-30B-A3B 44.37。四个 harness 各自的第一也都是它——包括 训练时从未见过的 EverMemOS(56.89 vs Opus 5 的 54.04)。从基座 Hy3-A3B Base 的 47.66 到训后 55.49,记忆专项训练净涨 7.8 分,说明这部分能力确实是训出来的,不是基座自带。
六、MemHub:十种 AI 工具,共享一份记忆
应用层 MemHub 是本地优先(local-first)的桌面端 + CLI 产品:在用户授权的 AI 应用(Claude Code、Cursor、Codex、OpenCode、Qwen Code 等)之间,把对话历史和编码痕迹统一进一个本地数据目录和一个受管运行时,实现跨应用的记忆召回。10 月已发 v1.0.4 和 memhub-cli 1.0.5,带签名版 macOS 桌面端。模型侧还追发了 FP8 和 GGUF 量化版本,方便本地部署。
所以整体图景是:模型(记)+ 引擎(管)+ 应用(用)三层,每层可独立用,也可组合成完整的 Agent 记忆方案。记、管、用三个字,官方网站的排版就是这么分的。
七、我的几点想法
第一,这套工作最有价值的洞见是把"记忆"从检索问题重新定义为写入问题。过去一年记忆框架的军备竞赛几乎全在检索侧打转,Hy-Memory 说质量瓶颈在 write path,并且用一个可复用的专门 writer 证明了它——同一颗 writer 换四个框架都是第一,这个实验设计本身就很有说服力。
第二,chunk 级归因 RL 的工程细节值得做 agent 训练的人细读:陷阱探针堵"全存"捷径、token 增长指数惩罚堵"库膨胀"、三模型隔离堵"读者作弊"、gold-fact 归因堵"终局分广播"。每一条都在堵一种常见的 reward hacking 路径——奖励工件按仪器标准做质检(可区分性 0.95 分离度)这个做法,应该会成为 agentic RL 数据构造的标配。
第三,3B 激活打赢 Opus 5 这件事要冷静看:比的是"作为记忆写入器"的窄任务,不是通用能力;而且 55.49 对 54.62 的差距不到 1 分,在 20% 子样本上,属于"可靠但不大"的领先。真正值得关注的是方向——当某个环节被拆成独立可训的任务,专用小模型替代通用大模型就开始划算。这个逻辑不止适用于记忆。
第四,对做产品的读者:DCPM 的 System 1/2 拆分(白天秒级写入、夜间慢速抽象)和 MemHub 的"本地优先、跨应用统一记忆",分别是架构设计和产品形态上很少被认真做的选择。尤其是 MemHub——如果你的记忆散落在五个 AI 工具里,每个工具各自记一半,那"个人记忆"就是个伪命题。
最后照例泼点冷水:benchmark 第一不等于真实用户体感第一,记忆系统的评测至今没有让人完全信服的方案,20% 子样本上的 1 分优势更要等社区复现。但"框架不动、只换 writer、留出系统上仍领先"这三件事加在一起,已经是这个领域目前少有的干净证据链了。
参考:Hy-Memory 2.0 官网(memory.hunyuan.tencent.com);Fei et al., "Memory Beyond Recall: A Dual-Process Cognitive Memory System for Self-Evolving LLM Agents", EMNLP 2026(arXiv 2606.09483);Fei et al., "Hy-Memory-30B-A3B: Attributed Reinforcement Learning for Long-Term Memory Writing"(arXiv 2610.22196);模型与代码:huggingface.co/tencent/Hy-Memory-30B-A3B(Apache-2.0)、github.com/Tencent-Hunyuan/Hy-Memory。文中图表来自上述论文与官网,版权归腾讯混元所有。
1.20K-40K!深圳扬奇医芯招双目结构光算法工程师
2.AI教父Hinton诺奖演讲首登顶刊!拒绝公式,让全场秒懂「玻尔兹曼机」
3.GitHub没了?CEO辞职,微软接管,开发者天塌了
4.AI颠覆数学研究!菲尔兹奖得主、华裔数学家领衔11篇顶刊论文|陶哲轩转赞
5.AI OS,下一个二十年的超级平台
6.全球首个IMO金牌AI诞生!谷歌Gemini碾碎奥数神话,拿下35分震惊裁判