

10月30日,DiffuSpace 在 Hugging Face 博客放出 Clover-35B-A3B-Preview:Apache 开源权重,GitHub 与 ModelScope 同步可下。前身能追溯到港大 Dream 7B 那条扩散语言模型线;底座自报源自 Qwen3.6-35B-A3B,总参 35B、每 token 约激活 3B,并带 thinking 模式,上下文 128K(模型卡写提示+生成合计上限 131072)。
表面上还是 35B MoE,真正换的是解码方式。解码改成了按块并行去噪:一块里多个位置一起填,不再一个 token 接一个 token 往外吐。
本号的判断:架构反差值得盯,但别把「开源可下」听成「笔记本随便跑」。单卡 GB300 上约 680 tok/s、H200 约 515 tok/s,都是数据中心卡上的自报速度;更贴近多数读者的门槛,是官方称 INT4 能塞进 RTX 5070 Ti 的 16GB——而且分数、速度一律是 DiffuSpace 自报,第三方总榜还没对上之前,先当厂家说明书读。
01
PART
扩散整块生成,和自回归差在哪
DIFFUSION

自回归模型(绝大多数聊天模型)是:猜下一个词 → 再猜下一个。Clover 走 block diffusion:每一块先铺满 mask,置信度够的位置一起落字,整块定稿后再当下一块的前缀。模型卡默认 `block_size=32`、`threshold=0.95`;结构上仍是混合 Gated DeltaNet / 全注意力 MoE,40 层、256 路由专家、top-8,外加每层一个共享专家——这些都写在模型卡里。
DiffuSpace 说,这样在 agent 负载里反馈环更短:改一行、调一次工具、再看结果,延迟会叠。博客里还举了浏览器搜路线、连续办六件业务、一屏 HTML 桌面等演示;那些是官方演示,本号没有复现。
对选型的人,记住一句就够:快,来自「一块里并行填」,不是来自「参数变少到手机能跑」。 港大 Dream 线证明过扩散语言模型能跟自回归掰手腕;Clover 要答的下一问是:参数放大之后,速度优势还在不在。官方答案是「还在,而且自称能压同规格自回归」——读者该做的,是把这句话拆成「架构可能真快」和「分数先当自报」。
02
PART
自报分数怎么读
SCORES
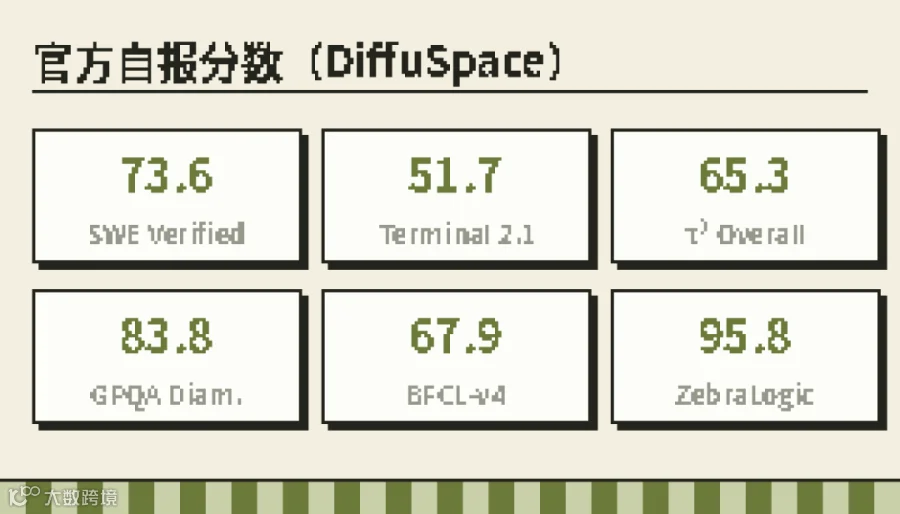
官方对照里,Clover 自称在多套 agent 题上压过同规格自回归的 Qwen3.6-35B-A3B,也压过 LLaDA2.2 flash、Mercury 2.5 等扩散同行。核到的自报数字包括:SWE-bench Verified 73.6;Terminal-Bench 2.1 51.7;τ³ Overall 65.3;GPQA Diamond 83.8;ZebraLogic 95.8;AA-LCR 72.0;BFCL-v4 67.9;MMLU-Pro 84.8。
全部标 DiffuSpace / 官方博客自报。 同日没有看到 Artificial Analysis 总榜对照;厂家表别直接念成「开源第一」。真要上线,拿 30–50 道自家业务题压一遍,比转述榜单靠谱。
03
PART
显存与量化:你真正要看的门槛
VRAM
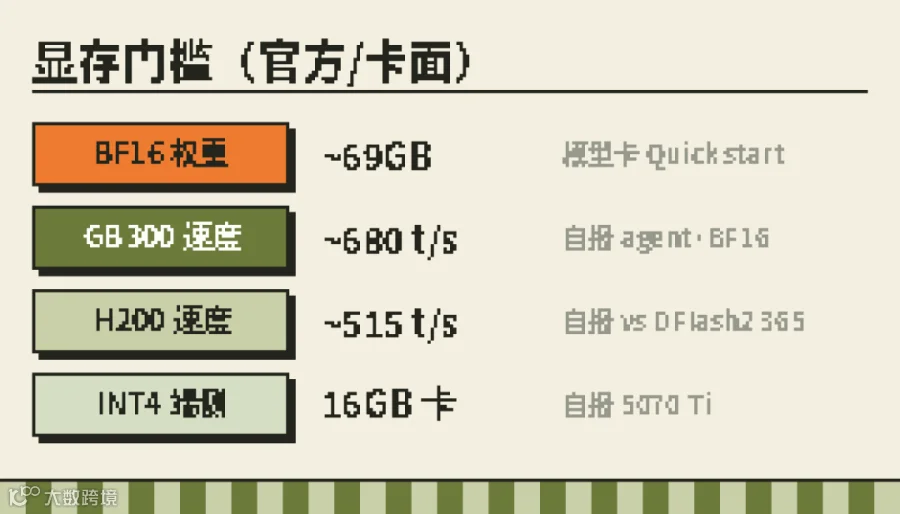
模型卡 Quick start 写明:BF16 权重大约 69GB,外加推理状态。完整精度基本就得大卡,或拆多卡。
端侧一节,官方称已用 INT4 部署到 NVIDIA RTX 5070 Ti 16GB;MATH-500 上自报生成速度 101.8 tok/s,对照同规格 MiniCPM / Qwen 一类约 48.5 tok/s。这是他们自己的对照,不是本号实测。
速度数字也别误读:单卡 NVIDIA GB300、BF16、batch=1、内部 agent 负载约 680 tok/s;单卡 H200 同类负载约 515 tok/s,对照 DFlash2 加速的同规格 Qwen 约 365 tok/s。GB300 / H200 是机房卡。你若只有一张 24GB 消费卡,既对不上 680,也不等于「16GB INT4」已经社区量化包齐备——先去 HF / ModelScope 看实际有没有你能下的量化文件,再谈本机。
许可是 Apache,权重在 Hugging Face 与 ModelScope 两处都能下。推理官方推 SGLang(服务与评测)和 llama.cpp;Transformers 路径也能跑,但卡面写明:小数值差可能导致和 SGLang 生成结果不完全一致,正式评测与线上服务优先跟官方 SGLang 说明走。
04
PART
现在怎么动手
CHECKLIST
按下面五步过一遍,比先收藏博客更有用。

-
先读 HF 博客与模型卡,确认 Apache、128K、thinking、BF16≈69GB 这几条和你业务是否相关。 -
有大卡 / 租卡:按官方仓装 SGLang,用 agent 真题看延迟,别只看博客 tok/s。 -
只有 16GB 级显卡:盯 INT4 / 量化发布是否到位;没有现成包就别把「能塞 5070 Ti」写进本周上线计划。 -
分数只当线索:SWE / Terminal / BFCL 自报再高,也要用自家仓库与工具链复测。 -
对照物其实很近:同规格 Qwen3.6-35B-A3B 就是底座出处。你要比的是「扩散加速值不值那套新推理栈」,不是凭空多出一个外星模型。
你会先等量化包和 SGLang 文档稳了再下,还是直接找同规格 API / 继续用 Qwen 线?正在算私有化显存账单的同事,可以把这篇转给他。
出处:DiffuSpace Hugging Face 博客《Clover-35B-A3B-Preview》(10月30日);模型卡 Diffuspace/Clover-35B-A3B-Preview;GitHub DiffuSpace/Clover-35B-A3B-Preview。跑分与速度均为官方自报。
往期 · 接着看
Mistral开源Le Chonk:非中国开源榜首,本地2bit仍要约380GB
Recursive开源Flint:说笔记本125token/秒,BF16原版约80GB
Ornith开源122B说单卡能跑:原版250GB,真正塞进80GB的是4bit版
觉得有用的话,欢迎点赞、收藏、评论。
THANKS FOR READING