

在上篇介绍 NVIDIA Minerva 的文章(万卡集群的运维算盘)中,我们讨论了大规模 GPU 集群在可观测性层面的挑战。Minerva 的核心功能在于通过全栈遥测数据与动态拓扑图谱,解决分布式训练中的隐性退化与微弱网络拥塞检测,将故障定位收敛到具体的硬件端口或物理节点。
然而,在大规模分布式训练的运维闭环中,检测与定位仅完成了前半程。
当监控系统判定某个节点存在性能退化时,运维人员仍需经历以下流程:
-
接收告警并人工确认故障节点; -
手动在调度系统中隔离异常节点(如执行 cordon和drain); -
评估剩余可用算力的物理网络拓扑,挑选适配的空闲节点组合; -
重新提交作业配置,加载最近的检查点(Checkpoint)恢复分布式任务。
在数千至数万张 GPU 协同运行的高性能计算环境中,人工介入带来的平均恢复时间(MTTR)通常在数十分钟至数小时不等,集群在这段空窗期内不得不处于算力闲置状态。
这正是英伟达推出 NVIDIA Mission Control 2.5 的技术背景:将原本用于超算的自主故障自愈能力,延伸到主流的云原生 Kubernetes(K8s)体系中,完成从故障诊断到自动隔离与任务重拉的控制闭环。
一、 分布式训练在 Kubernetes 环境下的自愈难点
在传统微服务架构中,Kubernetes 原生的 Pod 崩溃重启策略足以应对绝大多数单点故障。但在分布式 AI 训练场景下,这套机制往往无法直接生效。
首先,大模型训练普遍采用 3D 并行,各节点通过 NCCL 算子保持严格的通信同步。集群中任何一个节点掉线或退化,全局通信拓扑即刻中断。原生 K8s 无法仅通过重启单一容器来维持整体训练进程。
同时,训练中断的原因多样,涵盖瞬态网络丢包、CUDA 临时异常,以及显存物理坏道或 PCIe 掉卡等硬件损坏。若未经验证直接下线节点,会导致健康算力被过度隔离;若在原节点盲目拉起容器,则极易引发循环报错。
目前原生 K8s 调度器主要考量节点的 CPU、内存与 GPU 数量配额,缺乏对多轨网络、NVLink 域以及 InfiniBand/Spectrum-X 交换层级的精细感知。随机分配的恢复节点可能破坏原有的通信局部性,导致后续训练吞吐量显著下降。
二、 Mission Control 2.5
Mission Control 在 2025 年 3 月发布的 1.0 版本中,当时系统主要作为数据中心基础设施的统一控制底座,集成了 Base Command Manager(BCM)、DCGM 探针与固件管理工具,侧重于裸机生命周期管理与集群部署,作业调度主要依赖传统的 HPC 调度器 Slurm。
到了 2026 年 7 月的 2.0 至 2.3 版本,系统完成了底层控制面的架构重构,适配了 Blackwell 系列硬件及多机架液冷系统,并首次落地了Autonomous Recovery Engine的雏形。然而在 2.5 之前,这项Recovery机制完全受限于 Slurm 的批处理调度环境,无法直接作用于现代企业主流的容器化负载。
在全面整合了 Run:ai 调度技术后,Mission Control 2.5 将这套自愈状态机完整植入到了 Kubernetes 环境中。其核心逻辑在于:将作业层面的状态恢复与硬件层面的故障排查解耦为两条并行控制链路,针对不同故障类型采取差异化动作。
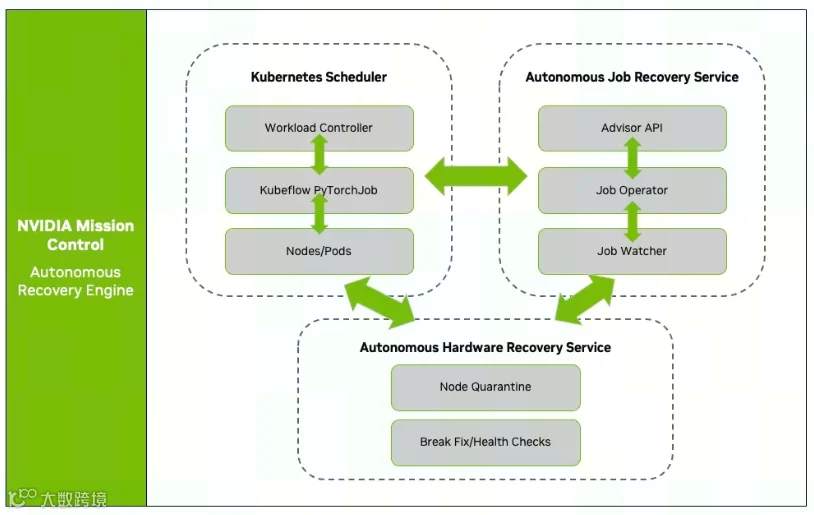
1. 软件故障处理流程
在大规模分布式训练中,相当一部分任务中断并非由物理硬件损坏引起,而是源于临时性的软件瞬态异常,例如:训练 Worker 进程偶发退出、跨节点通信瞬时超时、临时 OOM 或集合通信协同瞬时失步。
针对此类异常,Mission Control 2.5 的处理原则是克制与避免过度反应,处理原则有:
-
Autonomous Job Recovery(AJR)捕获容器退出状态码和历史失败记录。如果判定该异常属于非硬件原因的瞬态错误,系统判定底层节点物理状态依然健康。 -
AJR 与 Run:ai及 Kubeflow PyTorch Operator 协同,依据预设的重试策略,在原节点就地重新拉起容器或重新排队。 -
在此过程中,Autonomous Hardware Recovery (AHR) 不介入隔离动作。这样可以避免集群可用算力池被非必要缩减,防止产生大量无效的硬件告警噪音。 -
如果同一节点在软件重试后连续出现异常并突破预设阈值,系统才会将其标记为潜在退化节点,升级进入排查流程。

2. Hardware Faults
当节点出现明确的硬件异常(例如不可纠正的 ECC 内存错误、GPU 挂起 Hung、PCIe 掉卡或通信链路硬件故障)时,系统启动双轨并行处理机制。
在作业恢复轨,作业自愈不需要等待底层的硬件根因分析完成。AJR 捕获故障上下文并锁定受影响的 GPU/节点后,立即通知 Run:ai 调度器执行作业置换。调度器在可用资源池中计算物理通信拓扑,挑选通信距离最近的健康节点补齐算力,挂载最新的Checkpoint恢复分布式训练,将业务中断时间压缩至最短。
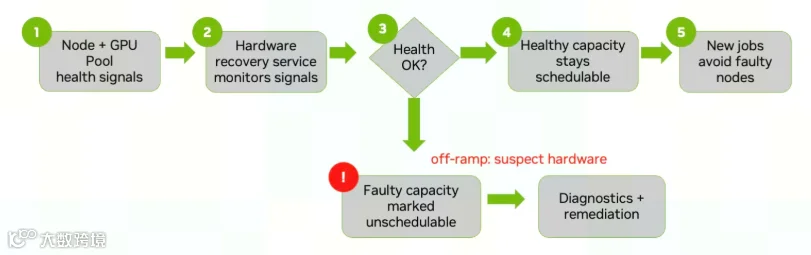
在作业开始恢复的同时,AHR 自动将异常节点标记为不可调度状态(添加 Kubernetes 污点并执行 Drain),记录异常指标与故障上下文。异常节点被移出调度池后,后台自动触发固件级回环测试与硬件检测流程,防止故障节点被后续其他训练任务再次申请使用。

3. 硬件早期退化预防
除上述中断后自愈外,Mission Control 2.5 具备故障前主动预防能力。当监控探针在运行中捕捉到某张 GPU 或节点频繁出现轻微状态警告、网络传输误码率抬升等隐性退化指标时,即使当前未造成正在运行的任务崩溃,AHR 也会在任务间隙提前将该节点移出可调度资源池并安排诊断,从而规避高风险节点演变为后续大模型训练中断的诱因。
三、 Minerva 与 Mission Control 的协作
结合近期发布的《NVIDIA Mission Control 2.5.0 Release Notes》,两者的产品边界与协作关系已经明确:Minerva 1.0.0 目前正作为预发布 Beta 组件,被纳入 Mission Control 2.5 的技术架构中。
其中Minerva负责跨层采集底层硬件、网络交换机、通信库与作业指标。其主要任务是在硬件尚未彻底停机的状态下,利用拓扑关联算法与无监督基线模型,判定隐性性能下降的根因。
Mission Control则作为基础设施管理底座与作业控制面,负责节点的生命周期管理(Provisioning、Firmware、OS)、K8s 污点控制以及作业自愈调度。
当集群出现微弱丢包导致的隐性性能退化时,硬件问题尚未触发阈值时,Minerva 依靠动态拓扑图谱锁定根因端口与节点。然后将分析结果封装为事件请求,通过 API/MCP 接口传递至 Mission Control。Mission Control 接收高置信度事件后,启动 AHR/AJR 控制链路,完成节点隔离和作业在健康拓扑上的重新恢复。
四、 商业模式
根据官方产品说明与企业渠道分销商(如 Lenovo、Dell、Scan、SHI)披露的配置清单,Mission Control 2.5 具备明确的商用授权属性:
授权模式采用企业级软件常见的按 GPU 数量按年订阅许可机制,通常作为 NVIDIA Base Command Manager(BCM)及 AI Enterprise 生态系统的一部分销售。
总结
NVIDIA Mission Control 2.5 与 Minerva 的组合,构成了从指标遥测、图谱关联、根因分析到节点隔离、拓扑重构、断点续训的技术链条。对于算力基础设施建设者而言,该方案提供了大集群 AIOps 的系统性解法,但也意味着企业需要在纯自研路线与深度采购商业软硬件生态之间,权衡系统控制力与资金成本。