

不要百万亿次,不要千万亿次
仅需 10 TFLOPS!
智传网 AI Flow 推出
生成式智能传输轻量版
GenTrans-Lite
解码算力需求直降数百倍
传输画质依旧不打折
让实时生成重建
更轻量
更高效
作为 AI 时代的新一代通信网,智传网(AI Flow)开拓了视频传输从“比特流”向“词元流”模式跃迁,通过增加计算降低带宽需求,根据词元流所提供的语义、特征、条件等信息进行还原重建。
但跑通算法链路只是第一步,当面对实际落地业务中的实时视频流解码与规模部署需求时,还需要解决两个核心问题:
解码速度是否足够快,能否跟上视频连续输入和实时播放的节奏。
总部署成本是否足够低,能否在有限硬件资源下承载更多业务。
为了进一步提升智传网(AI Flow)的重建效率,中国电信集团 CTO、首席科学家、中国电信人工智能研究院(TeleAI)院长李学龙教授带领科研团队研发并推出生成式智能传输轻量版 GenTrans-Lite ,将解码算力需求从数百乃至上千 TFLOPS 压降至 10 TFLOPS,在有限硬件资源条件下可承载更多业务需求。


在实时的生成式智能传输场景中,画面需要以连续帧的形式不断输出。只要解码速度跟不上词元流的输入速度,待处理数据就会持续积压,播放延迟随之增加,最终影响画面的连贯性和交互体验。
根据信容(Information Capacity, IC)理论的指导,信息量与模型参数量的比值代表了模型内存储的知识密度;比值越大,模型在单位数据量能承载的信息就越多。
TeleAI 团队受此启发,如果通过提升接收端模型的信容,使其能够尽可能多地掌握关于画面结构、纹理、运动规律的先验信息,那么发送端只需传输少量词元,就能补充接收端无法自行推断的部分。
这样一来,解码器处理的就不再是“从零恢复每一帧画面”,而是“补充和修正新增内容”,需要执行的有效计算也会随之减少。

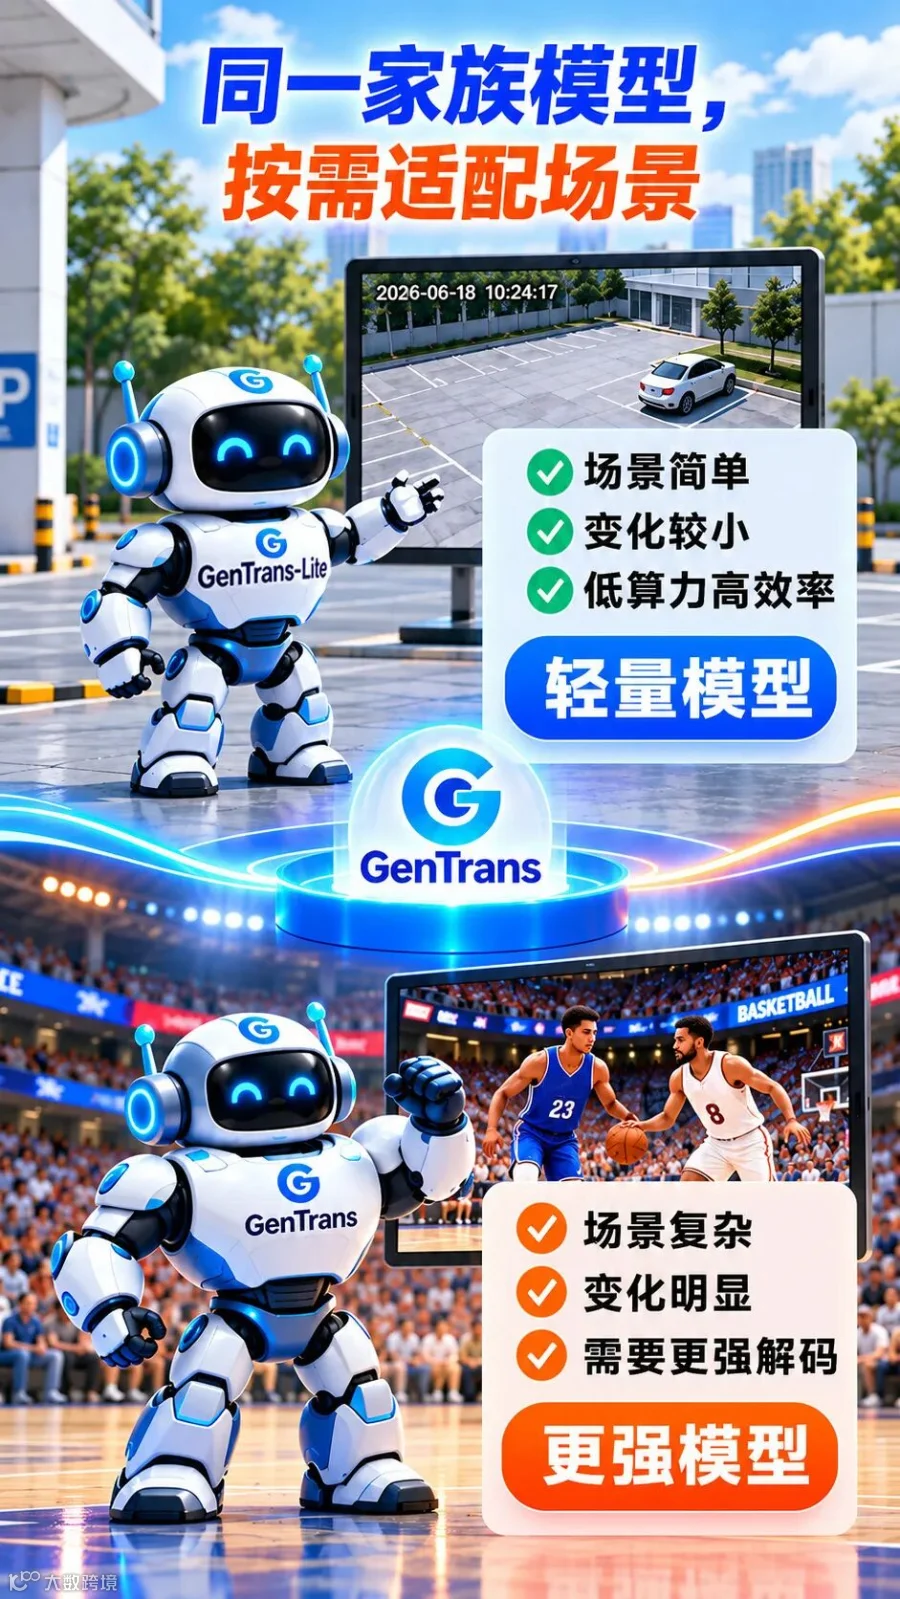
与此同时,智传网(AI Flow)的家族式同源模型还能进一步提升计算效率。同一模型家族中的不同模型,可以共享通用的结构和能力,再根据视频分辨率、画面复杂度和实时性要求,选择合适的模型规模和处理路径。
内容变化较小、结构较稳定的画面,可以优先使用轻量模型完成解码;遇到细节复杂或变化明显的场景,再调用更强的模型能力。这样既避免了所有任务都使用同一套大模型,也减少了重复计算、数据搬运和任务等待。
围绕解码阶段的计算负担、数据搬运和任务调度,TeleAI 对关键路径进行了系统性优化,将解码侧的算力需求降至 10 TFLOPS。同时,在消费级显卡上,针对 1080P 高清视频解码速度也可以达到 120 帧/秒。
更低的算力占用,为实时出流、更高分辨率输入和多任务并行留下了更多处理空间,让内容能够更快完成还原和呈现。
降低解码算力并不是简单减少模型工作量,也不是以画质换取速度,而是让模型少重复计算已经掌握的内容,把有限算力集中用于真正需要补充和修正的信息。
GenTrans-Lite 正是从解码链路中的计算、数据访问和任务调度等环节入手,将生成式智能传输的模型能力转化为更高的实时解码效率。

算力需求的降低,带来的不仅是单次任务速度的提升,也意味着更低的部署门槛和更高的硬件利用率。
在此,TeleAI 引入正激励噪声(Positive-incentive Noise,Pi/π-Noise),通过设计和控制随机噪声,使其成为推动画面重建的重要条件,从而帮助模型调用已经学习到的先验信息。
如果发送端和接收端共享随机种子、噪声调度方式或其他生成条件,接收端就不必把所有细节逐一传输,也不必在大量可能的结果中反复搜索。模型可以根据已有的噪声状态和少量语义、特征信息,直接生成符合约束的画面内容。

这会带来两方面的变化:一方面,传输和解码端需要处理的信息更少;另一方面,模型的生成方向受到约束,不需要对完整画面进行重复计算。正激励噪声帮助接收端把算力用在“生成和修正真正变化的内容”上,而不是用在还原那些已经可以由模型推断出的细节上。
需要说明的是,噪声本身不会直接降低算力,也不会凭空创造视频信息。它发挥作用的前提,是接收端已经具备相应的模型先验,并且能够利用共享噪声、历史状态和传输过来的条件信息完成重建。
真正的算力下降,来自这些资源被有效组织之后,模型不再需要从零处理每一帧画面,也不必对所有可能结果进行完整计算。
在相同硬件资源下,更轻量的解码链路更充分利用算力资源,原本只能支持单路视频解码任务的算力条件,现在可以支持数十条并发任务,算力的整体承载能力大幅提升。
对于需要持续运行的实时视频、云端生成和边缘侧推理业务,GenTrans-Lite 可以实现更灵活的部署方式、更可控的运营成本,以及更稳定的服务能力。

为了将局部优化转化为完整链路的性能收益,TeleAI 科研团队从数值表达、模型计算、算子执行和数据访问等多个层面开展优化:
从“信容”所关注的能力、收益与成本关系,到“正激励噪声”带来的资源利用启发,生成式智能传输的优化方向逐渐清晰:充分利用接收端已有的知识与生成能力,同时降低调用这些能力所需的计算投入。
这些优化共同推动解码链路从“能够运行”走向“高效运行”,也让 10 TFLOPS 级别的算力资源,真正转化为实时体验和部署价值。
