


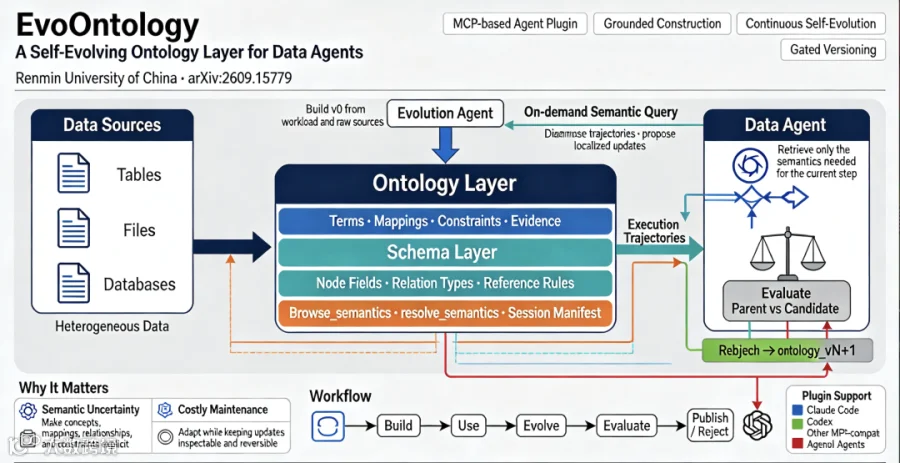
编者摘要:EvoOntology 由中国人民大学数据实验室提出,是面向数据智能体(Data Agent)的首个自演化本体层,旨在弥合智能体与异构数据之间的语义鸿沟。原始数据表、文件、数据库中业务指标、实体关系等语义信息隐式存在,传统方案要么依靠 ReAct 让智能体反复猜解,要么使用人工维护的静态本体,存在语义错误、重复探查、维护成本高、上下文膨胀等痛点。
EvoOntology 创新性地将本体视为智能体可版本化的运行状态,而非模型权重。系统分为 Content、Schema、Tool 三层互联本体结构,依托 MCP 协议实现按需语义检索,避免全量本体注入 Prompt。其完整生命周期包含构建、使用、演化、评估、发布五大环节:从数据与任务负载自动构建初始本体;采集 Agent 执行轨迹诊断问题,生成本地化补丁;新增闸门式版本校验机制,候选版本必须与父版本对照评估,验证收益才可上线。
在 BIRD、DDR-Bench、InsightBench 三大基准测试上,基于 GPT、Claude 多基座验证,EvoOntology 相比原生 ReAct 取得显著性能提升。该框架支持 Claude Code、Codex 插件化快速接入,为企业异构数据库、文本 + 数据表混合分析场景,提供一套可审计、可回滚、持续迭代的语义增强方案。

10 个关键问题 Q&A
- Q:EvoOntology 是什么?
A:面向数据智能体的首个自演化本体层,通过 MCP 向外暴露带版本的语义层,基于 Agent 执行轨迹持续迭代本体,弥合 Agent 与异构数据间的语义鸿沟。 - Q:它和传统本体最大区别?
A:传统本体人工编写、静态维护;EvoOntology 自动构建,依据真实任务轨迹局部更新,上线前强制对照评估,支持版本回滚。 - Q:三层本体层分别承担什么作用?
A:Content 层存储语义知识图谱;Schema 层定义本体元模型与表达边界;Tool 层提供 MCP 工具,支持按需检索语义,不一次性灌入全部知识。 - Q:什么是闸门式版本控制(Gated versioning)?
A:本体更新生成候选版本后,必须和父版本在相同环境下对照评测;只有取得可复现正向收益,才允许发布新版本,保证本体变更可控。 - Q:Active Access 按需检索的好处?
A:Agent 只拉取当前步骤所需语义片段,避免一次性注入完整本体,大幅降低上下文消耗,缓解长窗口压力。 - Q:EvoOntology 是基于 RAG 吗?
A:不是 RAG。RAG 检索文档片段;EvoOntology 维护结构化本体语义图,包含术语、映射、约束、证据,聚焦数据语义与实体关系而非原始文本。 - Q:支持哪些 Agent?
A:原生提供 Claude Code、Codex 插件,所有兼容 MCP 协议的 AI 智能体都可以接入。 - Q:三大 Benchmark 结果有什么规律?
A:DDR-Bench(异构金融长任务)提升最大;BIRD 文本转 SQL 稳定提升;InsightBench 一次性业务洞察任务增益很小,依赖重复交互轨迹才能演化。 - Q:本体是大模型权重更新吗?
A:不是。论文核心观点:本体是Agent 的可训练运行状态,不是模型权重;演化修改本体知识库,不微调 LLM。 - Q:有什么落地局限?
A:需要足够多重复任务交互轨迹才能体现演化价值;每一轮版本评估带来额外算力开销;目前仅在 3 套基准验证,企业生产仍需工程适配。
对比表:EvoOntology vs RAG vs 传统本体 vs 普通 ReAct 数据 Agent
|
|
|
|
|
|
|---|---|---|---|---|
| 语义载体 |
|
|
|
|
| 语义构建方式 |
|
|
|
|
| 更新机制 |
|
|
|
|
| 知识访问方式 |
|
|
|
|
| 可审计、可回滚 |
|
|
|
|
| 适合任务 |
|
|
|
|
| 核心短板 |
|
|
|
|
| LLM 微调 |
|
|
|
|
一句话定位:EvoOntology 是面向数据智能体(Data Agent)的首个自演化本体层,核心目标弥合「智能体 — 数据鸿沟」,通过 MCP 协议向外暴露带版本管理的本体语义层,基于任务执行轨迹持续自动更新本体,解决异构表 / 文件 / 数据库场景下智能体的语义理解问题,由中国人民大学数据实验室(RUC DataLab)发布,支持 Claude Code、Codex 插件化接入。
一、背景痛点(它要解决什么问题)
- 语义不确定性
原始数据只存在表名、列名、文件路径;指标定义、实体关系、业务约束都是隐式信息,每次提问智能体都要反复猜测,极易语义错误。 - 重复数据探查
同类业务任务每次都要重新探索数据环境,无法复用已经验证过的领域知识。 - 静态本体维护成本极高
人工构建的语义层需要专家持续维护,数据 / 业务 workload 一变就过时;全量注入上下文还会造成上下文窗口膨胀。
现有方案二选一:要么让 Agent 裸读原始数据,要么一次性把人工静态本体塞进 Prompt;两者都难以规模化,也无法跟随智能体的实际使用行为自适应。
二、设计思想
本体不是模型权重,而是可训练、可版本化的智能体运行状态。
-
Builder 初始化:从业务任务与底层数据自动生成、校验语义对象,产出 ontology_v0 -
Evolution Agent:读取历史交互轨迹,提出局部补丁更新;每一个候选版本(Candidate)都必须和父版本(Parent)做成对对照评估,只有复现可验证收益才允许发布,否则回滚保留旧版本 -
访问模式:按需检索(Active Access),不是一次性全量灌入上下文。Agent 通过 MCP 工具只查询当前步骤需要的语义片段
三层互联本体层(Ontology Layer)
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
browse_semantics
resolve_semantics+ 会话清单 manifest;会话初始化用精简清单,详情按需拉取
|
三、生命周期 Build → Use → Evolve → Evaluate → Publish/Reject
- Build 构建
从 workload 提取候选概念,在原始数据源上校验,生成初始本体 v0 - Use 使用
Data Agent 通过 MCP 查询本体;所有工具调用、执行结果记录为交互轨迹 - Evolve 演化
诊断重复失败 / 高频行为,定位问题归属到内容层 / 模式层 / 工具层,生成本地化补丁候选版本 - Evaluate 评估
严格控制变量:同一数据集、同一 Agent、相同解码参数、交互预算,对比 Parent / Candidate - Publish / Reject
评估正向提升则发布新版本 ontology_vN+1;不达标则舍弃候选,把评估结果用于下一轮迭代
四、亮点
✅ MCP 通用 Agent 插件:Claude Code、Codex 一键接入,不需要克隆仓库、虚拟环境、pip 安装,GitHub Marketplace 直接添加插件 ✅ 按需检索语义:规避长上下文爆炸,只拉取当前任务需要的语义片段 ✅ 基于证据构建(Grounded):语义对象必须经过底层数据校验才写入本体,不是 LLM 凭空生成 ✅ 局部定向演化:不整体重写本体,只针对出问题的模块做局部更新 ✅ 闸门式版本控制(Gated versioning):没有通过对照评估,绝不上线新版本,保证本体可回滚、可审计 ✅ 多基准、多基座验证:BIRD、DDR-Bench、InsightBench;GPT-5.5/5.6-sol、Claude-Sonnet-5、Claude-Opus-4.8
五、实验性能结果(四基座子集)
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
DDR(金融异构开放研究场景)收益最显著;BIRD 文本转 SQL 有稳定提升;Insight 业务洞察类任务增益偏小,说明自演化本体对长链路、复杂多表数据探查任务价值更大。
六、快速使用工作流
Claude Code
claude plugin marketplace add ruc-datalab/EvoOntology
claude plugin install evoontology@evoontology
claude plugin list
会话内指令
/evoontology:build-ontology
/evoontology:evolve-ontology
/evoontology:explore-ontology
Codex
codex plugin marketplace add ruc-datalab/EvoOntology
codex plugin add evoontology-codex@evoontology
codex plugin list
会话内调用:$build-ontology/ $evolve-ontology/ $explore-ontology
插件底层统一本体生命周期,仅调用语法随 Agent 平台不同而变化。构建完成后 Agent 可直接调用
browse_semantics、resolve_semantics,无需额外本体配置。
七、仓库目录结构
evoontology核心引擎,本体存储、MCP 运行时、轨迹记录、评估、演化状态机、可视化 pluginsClaude Code、Codex 独立插件 benchmarksBIRD、DDR-10K、InsightBench 评测环境,带 EvolutionAdapter docs架构文档、新增 benchmark 接入指南 scripts核心模块与插件同步工具 assets架构图、Logo、演示素材
八、创新点总结
-
将本体定义为可版本化、可演化的 Agent 运行态,而非静态知识库或模型权重 -
基于 MCP 协议实现本体的按需查询,替代全量 Prompt 注入,解决上下文膨胀 -
成对对照的闸门式演化机制:任何本体变更必须经过严格对照评估,保障本体质量可控、可回滚 -
三层解耦本体架构(Content / Schema / Tool),把领域概念、元模型、运行时接口分离 -
插件化,原生对接主流代码 / 数据 Agent,开箱即用,不需要重度部署
九、适用场景 & 边界
✅ 适合:企业异构数据库、多表业务分析、财报 / 金融文档 + 数据表混合分析、Text-to-SQL、业务洞察生成 ⚠️ 局限:
-
收益高度依赖任务是否存在重复交互轨迹;一次性孤立任务自演化增益很小(对应 InsightBench 提升微弱) -
演化带来额外评估开销,每次候选版本都要跑成对实验,成本高于静态本体 -
当前仅在 BIRD/DDR/InsightBench 三个评测环境验证,大规模企业生产落地仍需工程适配
十、Citation
@misc{chong2026evoontologyselfevolvingontologylayer,
      title={EvoOntology: A Self-Evolving Ontology Layer for Data Agents},
      author={Meiduo Chong and Shaolei Zhang and Ju Fan and Xiaoyong Du},
      year={2026},
      eprint={2609.15779},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.15779},
}