

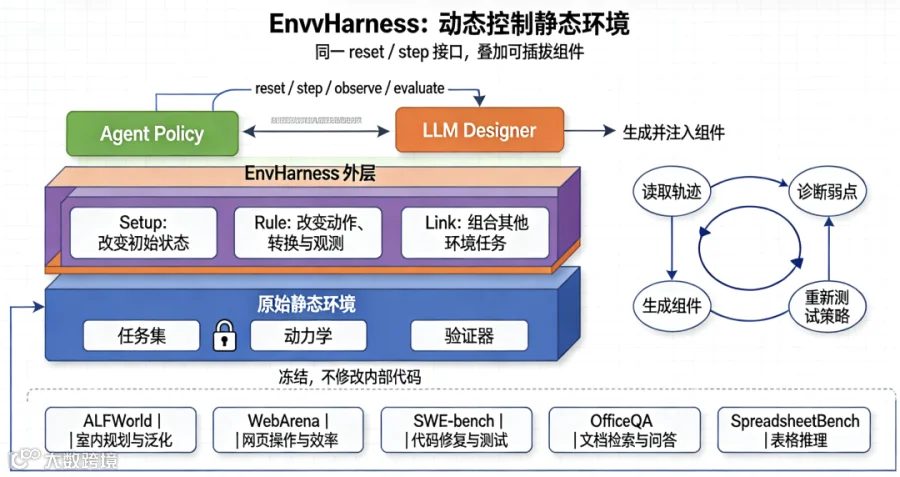
编者摘要:EnvHarness 由 Google 于 2026 年发布,核心思路是将 Agent Harness 思想迁移至环境侧,在不改动原有静态环境内部代码与评估器的前提下,通过外层可插拔组件,把固定基准改造为自适应教学环境。框架包含 Setup、Rule、Link 三大组件,仅拦截 reset/step 接口,可自由堆叠;由 LLM 设计师智能体形成闭环:读取智能体轨迹诊断短板、自动生成 Python 插件重塑环境,迭代实现环境与智能体协同进化。 该框架已在 ALFWorld、WebArena、SWE-bench Verified、OfficeQA、SpreadsheetBench 五大交互式 Agent 基准完成验证。实验表明,在 EnvHarness 动态环境习得的技能迁移至原始基准后性能更强,分布外任务最高提升 9 个点,交互步数降低约 9.8%,同时支持 GRPO 强化学习训练。EnvHarness 具备基准无关特性,新环境只需实现 ActionableEnv 接口即可接入,可用于 Agent 技能蒸馏、弱点诊断、鲁棒评测、自动构造训练样本;局限是依赖 LLM Designer,无法修改底层环境动力学,仅适用于交互式仿真环境。
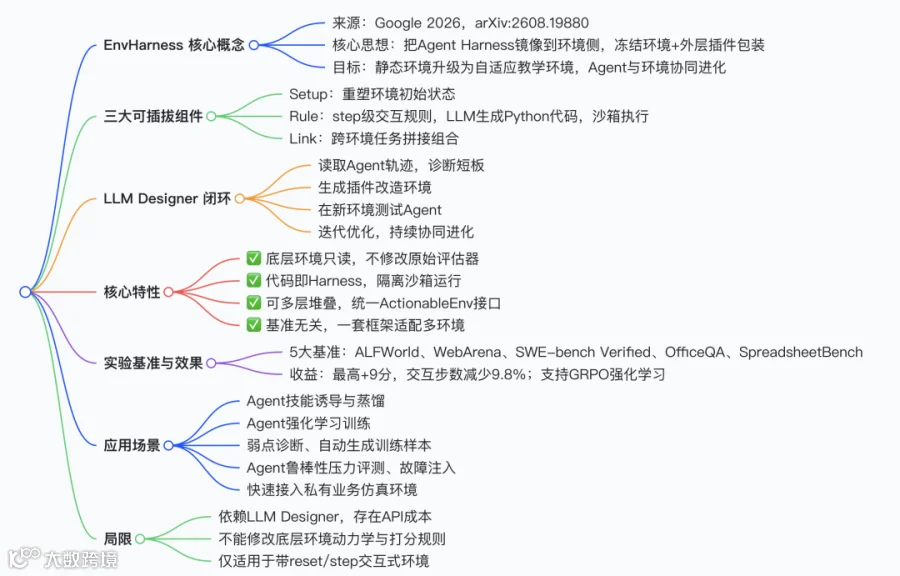
10 问 10 答
- EnvHarness 是什么?
EnvHarness 是 Google 提出的环境侧外挂框架,不修改原始静态环境底层代码,通过可插拔插件层动态改造交互过程,实现环境随智能体能力协同进化,用于 Agent 训练与评测。 - EnvHarness 解决了什么痛点?
传统 Agent 基准环境固定不变,无法针对 Agent 短板生成训练场景;Agent 学会任务后环境不再提供有效学习信号;定制动态环境开发成本极高。 - EnvHarness 三大核心组件是什么?
Setup(初始状态重塑)、Rule(交互规则钩子,LLM 生成 Python)、Link(跨环境任务组合),均拦截 reset/step 标准接口。 - LLM Designer Agent 的闭环流程?
读取交互轨迹诊断 Agent 弱点→自动编写 Harness 插件改造环境→测试 Agent→迭代优化,循环实现 Agent 与环境协同进化。 - EnvHarness 为什么保证评估可信?
底层环境、任务、人工验证打分器完全保留,仅劫持 Agent 与环境之间的交互层,评估逻辑没有改动。 - ActionableEnv 接口作用?
统一环境抽象,新增基准只需实现 7 个接口(reset/step/observe/evaluate/get_env_state/save_state/from_state),整套训练评估流水线可直接复用。 - EnvHarness 实验效果如何?
在 ALFWorld、WebArena、SWE-bench 等 5 个基准上,学到的技能迁移回原始环境效果更优,OOD 任务最高提升 9 个点,交互步数减少 9.8%,支持 GRPO 强化学习。 - EnvHarness 主要应用场景?
Agent 技能蒸馏、强化学习训练、弱点诊断、自动构造训练集、鲁棒性压力测试、快速接入私有业务仿真环境。 - Code as Harness 是什么含义?
Designer Agent 直接生成 Python 子类代码,而非固定参数选择;代码在独立子进程沙盒运行,错误只会记录轨迹,不会崩溃实验。 - EnvHarness 有哪些局限性?
依赖外部 LLM 作为设计师,带来 API 开销;无法修改底层环境动力学和原始打分规则;仅适用于具备 reset/step 机制的交互式环境。
标题:EnvHarness: Awakening Static Worlds for Agent Learning :EnvHarness 不对原有静态环境做任何内部修改,而是在环境外面叠加可编排插件层,由 LLM 设计师智能体自动诊断智能体短板、动态改造环境,实现 “环境跟着智能体能力协同进化”,解决传统 Agent 基准环境固定不变、无法针对性训练的痛点。
一、背景痛点
现在 LLM 智能体越来越依赖交互式环境(网页、代码、仿真、办公),但现有基准环境(ALFWorld、WebArena、SWE-bench 等)都是静态环境:
-
环境逻辑、任务、评估规则写死,不管智能体变强还是存在特定缺陷,任务永远不变; -
一旦智能体学会这批任务,环境就不再提供新教学信号,无法继续提升; -
改造环境成本极高,需要侵入底层代码、重写仿真逻辑。
Agent Harness 是给冻结大模型外挂工具 / 记忆 / 技能,不改动模型权重;EnvHarness 把这个思路镜像迁移到环境侧:给冻结环境外挂插件层,不改动环境内部代码,动态控制交互过程。
二、核心架构:三大可插拔组件
所有组件仅拦截标准reset/step接口,底层环境、任务、人工验证器完全不动,保证评估可信,三层可以自由堆叠组合:
- Setup(初始状态重塑)
修改环境 reset 后的初始状态,固定回放动作序列,用来构造不同起始场景。 - Rule(交互规则重塑)
step 级钩子,控制允许动作、动作效果、智能体观测内容;由 LLM 生成 Python Rules子类代码,在隔离子进程执行,坏代码不会直接崩溃实验,只会记录 trace。 - Link(环境任务组合)
把另一个环境的任务嵌入当前 episode,跨域任务拼接。
闭环:LLM Designer Agent 诊断循环
-
读取智能体交互轨迹,定位智能体具体薄弱点; -
自动编写 EnvHarness 插件,改造环境,生成针对性训练场景; -
在改造后的环境上测试智能体; -
迭代修改插件,直到环境能够训练补齐该短板; -
循环执行,智能体能力提升 → 环境自动升级任务难度,两者协同进化。
三、核心特性
- 冻结环境,零侵入修改
基准任务、动力学、打分逻辑完全保留,只修改智能体与环境之间的中间层,评估可信度不变。 - Code as Harness
不是从固定选项里挑选参数,而是直接生成 Python 类;沙盒执行,保证安全。 - 可组合
EnvHarness 本身就是 ActionableEnv,可以多层嵌套堆叠,统一接口。 - 基准无关(Benchmark-agnostic)
新增环境只需要实现一套 ActionableEnv接口,整套设计师智能体、组件、训练评估流水线无需改动。 -
ActionableEnv 7 个接口: reset / step / observe / evaluate / get_env_state / save_state / from_state
四、实验结果(5 大基准:ALFWorld / WebArena / SWE-bench Verified / OfficeQA / SpreadsheetBench)
在 EnvHarness 动态环境学到的技能,迁移回原始未改动基准上效果优于两组基线:无技能基线、在原始静态环境学到的技能。
-
ALFWorld OOD(分布外任务)最高提升+9 分;整体平均提升 + 5.9; -
WebArena 平均 + 3.1; -
SWE-bench Verified 成功率 + 2.7,交互步骤减少(更高效); -
OfficeQA、SpreadsheetBench 都有稳定增益; -
交互效率提升:减少约 9.8% 交互步数; -
同时支持 GRPO 强化学习训练,多次迭代设计师循环,收益会持续累积。
实验全部基于 Gemini 系列模型;代码仓库默认配置为 GPT-4.1-mini,复现论文指标需要切换模型。
五、工程体系(开源项目)
1. LLM 后端支持
OpenAI GPT、Vertex Claude、Gemini;可以统一MODEL环境变量全局指定模型,统一控制 policy、mutator、embedding,避免多模型混杂。
-
Embedding 自动绑定对应服务商向量模型,也可通过 EH_EMBED_MODEL手动覆盖。
2. 运行流程
-
前置校验: check_env.py环境预检; -
Smoke 小任务快速验证: reproduce_smoke.sh; -
完整实验: reproduce.py,用于技能提取与评估; -
RL 训练路径:基于 verl-agent 在 EnvHarness 环境做 GRPO。
3. 接入新 Benchmark 五步流程
-
实现 Bridge:继承 ActionableEnv,实现 7 个接口,注册环境; -
编写 env_state_schema,把状态描述注入设计师 Agent 提示词; -
编写 corpus.yaml 配置文件,指向新环境; -
复用已有技能抽取、评估代码; -
添加预检脚本与单元测试。
4. 自定义 Harness Layer 开发
可以新增自定义层(如 step 预算限制、奖励塑形),继承EnvHarness并注册,层栈支持序列化保存 / 加载;
-
示例仓库自带 Budget 层:限制单 episode 最大动作步数。
六、关键价值与落地启示
- 解决 Agent 训练的数据难题
不用人工大规模编写训练任务,由 LLM 自动根据智能体失败案例生成适配难度的动态训练环境; - 基准复用
不用为训练单独造仿真环境,直接复用已有的高质量公开基准,只加外层包装,评估可信; - 持续自进化训练闭环
随着智能体变强,环境自动提升难度,形成持续教学,打破静态环境能力天花板; - 工程上统一 Agent 环境抽象
ActionableEnv作为通用接口,把网页、代码、办公、室内仿真环境统一封装,一套训练框架跑全部环境。
七、局限
-
依赖外部 LLM 作为 Designer Agent,有 API 成本与速率限制; -
环境改造能力上限取决于 Designer 写 Rule 代码的能力; -
底层环境本身的缺陷无法修复,EnvHarness 仅做外层交互劫持。