


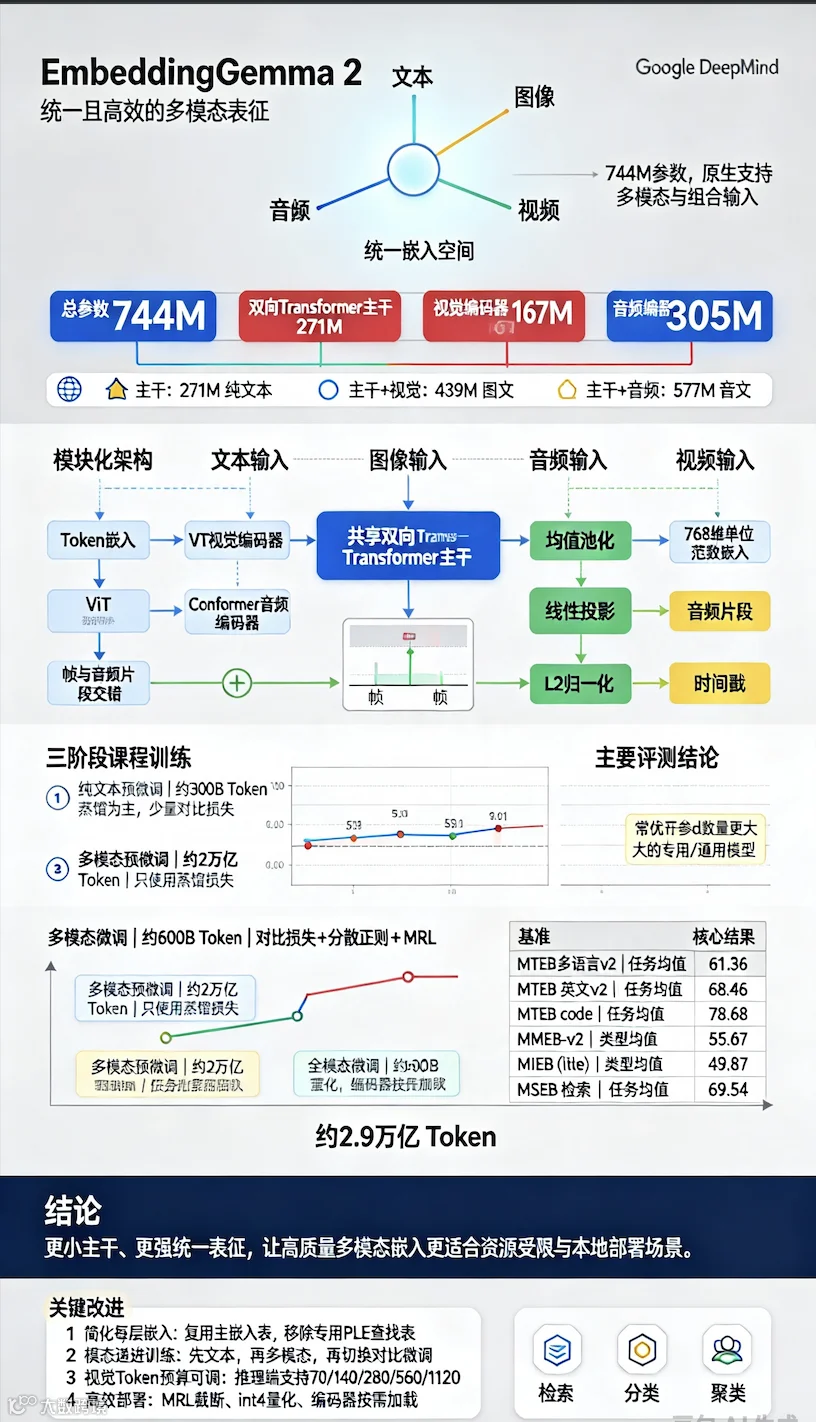
EmbeddingGemma 2 是 Google DeepMind 开源744M 参数轻量统一多模态嵌入模型,原生支持文本、图像、音频、视频及其交错混合输入,全部映射至同一个语义对齐向量空间。采用模块化编码器设计:可按需加载模块,纯文本仅 271M,图文 439M,音文 577M,完整多模态 744M。
核心创新:简化每层嵌入 PLE,移除独立查找表;三阶段课程训练(文本预微调→多模态预微调蒸馏→多模态对比微调);融合套娃表征 MRL,支持 768/512/256/128 维截断输出;支持 int4 量化,适配端侧设备。
损失组合包含对比损失、分散正则、蒸馏损失;消融证实视觉编码器联合训练、原生音频输入优于 ASR 转写方案。在 MTEB、MMEB‑v2、MAEB 等多套基准构建新帕累托前沿,小参数下性能匹敌数倍更大的专用模型。适合检索、聚类、RAG,支持本地部署,开源开放供研究使用。

10 个关键问题 Q&A
- Q:EmbeddingGemma 2 是什么?
A:谷歌开源轻量多模态嵌入模型,744M 参数,把文本、图、音、视频映射进同一个向量空间,用于检索、聚类等任务。 - Q:它和 CLIP/SigLIP 最大区别?
A:CLIP 仅图文,无法处理视频、音频,不支持交错混合模态输入;EG2 原生支持音视频 + 混合多模态输入。 - Q:模块化参数是什么含义?
A:编码器可选择性加载;只用文本仅需 271M,不需要加载音 / 视觉编码器,大幅降低资源消耗。 - Q:PLE 每层嵌入做了什么优化?
A:删掉独立 PLE 查找表,直接复用主输入嵌入;减少参数量,同时提升多模态任务指标。 - Q:三阶段训练分别起什么作用?
A:①文本预微调夯实文本能力;②多模态预微调靠蒸馏继承教师多模态知识;③微调切换对比损失,学习适配自身的嵌入空间。 - Q:为什么音频不用 ASR 转写,做原生音频编码?
A:ASR 会丢失音色、口音、环境声;原生音频保留声学信息,跨语言语音检索效果显著更高。 - Q:MRL 套娃表征学习作用?
A:训练同时支持 768/512/256/128 多种输出维度,小维度也保留很高精度,适配内存紧张场景。 - Q:视觉 token 预算有什么讲究?
A:文档类任务 token 越高越好;视频 token 不宜过大,序列太长会稀释表征;推理可动态调整 token 数量。 - Q:模型量化效果如何?
A:支持 int4 Q4_0/Q4_C 量化;Pixel11 Pro 完整多模态仅 567MB 内存,性能衰减很小,支持手机端本地运行。 - Q:适用与不适合什么场景?
A:✅适合多模态检索、代码搜索、音视频检索、端侧向量库;❌不适合生成对话,它是嵌入模型,不是大语言生成模型。
附录 EmbeddingGemma 2:统一且高效的多模态表征
谷歌深度思维(Google DeepMind) Henrique Schechter Vera、Sahil Dua、Jovan Andonov、Sara Smoot、Sebastian Russo、Ivan Llanos、Max Matveev、Jae Hyeon Yoo、Kat Black、Shih‑Cheng Huang、Josiah Aklilu、Maarten Grootendorst、Omar Sanseviero、Chandramouli Amarnath、Ian Ballantyne、Zhe Li、Daniel Salz、Ibrahim Alabdulmohsin、Ilya Philippov、Kristen Quan、Glenn Cameron、Edouard Yvinec、Luciano Martins、Doug Reid、Sindhu Raghuram Panyam、Weiyi Wang、Hengxuan Ying、Madhuri Shanbhogue、Tanmaya Dabral、Shanfeng Zhang、Juyeong Ji、Renjie Wu、Joe Zou、Xu Chen、Yunan Zhang、Yu‑Hui Chen、Matthew Soulanille、Vinod Mamillapalli、Yi‑Chun Kuo、Wai Hon Law、Matt Kreileder、Alice Zheng、Suril Shah、Mogan Shieh、Pooja Consul、Alberto Montes、Andreas Hess、Andres Sevilla、Babak Samari、Brendan McCloskey、Brian Potetz、Daniel Cer、Georgios Kathareios、Gustavo Hernández Ábrego、Hesen Zhang、Ji Ma、Jiaxing Wu、Keegan Mosley、Paul Suganthan、Rui Meng、Shen Gao、Shengcao Cao、Yi‑Ting Chen、Yichang Chen、Zhongli Ding、Kendra Byrne、Cormac Brick、Olivier Lacombe、Qin Yin、Tris Warkentin、Armand Joulin、Tom Duerig、Mojtaba Seyedhosseini,EmbeddingGemma 团队,谷歌 ¹
¹ 详见贡献与致谢部分。* 共同一作;贡献等同。 通讯作者:hschechter@google.com ©2026 谷歌深度思维,保留所有权利 arXiv:2610.37364v1 [cs.LG] 2026‑10‑27
摘要
本文提出 EmbeddingGemma 2,一款开源多模态嵌入模型,可在统一表征空间原生表示文本、图像、音频、视频,以及上述模态的组合输入。本工作引入多项改进:简化每层嵌入机制、采用模态与目标函数递进的多阶段课程训练策略,保证模型在单模态、跨模态、混合模态评测任务上均取得优异效果。值得注意的是,在覆盖全部模态的全套嵌入基准测试中,EmbeddingGemma 2 开辟新的帕累托最优前沿,性能超越专用模型以及参数量为自身 2‑12 倍的通用模型。此外该架构适配资源受限场景:支持选择性加载模态编码器、可调节视觉 token 预算、嵌入维度可截断、支持权重量化。本文通过消融实验分析关键设计决策,并开源 EmbeddingGemma 2,助力后续相关研究。
1 引言
嵌入模型将数据映射为固定长度向量,让语义相近的数据在嵌入空间中位置靠近。文本嵌入模型广泛用于信息检索、语义相似度计算、聚类、检索增强生成等任务。但要处理音视频等视觉、音频数据,文本嵌入模型必须依赖自动语音识别(ASR)、图像描述生成等外部工具;这不仅增加计算开销,还会丢失细粒度视觉细节、非语言环境音这类关键信号。
CLIP、ALIGN、SigLIP 等多模态嵌入模型新增视觉分支,取得不错的跨模态效果,但无法原生处理混合模态输入,不能捕捉不同模态之间的交互关系。近期不少工作将多模态大语言模型改造为嵌入模型,支持交错混合模态输入,可完成视觉问答、视觉定位等复杂任务;后续研究进一步基于更强的多模态大模型,拓展视频、音频模态。但随着多模态大模型规模膨胀,衍生出的嵌入模型参数量往往达到数十亿级别,对于低延迟、高吞吐、需要本地离线部署保护隐私的业务场景,成本过高,难以落地。
本文提出EmbeddingGemma 2²,一款参数量 744M 的通用多模态嵌入模型。它将文本、图像、视频、音频以及任意交错组合的多模态输入映射至同一个统一嵌入空间(见图 1)。模型由参数量 271M 的双向 Transformer 主干网络(含嵌入层)、167M 视觉编码器、305M 音频编码器共同构成。各个模态编码器独立将媒体转换为软 token 嵌入序列,送入共享 Transformer 主干。模块化设计带来灵活部署能力:仅加载主干得到 271M 参数量纯文本模型;加载主干 + 视觉编码器得到 439M 参数量图文模型;加载主干 + 音频编码器得到 577M 参数量音文模型。
² 模型开源地址:https://ai.google.dev/gemma/docs/embeddinggemma
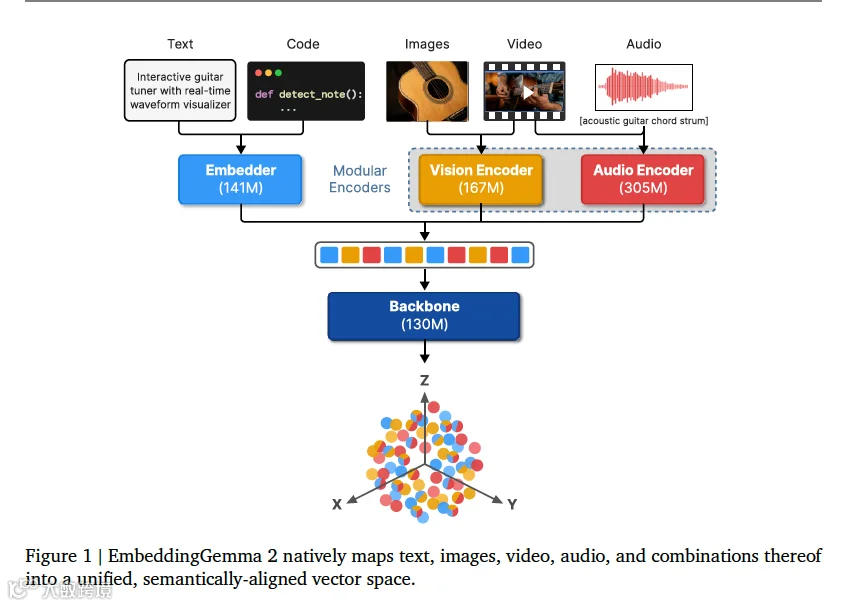
图 1:EmbeddingGemma 2 原生把文本、图像、视频、音频以及它们的组合映射到语义对齐的统一向量空间。
模型基于成熟的 Gemma 4 系列架构与权重构建,同时借鉴 Gemini Embedding 2 的能力。训练流程分为三阶段,覆盖多样化任务、模态与数据域,在代码检索、视觉问答、视频片段检索、音频分类等任务上均表现出众。训练采用课程学习思路,把纯文本训练和多模态训练分开;同时将蒸馏目标与对比、正则化目标拆分,学习适配本模型的嵌入空间。面向资源极度受限场景,模型支持高质量截断嵌入,同时提供经过量化感知训练的独立权重检查点。
本文通过消融实验剖析架构与训练上的关键选择:研究发现,简化每层嵌入、移除专用查找表,不仅降低开销还提升性能;探究训练与推理阶段不同视觉 token 预算带来的效果,发现只有文档检索这类需要精细视觉信息的任务对 token 数量高度敏感;验证视觉编码器联合训练的价值;对比基于对比学习微调与蒸馏微调的差异;证实原生音频理解相比 ASR 转写方案的优势。
最后,我们在 7 套完整基准套件上开展评测,覆盖文本、代码、图像、视频、文档、语音、环境声音输入。EmbeddingGemma 2 在全模态基准上刷新帕累托前沿(见图 2)。相比前代,它文本部分参数量更少,却同时支持更多模态,在多语言文本、代码基准上效果进一步提升;多模态评测中,性能常常对标甚至超越专用、数十亿参数大模型。

图 2:EmbeddingGemma 2 在代码、图像、视频、可视化文档、音频基准上构建新的帕累托前沿。实验方法与完整结果见第 4 章节。*MTEB (Code)、MAEB、MMEB‑v2 取各个任务均值;MIEB (lite) 取类别均值。
2 EmbeddingGemma 2 模型
2.1 模型架构
主干网络主干采用 Transformer 架构,使用双向注意力。给定长度为L的 token 化输入序列T,通过嵌入层\(\varepsilon\)把离散文本 token 映射输入 token 嵌入 \(T_{in}=E(T)\in \mathbb{R}^{L\times d_{M}}\),其中\(d_M\)是 Transformer 内部表征维度(多模态输入同样整合进\(T_{in}\),详见 2.2 节)。 接着使用n层双向注意力 Transformer \(M_n\),输出 token 嵌入序列: \(T_{out}=M_{n}(T_{in}) \in \mathbb{R}^{L\times d_{M}}\)。 随后执行均值池化P,沿着序列维度对输出 token 嵌入求平均,得到表征全部输入信息的单一向量:\(P_{embed}=P(T_{out})\in \mathbb{R}^{d_{M}}\)。 最后使用随机初始化线性投影f将向量映射到目标维度d,再做\(\ell_2\)归一化,得到单位范数最终嵌入:
\(E=\frac{f(P_{embed})}{\left\|f(P_{embed})\right\|_{2}} \in \mathbb{R}^{d}\) EmbeddingGemma 2 配置:层数\(n=24\),模型维度\(d_M=512\),输出嵌入维度\(d=768\)。
Transformer \(M_n\)使用每层嵌入(PLE,Per‑Layer Embeddings),该技术源自 Gemma 3n,以残差输入形式让每一层可以直接接收来自输入 token 嵌入的定制信息。但不同于原版额外配置一套独立、庞大的 PLE 专用 token 查找表,EmbeddingGemma 2 直接复用主嵌入表与模态编码器输出得到的输入嵌入\(T_{in}\)(3.1 节对比实验)。
对每一层\(l\in[n]\),通过线性投影\(p_l\)将输入 token 嵌入映射为该层专属表征,再经过 RMSNorm 归一化: \(P_{l}=RMSNorm(p_{l}(T_{in})) \in \mathbb{R}^{L ×d_{P}}\)。 取该层输出\(H_{l}' \in \mathbb{R}^{L ×d_{M}}\)计算门控: \(G_{l}=\sigma(g_{l}(H_{l}')) \in \mathbb{R}^{L ×d_{p}}\), \(g_l\)为线性投影,\(\sigma\)代表 GELU 激活函数。 使用门控调制每层输入,再通过线性投影\(u_l\)映射回模型维度,经过 RMSNorm 归一化得到更新项: \(U_{l}=RMSNorm(u_{l}(G_{l} \odot P_{l})) \in \mathbb{R}^{L ×d_{M}}\)。 最终该层输出 \(H_{l}=H_{l}'+U_{l}\)送入下一层。 EmbeddingGemma 2 设置 \(d_P=d_M=512\)。
模态编码器视觉编码器沿用 Gemma 4 设计,是 patch 大小 16 的视觉 Transformer(ViT);音频编码器包含两层下采样卷积 + 12 层 Conformer 层,架构源自通用语音模型 USM。 视觉编码器输出软 token 维度\(d_V=768\);音频编码器输出软 token 维度\(d_A=1536\)。通过可学习线性投影\(\phi_{vis}\)、\(\phi_{aud}\)把二者映射到主干模型维度\(d_M\)。这些软 token 和文本 token 嵌入按位置交错拼接,构成完整输入序列\(T_{in} \in \mathbb{R}^{L ×d_{M}}\),交由主干网络处理。 更多多模态输入处理细节见 2.2 节。
2.2 输入处理
输入x一般由\(M≥1\)个有序模态片段构成:\(x=(s_1,s_2,...,s_M)\);每个片段\(s_m\)属于四类模态之一:
- 文本
分词得到\(N_{txt}\)个 token,查表得到 token 嵌入序列:\(T_{txt}=E(s_{m}) \in \mathbb{R}^{N_{txt} ×d_{M}}\)。 - 图像
单张图像送入视觉编码器v,空间池化,控制软 token 总数不超过预算\(N_{vis}\),\(T_{vis}'=V(s_{m}) \in \mathbb{R}^{N_{vis} ×d_{V}}\)。训练阶段图像默认\(N_{vis}=280\),视频每帧默认\(N_{vis}=140\);推理阶段可配置为 70、140、280、560、1120。经过视觉适配器投影,前后增加起止分隔符 token: \(T_{vis}=<|SOI|>\oplus \phi_{vis}(T_{vis}') \oplus<|EOI|>\in \mathbb{R}^{(N_{vis}+2) ×d_{M}}\)。 - 音频
输入拆分为 40ms 分块,采用梅尔滤波器组特征,每秒音频输出 25 个软 token:\(T_{aud}'=A(s_{m}) \in \mathbb{R}^{N_{aud} ×d_{A}}\)。经过音频适配器投影,增加音频起止分隔符 token: \(T_{aud}=<|SOA|>\oplus \phi_{aud}(T_{aud}') \oplus<|EOA|>\in \mathbb{R}^{(N_{aud}+2) ×d_{M}}\)。 - 视频片段
训练评测默认每秒采样 1 帧;长视频进一步采样,控制总帧数预算\(N_{frm}\)(可截断取前\(N_{frm}\)帧,或全局均匀采样\(N_{frm}\)帧)。本文训练评测取\(N_{frm}=32\)。每一帧当作独立图像送入视觉编码器,得到最多\(N_{frm}\)个图像片段,每个片段最多\(N_{vis}\)个软 token 外加两个图像分隔符。
支持视频帧与视频原声音频 token 交错混合输入:每帧图像在前,紧随该时刻之后的音频切分为 1 秒片段。一般一帧对应 1 段 1 秒音频;如果帧做截断,末尾会存在多个音频片段;如果帧做均匀采样,两帧中间可能有多段音频。帧、音频片段前附带MM:SS格式时间戳标注发生时刻。因此视频本质是前面各类模态的组合,生成由\(T_{txt}\)、\(T_{vis}\)、\(T_{aud}\)交错组成的嵌入序列\(T_{vid}\)。
记片段\(s_m\)对应的嵌入序列为\(T_{m} \in\{T_{txt}, T_{vis}, T_{aud}, T_{vid}\}\)。拼接全部片段,增加序列开始、结束标记:
\(T(x)=<|BOS|>\oplus T_{1} \oplus T_{2} \oplus \cdots \oplus T_{M} \oplus<|EOS|>\in \mathbb{R}^{L ×d_{M}}\) 训练阶段总序列长度上限\(L=8192\),该序列即为 2.1 节中的\(T_{in}\)。
每条训练样本包含查询\(q_i\)、正样本\(p_i^+\),可选困难负样本\(\{p_i^-\}\)。查询与目标样本可以附带任务前缀\(t_q\)、\(t_p\)描述任务类型,详见附录 A。例如检索任务:查询使用task: search result | query: {text};目标文档使用title: {title | 'none'} | text: {text}。查询与目标样本编码为\(R^d\)空间向量,见公式 (1)。
\(q_{i}=f(\mathcal {P}(\mathcal {M}_{n}(\mathcal {T}(t_{q}\oplus q_{i})))), p_{i}^{\pm }=f(\mathcal {P}(\mathcal {M}_{n}(\mathcal {T}(t_{p}\oplus p_{i}^{\pm })))). \tag{1}\)
2.3 损失函数
EmbeddingGemma 2 训练使用多种损失;本小节介绍损失形式,2.4 介绍各损失在训练阶段的启用顺序。
对比损失
采用噪声对比估计 NCE 损失,支持批次内负样本、困难负样本、同塔负样本。批次大小为B,对比损失定义为:
其中相似度 \(sim(x, y)=x^{\top} y /\|x\|\|y\|\) 为余弦相似度。\(Z_i^P\)代表正样本项;\(Z_i^{HN}\)困难负样本;\(Z_i^{IB}\)批次内负样本;\(Z_i^{STN}\)同塔负样本。 \(\mathbb{1}_{TN}\)掩码用于过滤重复带来的假负样本:
本文移除前序工作中的困难样本加权机制 —— 该机制会放大噪声弱正样本的影响,加剧不同模态任务之间梯度规模失衡。新增同塔负样本,避免查询、目标样本各自聚类形成互不相交子空间。
对于有序排序列表数据,每个查询对应有序正样本\(p_{i, 1}^{+} \succ \cdots \succ p_{i, P}^{+}\);既可以拆成三元组使用\(\mathcal L_C\)训练,也可以基于 Plackett‑Luce 模型扩展得到列表级损失\(\mathcal L_C^{list}\):
该损失让第r位正样本不仅对比负样本,还要对比排序更靠后的全部正样本;掩码同样过滤重复样本。 同时对正样本、困难负样本相似度增加平方铰链惩罚项,校准阈值类任务的绝对得分分布。
分散正则损失
基于全局正交正则器 GOR,目标是让随机输入对的嵌入统计特性,接近单位球面上均匀独立采样点。延续 EmbeddingGemma 1,只使用原始定义的二阶矩项,均值项会被间接优化到位。
该损失鼓励嵌入向量在空间充分散开,充分利用模型表达能力。已有研究观察嵌入向量容易收缩到狭窄锥形体;而各向同性嵌入在下游任务、向量量化、ANN 近似最近邻检索中都具备理论与实践收益。让随机样本尽量正交,结合平方铰链损失,让相似度分数更具备可解释、可校准的特性。
蒸馏损失
嵌入对齐蒸馏损失。不同于过往蒸馏仅使用教师模型查询‑文档相关性分数作为信号;本损失直接对齐学生 EmbeddingGemma 2 和更强教师 Gemini Embedding 2 的嵌入空间。不需要额外投影层适配维度,直接截断教师模型输出到目标维度。 不只对查询、正样本做嵌入匹配,也对困难负样本做对齐;帮助学生学到教师区分查询与困难负样本的能力,实验证实该操作带来性能提升。各子损失权重均等:
\(\mathcal{L}_{D}=\mathcal{L}_{D}^{q}+\mathcal{L}_{D}^{p^{+}}+\mathcal{L}_{D}^{p^{-}}, \text{ 其中 } \mathcal{L}_{D}^{u}=\frac{1}{B} \sum_{i=1}^{B}\left\| u_{i}-\tilde{u}_{i}\right\| _{2}^{2}, \ u \in\left\{q, p^{+}, p^{-}\right\}. \tag{6}\) \(\tilde u_i\)代表截断并做\(\ell_2\)归一化的教师嵌入;当存在多个困难负样本时\(\mathcal L_D^{p^-}\)取平均。
套娃表征学习 MRL
将对比损失、分散正则损失、蒸馏损失适配套娃表征学习 MRL:把每个损失拆分为k个子损失,分别作用在嵌入向量k组重叠子维度上。EmbeddingGemma 2 原生输出 768 维嵌入,通过 MRL 同时支持 512、256、128 维截断输出。
2.4 训练流程
初始化:模型继承 Gemma 4 的世界知识。主干网络由解码器 Gemma 4 改造,把因果注意力掩码替换为双向注意力,获取完整上下文表征。本文不再设置专门双向注意力适配阶段(该阶段开销大,已有论文证实并非必需)。移除 PLE 专用 token 查找表;Transformer 之后新增均值池化、线性投影、\(\ell_2\)归一化层。视觉编码器权重取自 Gemma4 视觉编码器,在两轮多模态训练阶段继续更新;音频编码器完全复用 Gemma4 E2B/E4B 权重,训练全程冻结。
整体训练总 token 规模约 2.9 万亿:纯文本预微调约 300B token;多模态预微调约 2 万亿 token;多模态微调约 600B token。
- 纯文本预微调
参考 EmbeddingGemma1 方案。大规模无监督混合数据集,包含问答、句子相似度、代码检索、网页搜索多语言查询‑目标样本对。采用更大 batch 稳定梯度,提供更多批次内负样本。该阶段几乎只使用蒸馏损失,搭配很小权重的对比损失。按经验预设比例采样各类任务。纯文本阶段对最终文本能力至关重要,可看作课程学习,也是双向注意力的预热;也有论文指出该阶段同时增强文本、非文本嵌入区分度。 - 多模态预微调
数据集新增图像、音频、视频、文档,覆盖单模态、跨模态、混合模态任务,大部分样本附带困难负样本。文本任务集合沿用 EmbeddingGemma1 微调阶段的数据,保证任务、语言、代码能力多样性。该阶段只使用蒸馏损失,继承教师把各类混合模态映射到共享语义空间的能力。batch 与学习率维持较大;训练步数是文本预微调两倍,适配规模更大的多模态数据集。 - 多模态微调
完全移除蒸馏损失,切换为对比损失。让模型学习适配自身架构、参数量、MRL 子维度的专属嵌入空间,不再模仿教师。同时启用分散正则、MRL 多组子维度损失。学习率、batch 缩小;数据集切换为高质量任务专属数据:工具检索、音频描述、视频排序、医学影像、商品视觉检索、裁剪物体检索、学术问答等。
模型权重融合:将微调过程中不同检查点做权重平均,提升最终模型效果与鲁棒性。不需要跑多组超参数实验;直接对单条微调轨迹上,末尾检查点和较早中间检查点做无加权平均。类似模型汤思路,缓解微调带来部分任务过拟合,同时进一步提升已经受益微调的任务性能。
量化感知训练 QAT:提供多种量化版本。主干网络支持 int4 分块 (Q4_0)、int4 分通道 (Q4_C);视觉编码器权重与激活 8 比特 W8A8;音频编码器沿用 Gemma4 量化方案,不同层簇采用 2/4/8 比特权重、8 比特激活。 主干、视觉编码器执行量化感知训练降低精度损失。不在微调阶段直接做 QAT;而是在权重融合完成后,新增一个尾部微调阶段,以浮点冻结模型为老师做蒸馏,得到量化检查点。该方案计算开销更低,显著缩小浮点‑量化之间性能差距,尤其 MTEB 英文 v2 基准。
表 1 对比浮点 bfloat16 与量化版本。在谷歌 Pixel11 Pro 设备上,Q4_C 量化下推理峰值内存占用:纯文本 191MB;图文 447MB;完整多模态 567MB。
表 1 EmbeddingGemma2、EmbeddingGemma1 浮点与量化检查点在 MTEB、MIEB (lite)、MSEB (Retrieval) 多基准对比。* 分块 int4;†分通道 int4。‡浮点与量化评测使用不同评测工具。
|
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
3 消融实验
通过消融理解关键设计选择如何帮助 EmbeddingGemma2 在多模态、多领域取得高质量嵌入。基线与消融实验使用中间版本训练配方,数值不等于最终完整模型。评测基准选用 MMEB‑v2,该基准覆盖文本、图像、文档、视频各类组合任务(不含音频)。
3.1 每层嵌入 PLE 查找表消融
Gemma3n/Gemma4 的 PLE 机制:主 token 嵌入投影 + 一套独立 PLE 查找表,向 Transformer 中间层注入 token 信息。但独立 PLE 查找表对非文本模态没有直接信号,还额外占用显存。 EmbeddingGemma2 只保留投影分支,完全舍弃专用 PLE 查找表,仅依靠共享\(d_M\)维度嵌入空间生成每层输入。
表 2 是否启用 PLE 专用查找表的 MMEB‑v2 结果
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
去掉专用 PLE 查找表,参数量下降,同时全部子任务指标上涨:视频 + 0.69,可视化文档 + 0.61;纯文本评测同样获得提升 —— 即便原本预期查找表会对纯文本有利。证明完全从共享嵌入空间推导每层输入,可以改善多模态表征质量。
3.2 微调阶段消融
验证微调阶段收益来自训练配方切换,而不是单纯延长训练步数。从多模态预微调检查点出发:一条路线执行完整多模态微调;另一条保持蒸馏目标,使用等价计算量继续延长预微调步数。
表 3 持续蒸馏 vs 切换到带对比损失的微调阶段
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
持续蒸馏很快性能平台;切换到对比 + 分散正则的微调配方后,图像、视频任务显著提升,文档任务基本持平。证明微调让模型跳出模仿教师,学习更适合自身的表征空间。
3.3 视觉编码器是否参与训练消融
很多多模态大模型、多模态嵌入模型会冻结模态编码器权重。本文对比视觉编码器可训练 / 冻结两种设置。两组实验都先跑完纯文本预微调,再跑多模态预微调,保证实验条件公平。
表 4 视觉编码器可训练 vs 冻结
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
即便 Gemma4 视觉编码器本身能力很强,联合训练视觉编码器依旧大幅提升多模态嵌入效果。推测音频编码器进一步训练也会带来类似收益。
补充讨论:部分工作选择同时冻结文本主干,好处是可以复用旧向量数据库不需要重新编码;但冻结主干会限制模型理解多模态输入的能力,目前最强的多模态嵌入模型大多主干和模态编码器一起微调。
3.4 视觉 Token 预算消融
训练时图像 token 预算 280,视频每帧 token 预算 140;推理阶段可以在 70‑1120 之间自由切换。
表 5 训练、推理阶段不同视觉 token 预算效果。上半部分:模型训练固定图像 280 / 视频帧 140,推理时缩放 token 数量。下半部分:训练时视频帧分别使用 70、140token。两组实验使用不同中间训练配方。
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
推理端 token 增大,总体性能单调上升,但模态表现各有差异:
-
可视化文档任务高度依赖精细细节,token 超过训练预算依旧持续大涨; -
图像任务在 280token 附近趋于饱和; -
视频任务在 280→560token 反而下降:序列过长稀释注意力、均值池化表征被干扰。
下半部分对比训练视频帧用 70 vs140token: 推理 70token 场景,训练视频帧使用 70token,视频任务指标小幅提升;但是图像、可视化文档指标下降。原因:图像训练依旧维持 280token,不会受益 70token 视频;粗粒度视频表征丢失空间细节,反而损害通用视觉能力。推理 140token 条件下,训练视频帧 70token 各项指标更差。综合看训练视频帧 140token 是更稳妥选择。进一步提升训练 token 理论上收益有限,但计算开销会急剧上涨。
4 评测
在覆盖多模态、多任务、多语言的全套基准开展评测:
-
MTEB:大规模文本嵌入基准,自然语言 + 代码; -
MMEB‑v2:大规模多模态嵌入基准 v2,图像、视频、可视化文档; -
MIEB (lite):大规模图像嵌入基准精简版; -
MSEB、MAEB:大规模声音、大规模音频嵌入基准,语音、音乐、环境音。
4.1 评测设置
基线选取各排行榜顶尖模型,包含单模态专用、支持全部模态的通用多模态嵌入。
-
MTEB、MAEB、MIEB (lite) 对比参数量小于 1B 模型; -
MMEB‑v2 对比参数量小于 2B 模型(小尺寸公开模型较少)。
复现 jina‑embeddings‑v5‑omni‑nano 在 MMEB‑v2 指标,其余基线数值取自公开榜单。仅对比输出单向量模型;排除训练集与评测数据重合超过 25% 的模型,避免数据污染。
EmbeddingGemma2 使用 bfloat16 半精度权重;使用附录 A 中 7 套任务指令前缀。不同模态任务使用对应序列长度;视觉输入:每幅图像 280token,视频最多 32 帧、每帧 140token。注意可视化文档任务还可以进一步调高 token 获取更高效果。
多模态场景参数量统计:只统计当前任务实际启用的编码器参数量;其他模型参数量直接引用榜单报告。
表 6 EmbeddingGemma2 与相近规模多模态、单模态顶尖模型汇总对比。* 不支持该模态;‑无公开分数;†通过 ASR 转写音频。
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
4.2 文本评测
MTEB 包含 162 项任务,覆盖 250 + 自然语言、14 + 编程语言,20 个数据域,10 大类任务:双语挖掘、分类、聚类、指令检索、多标签分类、配对分类、重排序、检索、语义相似度、摘要。
虽然 EmbeddingGemma2 文本部分参数量更低,还要和音视频共享统一嵌入空间,但多语言效果超越前代,主要来自双语挖掘、分类任务提升;英文指标小幅回落。小于 1B 参数量模型中,仅有两个纯文本专用模型多语言得分更高、一个模型英文得分更高。整体文本竞争力强,优于很多规模大得多的模型。
代码 MTEB (Code):EmbeddingGemma2 开辟新帕累托前沿,所有参数量小于 4B 的模型中排名第一;距离规模是自身 28 倍的榜首模型只差不到 2 分。MRL 截断维度性能衰减平缓,256 维依旧保持很强实力。详见表 7。
4.3 视觉评测
MMEB‑v2 包含 78 项图像、视频、可视化文档(PDF、幻灯片、图表)任务,涵盖检索、分类、问答、视觉定位、视频片段检索,隐式考验目标检测、计数、OCR、时序推理,包含大量跨模态、混合模态场景。 MIEB (lite) 补充线性探测分类、聚类、多选、组合性、视觉语义相似度任务。
EmbeddingGemma2 是 MMEB‑v2 榜单上参数量最小的模型。尤其擅长分类、检索;总体得分仅次于 2B 左右规模模型;超过部分 8B + 参数量的图文专用模型。MIEB (lite) 只有两个 4B 以上大模型优于本模型。对比 1B 以内基线,聚合指标大幅领先(任务均值 + 7.9,类型均值 + 12.2);多语言视觉 STS 提升 + 22.8,多语言检索 + 12.5。即便截断到 128 维,依旧优于全部其它 1B 以内模型的完整维度版本。详见表 8、表 9。
4.4 音频评测
MAEB 包含 30 项任务,五大声学域:语音、音乐、环境音、生物声学、情绪;任务类型:检索、重排序、聚类、多类分类,覆盖单模态、跨模态。MSEB (Retrieval) 侧重多语言语音理解:口语查询检索文本段落,支持同语言、跨语言,覆盖 26 种语言与方言。
在 MAEB 上 EmbeddingGemma2 建立效率新前沿。参数量 1B 以内模型中,任意‑任意检索、音频分类取得 SOTA;约三分之一单项任务取得 1B 内最优;部分任务在全部规模模型中 SOTA。任务均值距离 1B 内最优模型只差 0.2,距离全局最高分差 3.5。128 维截断嵌入依旧超过其它全部 1B 以内模型。
和音频‑文本专用模型对比存在能力分化:EmbeddingGemma2 在非语音任务(车辆声音聚类)超过 CLAP 这类专家模型;但音频描述检索 ClothoT2ARetrieval 等任务专家模型更强。语音相关任务表现亮眼:多语言 FleursT2ARetrieval、歌唱歌词检索 JamAltLyricA2TRetrieval 取得 SOTA。
零样本副语言学任务存在短板:例如 VoxPopuliGenderClustering 按说话人性别聚类得分仅 0.4;但是接上线性探测 IEMOCAPGender 可以恢复到 66.4。说明模型语音表征优先编码语义,有意弱化说话人人口统计类偏见;但声学副语言特征依旧保存在表征中,可以通过线性探测提取。
MSEB 检索进一步验证原生音频编码的巨大优势。即便 EmbeddingGemma2 使用 ASR 转写文本的模式,也显著优于初代 EmbeddingGemma1;开启原生音频编码再次大幅提升。原生音频不受口音、同音词、转录噪声干扰;256 维原生嵌入就已经全面超过 768 维 ASR 转写方案。
表 11 MSEB (Retrieval) 对比原生音频编码与 ASR 转写方案,指标 MRR@10
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
5 未来工作方向
EmbeddingGemma2 已经支持长序列、可变视觉 token 预算。后续可以借助内容感知技术进一步拓展上下文长度,直接索引完整长媒体,提升长时序任务,支持智能体记忆系统。无编码器架构有机会进一步降低显存与延迟,同时提升效果。面向下游 RAG 做端到端联合训练,可以针对落地场景进一步优化嵌入模型。随着交错式全模态检索普及,需要更贴合真实业务的评测框架。
EmbeddingGemma2 用途不限于输出单向量用于检索。无论是最终池化向量,还是未池化 token 序列,都可以复用做通用多模态编码器,适配零样本或者微调,用作决策模型、模型路由、奖励模型、重排序器、语音相关模型、晚交互检索器等。
6 结论
EmbeddingGemma2 继承前代工作,主干规模更小、能力更强,原生支持多模态。简化每层嵌入、采用模态‑目标函数多阶段课程训练,使得模型在文本、视觉、音频全套基准开辟帕累托最优前沿,性能经常远超参数量数倍的专用 / 通用大模型。结合权重量化、套娃截断嵌入、模块化编码器按需加载,让高质量多模态嵌入在资源受限、本地部署场景成为现实。我们开源权重,供社区开箱即用,也可以作为基础多模态编码器支撑进一步研究开发。
参考文献(略)
附录
附录 A 任务指令前缀
表 12 EmbeddingGemma2 使用的任务指令前缀。非对称任务查询与目标格式不同;无文档标题填写
title: none;对称任务查询、目标使用相同前缀。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
附录 B 多语言与英文 MTEB 完整榜单
表 13 参数量小于 1B 模型在 MTEB (Multilingual v2) 的详细对比(略) 表 14 参数量小于 1B 模型在 MTEB (English v2) 的详细对比(略)
附录 C 完整评测任务结果
包含 MTEB 多语言、MTEB 英文、MTEB 代码、MAEB、MSEB 检索、MIEB (lite)、MMEB‑v2 全部单项任务数值,见论文原文表 15‑19。
贡献与致谢
核心贡献者(* 等同贡献)Henrique Schechter Vera,Sahil Dua,Jovan Andonov,Sara Smoot,Sebastian Russo,Ivan Llanos,Max Matveev,Jae Hyeon Yoo,Kat Black……(完整名单见原文)
Gemini Embedding 团队、项目领导、致谢人员名单略。
说明:
-
专业术语统一:embedding 翻译为嵌入;token 保留英文;backbone 主干网络;contrastive loss 对比损失;distillation 蒸馏;curriculum learning 课程学习;quantization‑aware‑training QAT 量化感知训练;pareto frontier 帕累托前沿。 -
数学公式保留原版公式编号;表格、图注全部翻译;参考文献、附录完整保留结构; -
长句按中文科技论文习惯拆分,保证技术含义无失真。 -
原文附录 C 大量超长任务分数表格因篇幅,仅保留表头说明,完整原始数值参见论文 PDF。