


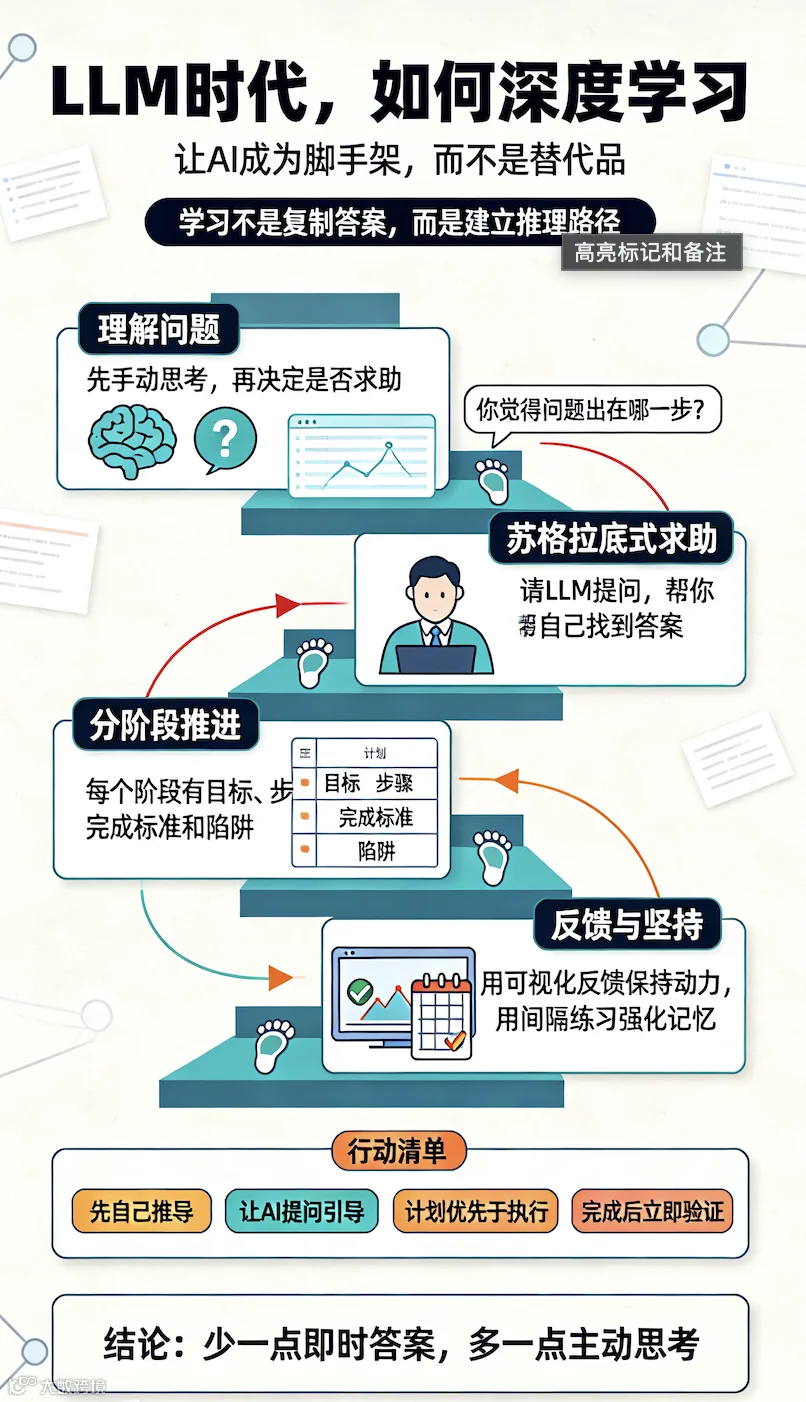
编者摘要:大模型不是用来直接获取答案的工具,而应该作为苏格拉底式导师,引导我们自主思考,保留试错挣扎的学习过程。作者以实现 Bitcask、tinylsm(LSM 树)数据库项目为例,提出一套实操方法:
-
学习主线由自己完成,大模型只负责提问引导,不直接给出解决方案;枯燥的辅助工作(测试、工具、可视化 REPL)交给 AI,节省精力聚焦核心知识点。 -
借助大模型做项目拆解,分阶段制定计划,每个阶段定义可验证的完成标准,收获阶段性小胜利,对抗拖延与意志力消耗。 -
利用间隔练习,碎片化持续迭代项目;搭建可视化反馈,持续激发学习动力。 -
敢于挑战超出能力边界的项目,遇到不懂的地方反复让 AI 讲解,拒绝停留在简单内容。
底层理论来自《认知天性》:先挣扎解题,再看答案,记忆才牢固;同时引用铃木俊隆的思想,强调全身心投入。
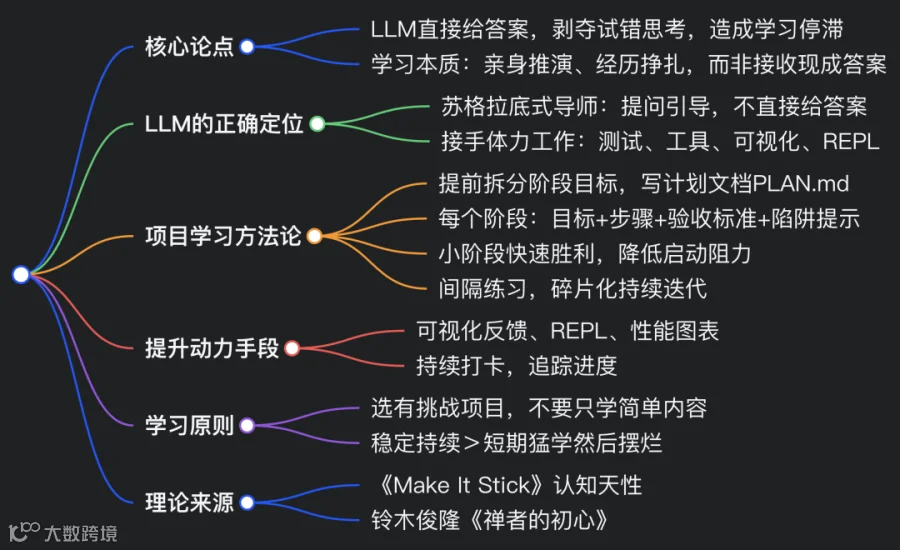
10 个关键问题Q&A
-
Q:为什么大模型直接给出代码,反而不利于学习? A:跳过了独立思考、排查错误的挣扎过程。大脑没有主动推演,记忆很浅,容易学完就忘,还会产生能力错觉。 -
Q:苏格拉底式代码导师是什么? A:一种提示词模式,AI 不直接给出答案,通过层层提问,引导学习者自主定位问题、推导出解决方案。 -
Q:哪些工作适合交给大模型,哪些必须自己写? A:核心逻辑、算法、底层原理必须自己动手;测试代码、脚手架、可视化、辅助工具这类非学习目标的枯燥工作交给 AI。 -
Q:PLAN.md 项目计划文档有哪 4 个组成部分? A:阶段目标、细分步骤、可验证完成标准、需要注意的陷阱。 -
Q:文中提到的间隔练习原理是什么? A:多次学习之间产生一定遗忘,大脑主动提取知识的费力过程,会强化长期记忆。 -
Q:可视化反馈对学习的作用是什么? A:快速看到成果,提供正向激励,对抗多巴胺缺失带来的放弃冲动,维持好奇心。 -
Q:作者为什么选择动手实现 Bitcask、LSM 树数据库? A:属于有挑战的底层项目,强迫自己深入理解存储原理;可以阶段性验证成果,适合这套学习方法。 -
Q:“黄金准则:每个阶段结束,系统必须可运行、测试全部通过” 的意义? A:避免半成品堆积;每次学习结束都留下可验证成果,收获成就感,防止项目烂尾。 -
Q:如何对抗大模型、短视频带来的即时多巴胺,克服拖延? A:预先规划,减少每次学习时的决策消耗;目标拆小,每次学习都能拿到小胜利,降低启动成本。 -
Q:这套学习方法只适用于编程吗? A:作者说编程是例子,原理通用。任何领域都可以:AI 做资料整理、辅助验证,自己做核心推理与实践。
发布时间:2026 年 10 月 4 日
我想聊聊在大模型时代,我是如何持续学习新知识的 —— 因为这件事如今变得格外艰难。大模型、AI、智能体,随便你怎么称呼它们,能够一次性给出完整结果,却夺走了试错本身带来的乐趣。这里我主要以编程为例,但这套思路适用于任何领域。
过去,我们学习框架、编程语言、设计模式,都是先踩坑出错,再从错误里吸取教训。但现在一切来得太快,我们不愿花时间去经历失败,尽管从长期来看,试错对学习更有益。恰恰是这种挣扎的过程,才是大脑真正掌握新知识的方式。
坦白说,我自己也犯过这个毛病。以前我肯埋头苦啃知识,现在却觉得这么做毫无意义,毕竟大模型可以直接给出你想要的一切。这些想法最终促使我反思:我遇到了学习瓶颈,出于工作需求和个人兴趣,我需要继续学习。下面就是我重新找到的、适配大模型时代的学习方法。
当时我在读一篇名为 Bitcask 的论文。如果你对编程感兴趣,我建议读一读。这篇论文非常简明,就算不是资深程序员也能看懂;只要愿意动手,里面的概念很好理解,也能落地实现。
于是我打算,不借助任何大模型辅助,亲手实现 Bitcask,并且基本做到了。写代码途中我一度卡住,当时我想用大模型,但目的不是让它帮我写出这一段代码,而是请它把底层概念讲清楚,由我自己完成实现。那一刻我意识到:我们完全可以用大模型来教学,而不是让它直接给出全部答案。
大模型还可以接手枯燥的体力活,避免学习过程变得乏味。举个例子,如果你想写一个聊天应用来学习知识,需要服务端和客户端,而你只想练习服务端逻辑。如果客户端并不是你的学习重点,何苦耗费精力写它,消磨学习动力?这正是大模型的用武之地。你可以交给大模型处理乏味的部分:测试代码、工具链、可视化展示。我不是说这些内容毫无价值,只是如果它们不是你的学习目标,不必亲自去写。
之后我参考别人的实践,找到了一种叫「苏格拉底式代码导师(socratic-code-mentor)」的提示词技巧。它不会直接甩给你答案,而是提出恰当的问题,引导你自己推导出结果,这样学到的内容才能真正记住。
下面是一个简化示例:
我:求和结果应该是 6,但我得到了 NaN
const nums = [1, 2, 3];
let sum = 0;
for (let i = 0; i <= nums.length; i++)
  sum += nums[i];
console.log(sum); // NaN
大模型:nums 数组里有几个元素?最后一个下标是多少?
我:3 个元素,最后下标是 2。 大模型:循环中 i 会依次取哪些值? 我:0、1、2、3…… 哦。nums [3] 是 undefined,数字加 undefined 就会得到 NaN。 大模型:没错。
index:   0  1  2  3
nums:   [1, 2, 3] undefined
i:       ▲  ▲  ▲  ▲  ← 循环多跑了一次
大模型:你该怎么修改? 我:改成 i < nums.length。
在这个例子里,大模型没有直接告诉我 “循环多迭代了一次”,而是通过提问、简单图示,引导我自己定位 bug。这个知识点我很难忘掉,因为整个思考推导是我独立完成的。
学习,是靠自己推演得出结论,而不是被动接收现成结论。《认知天性》(如果你对学习心理学感兴趣,强烈推荐这本书)里有一句话说得很好:
在看到解法之前,先努力尝试解决问题;当你经历过一番挣扎之后,再看到解决方案,会学得更好,记忆也更持久。
就连我公司的首席技术官,也常用这种启发式提问和我讨论。当我问:“我们为什么不采用方案 X?”,他会反问:你觉得我们为什么应该用 X?我阐述自己的理由,他继续针对我的回答提出下一个问题,最后我自己得出合理结论。这样学到的东西,记忆会非常牢固。
所以,你要主动锻炼大脑。这套苏格拉底式提示词的核心,就是不断提出问题,驱动思考。
第二个难题:维持学习热情,这需要自律。如果你在做一个有一定复杂度的学习项目,不可能一夜完工。提前规划目标,你就不会浪费时间纠结下一步该干什么。不然,每次打开电脑,你可能会对着空白屏幕发呆半小时 —— 至少我是这样。缺少动力、自律不足时,人很容易拖延。
理想状态是:你坐到电脑前,对大模型说一句 “继续”,它就能从上次中断的地方带你接着往下做。有意思的是,大模型非常擅长帮你拆解目标清单。
比如你想动手写一个简易版 LevelDB,通俗来说就是实现 LSM 树(非程序员读者,见谅)。你可以让大模型把项目拆分成多个阶段,每个阶段目标清晰。每次开始学习,就完成一项,打勾打卡。
学完 Bitcask 之后,我想挑战难度更高、和数据库相关的项目,于是动手实现 LSM 树,项目名叫 tinylsm(我大概会持续做这类 tiny-xxx 小项目)。下面是项目 PLAN.md 的精简版本,仓库地址:https://github.com/ogzhanolguncu/tinylsm
# tinylsm — 开发计划
黄金准则:每个阶段结束,系统必须可运行、测试全部通过。绝不并行开发两个半成品功能。

## 阶段2 — WAL(预写日志)
目标:程序崩溃后数据不丢失。所有写入先写入日志,再写入内存;崩溃重启后重放日志,保证已完成写入不会丢失。

步骤:
1. 单条记录的编码与解码
2. 将记录追加写入文件
3. 启动时重放日志文件;遇到写入一半的不完整记录,干净终止解析

完成标准:在写入中途强制杀死进程,重启程序,所有写完的数据都能恢复。

注意陷阱:崩溃会造成最后一条记录只写了一半。这属于预期情况,不算数据损坏。

## 进度
- [x] 阶段1 — 跳表
- [x] 阶段2 — WAL
- [ ] 阶段3 — 内存表
- [ ] ……
每个阶段都包含四块内容:目标、细分小步骤、可验证的完成标准,以及需要提防的坑。底部的清单就是那句 “继续” 的依托:大模型读取文档,就能知道你当前进度。
这样一来,你不用耗费意志力去思考下一步干什么。启动学习本身,就比想象中消耗更多精力。而现在,大模型、短视频不断带来即时多巴胺刺激,启动学习的门槛更高了。我们总想快速看到结果。一份计划恰好能解决这个问题。就算你身心疲惫,也可以完成一小部分,收获一次小小的胜利。
这种学习方式的效果也更好:连续数天、数周,每次短时间持续迭代同一个项目。就像铃木俊隆禅师的比喻:行走在浓雾之中,你不会察觉自己慢慢被打湿,但雾气一点点浸润全身。心理学家称之为间隔练习:两次学习之间产生一定程度的遗忘,大脑需要主动回忆知识,这个费力提取的过程,才会把知识牢牢刻进记忆。
到这里,我们讲了两件事:正确使用大模型,而不是直接索要答案;做好规划,避免无休止拖延。但还有一点没有提到。
对我个人而言,如果能获得可视化反馈,我会更加享受学习。可以是粗糙简陋的 UI、交互式命令行 REPL,任何形式都行。它能让我持续投入,保持好奇心,期待后续成果。
tinylsm 项目里,我让大模型写了一个简易 REPL。我可以往数据库写入数据,观察多层数据表不断增长,还可以做读取性能压测:
tinylsm> bench
miss latency vs L0 height
     88 tables ██████████████████████████████ 174.9µs
      1 table  ░░░░░░░░░░░░░░░░░░░░░░░░░░░░░░   1.7µs
说实话,亲眼看到自己写的合并代码,把读取速度提升上百倍,极大点燃了我的动力。
建议你下一个大型学习项目也这么做。文末我分享的提示词技巧也包含这个思路,你也可以自由发挥想象力。借助大模型,你可以搭建任何能够激励自己继续前进的反馈工具。
最后一条建议:选择有挑战性的项目。在大模型出现之前,实现 LSM 树这类东西,需要翻阅大量 GitHub 仓库、啃多本书籍的特定章节。现在,你只需要说一句 “我想搞懂 XYZ 的原理”,大模型就可以帮你检索资料,搜集所需素材。某种意义上学习门槛变低了,但我们也变得更懒惰。想来一直都是如此,人天生容易贪图省事。
总结(写给和我一样懒人的极简摘要)
-
不要让大模型直接给出答案,把它当作你的导师。 -
交给大模型处理体力活:测试、工具链等等。 -
提前和大模型一起制定计划,用最少意志力维持学习动力 —— 我们本就没有多少意志力。 -
让进度可视化:REPL、图表,任何能留住你的反馈形式。 -
追求小而快的阶段性成果。哪怕每天只学习 30 分钟,保持稳定坚持,也好过突击两天,然后搁置十天。 -
保持好奇心,尝试学习超出你当前能力范围的内容。就算你自认不算聪明,你可以反复对大模型说 “我看不懂”,让它一遍遍地解释。不要停留在简单内容上。
文末附上我使用的提示词脚本:https://gist.github.com/ogzhanolguncu/274e9974dc02942109ad70200f6d7b25 我在原版基础上,根据自己的学习方式做了修改,你可以拿去,按需调整适配自己。
用一句我奉为信条的话收尾:
做事之时,应当全然投入,如同熊熊篝火,燃尽自我,不留一丝余烬。 —— 铃木俊隆

参考文献
-
Justin Sheehy, David Smith. Bitcask: A Log-Structured Hash Table for Fast Key/Value Data. Basho Technologies, 2010 -
Peter C. Brown, Henry L. Roediger III, Mark A. McDaniel. Make It Stick: The Science of Successful Learning. Harvard University Press, 2014 -
Shunryu Suzuki. Zen Mind, Beginner’s Mind: Informal Talks on Zen Meditation and Practice. Weatherhill, 1970