
发表期刊:bioRxiv,预印本
研究领域:基因组基础模型、跨物种序列建模、遗传变异效应预测、非编码调控、基因组可解释性、可控长序列生成
ML/DL方法:自回归 Transformer、稀疏混合专家模型(MoE)、系统发育信息引导的专家路由、多尺度门控注意力、下一 token 预测、长上下文训练、条件生成、Context–Anchor–Body(CAB)生成策略
文章创新:提出 DeepD,将跨生命域全基因组预训练、单碱基分辨率建模和百万 token 上下文结合,在同一模型中支持序列功能预测、基因组特征解析及可控长序列生成。
1
研究背景:理解基因组,需要同时看清一个碱基与整段序列
一个碱基发生改变,会不会影响基因功能?距离基因数万碱基的调控元件,能否被模型识别?如果让模型生成一段百万碱基长的 DNA,它能否保留合理的基因结构、排列顺序和调控特征?这些问题,把基因组模型推向了两个相互关联的目标:预测已有序列的功能,以及生成具有合理生物学结构的新序列。两者都面临尺度上的困难。
在局部,一个碱基的变化就可能影响剪接、蛋白质编码或调控元件活性。在更长的尺度上,基因功能又与周围的调控序列、重复元件和基因组组织有关。与此同时,不同物种的基因组具有不同的碱基组成、密码子使用偏好和序列结构。能够处理人类序列,并不意味着模型自然掌握了植物、真菌或细菌的规律。长序列生成还增加了另一层挑战:随着生成不断延伸,局部错误可能累积,最终破坏基因结构或基因排列。
DeepD 因此尝试将三个环节结合起来:
从完整基因组中学习序列规律,用稀疏计算支持长上下文,再通过参考序列两侧的信息约束长序列生成。
2
核心技术
核心技术一:把基因与基因间区一起纳入学习
基因组中的大量序列并不编码蛋白质,却可能参与调控、结构组织和演化。如果训练数据主要围绕已知基因及其邻近区域组织,模型接触到的基因组空间就会受到限制。
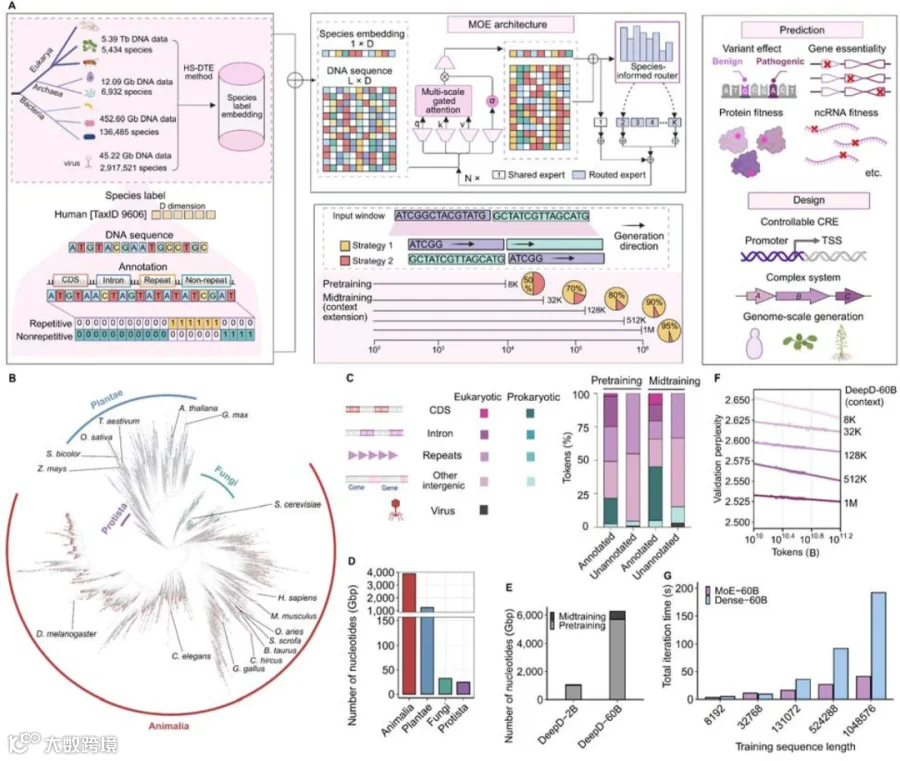
DeepD 采用全基因组预训练,将基因区域与广泛的基因间区共同纳入学习,覆盖真核生物、细菌、古菌和病毒序列。其中保留了编码区、内含子、重复序列以及其他非编码区域。提供了两个规模的模型:

这里的 token 以单核苷酸为基本单位,因此模型可以在单碱基分辨率下学习序列。对于重复区域,DeepD 在保留其原始上下文的同时,降低相关位置对训练损失的贡献,以减少高频重复序列对优化过程的主导。这一设计让模型既接触基因组中的重复结构,又为其他区域保留学习空间。
核心技术二:用物种信息引导专家分工
跨物种训练需要解决一个问题:哪些规律可以共享,哪些规律需要区分。
DeepD 使用稀疏混合专家架构,让不同输入调用不同的专家子网络。在 DeepD-60B 中,模型配置了 576 个专家,每个 token 只调用其中一部分。虽然总参数量约为 630 亿,但每个 token 激活的参数约为 10 亿。这使模型能够扩大容量,同时控制实际参与计算的参数规模。DeepD 还将系统发育树信息转化为物种表示,并将其接入专家路由。路由器因此能够同时参考当前位置的序列特征与物种背景,为不同输入分配专家。
研究通过碱基组成和密码子偏好测试,观察到这种条件信息的作用。例如,在提供物种标签后,生成序列的 GC 含量能够更好地接近对应物种;模型也能够反映人类与酵母不同的密码子使用偏好。这些结果支持 DeepD 学到了一部分物种相关的序列规律。
核心技术三:在单碱基精度下,把上下文扩展到百万长度
基因组建模既需要识别局部模式,也需要整合远距离信息。DeepD 因此在注意力结构中结合滑动窗口注意力与全局注意力:前者关注邻近序列,后者支持更远位置之间的信息交流。模型先在较短上下文中预训练,再逐步将窗口从约 8K 扩展到 1M token。在单核苷酸 token 设置下,这对应约百万碱基的输入尺度。随着上下文延长,验证集困惑度继续下降,说明模型能够利用新增上下文改善序列预测。长窗口也为识别远端调控区域提供了结构条件。
核心技术四:通过 CAB,让长序列生成持续受到约束
长 DNA 序列生成需要解决的不只是“继续往后写”。
如果生成只能依赖前面的序列,模型可能逐渐偏离合理的基因组结构。对于参考序列附近的设计任务,目标片段下游的信息同样有价值。DeepD 提出 Context–Anchor–Body,简称 CAB。其中,Anchor 提供待生成区域上游的锚定信息,Context 提供下游背景,Body 是当前需要生成的片段。模型在两侧信息约束下生成局部片段,再将新生成的序列用于下一轮延伸。通过这种逐段推进的方式,总输出长度可以超过单次上下文窗口,同时持续参考目标区域的结构信息。
3
核心成果
核心成果一:同一模型支持跨物种功能预测与人类变异评估
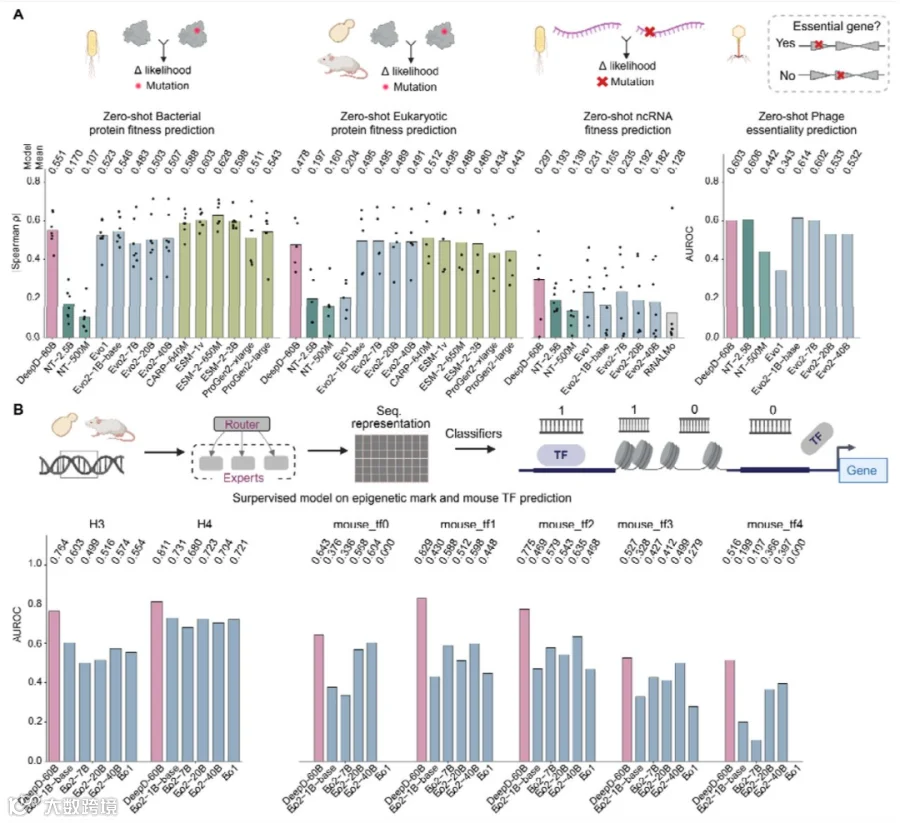
DeepD 首先接受了多类序列功能预测评估。在零样本设置下,研究者利用序列似然或其变化构造功能评分,无需针对每个任务再训练专门的预测模型。部分结果如下:

其中,非编码 RNA 任务涵盖 rRNA、tRNA 和核酶等数据,DeepD 在论文比较的模型中取得最高平均得分。这里的相关系数反映预测评分与实验测量之间的排序关系,不能解释为分类准确率。
在人类变异评估中,DeepD 在 ClinVar 单核苷酸变异任务上的 AUROC 为 0.934,在非单核苷酸变异任务上为 0.965。论文也评估了 BRCA1、BRCA2 等基因相关任务。这些结果表明,基于广泛基因组序列学习得到的表示,可以为不同类型的功能评估提供信号。研究还使用 DeepD 的表示训练下游分类器,评估启动子、转录因子结合和剪接位点等任务。这部分属于有监督预测,需要与前面的零样本结果区分。
DeepD 也并非在所有任务上领先。作者官网列出的比较显示,AlphaGenome 在人类转录因子结合和剪接位点预测中更强;DeepD 则在所报告的启动子和核心启动子检测任务中得分更高。
核心成果二:专家路由中包含可识别的基因组结构信息

研究者提取 DeepD 的专家门控权重,并在这些表示上训练轻量分类器,识别不同基因组注释类别。结果显示,这些路由表示包含了多类结构信息。
在大肠杆菌中,相关信号能够对应 CRISPR 阵列的重复与间隔结构,以及乳糖操纵子中的基因区域。在人类基因组中,路由表示能够支持编码区和不同重复元件类别的识别。在重复序列丰富的玉米基因组中,百万上下文模型对部分基因结构、顺式调控元件和转座元件的识别优于短上下文版本。一个代表性案例是玉米驯化相关基因 tb1:模型表示能够支持识别其上游约 60 kb 处、已有功能验证的 Hopscotch 增强子。
需要明确的是,这些结果来自路由表示与监督分类器的组合。它们说明模型内部包含可用于解码生物学注释的信息,
核心成果三:生成强弱可区分的玉米核心启动子,并接受实验验证

从功能预测走向序列设计,一个直接的问题是:生成序列能否呈现预期活性?
研究者使用带有启动子活性信息的数据微调 DeepD,并引入 High、Low 两类条件,生成约 170 bp 的玉米核心启动子。经过筛选后,部分序列进入玉米原生质体中的双荧光素酶实验。结果显示:
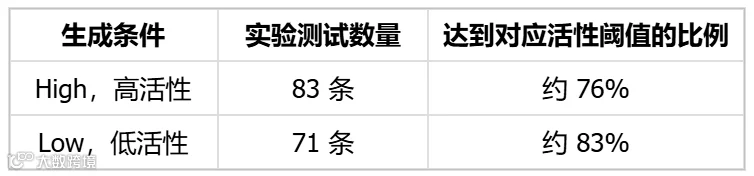
这些结果为生成序列提供了实验层面的功能证据。研究还观察到,高活性设计中出现了位置较符合天然植物核心启动子特征的 TATA box 和 Y patch。
核心成果四:生成整条酵母染色体序列与百万碱基植物片段
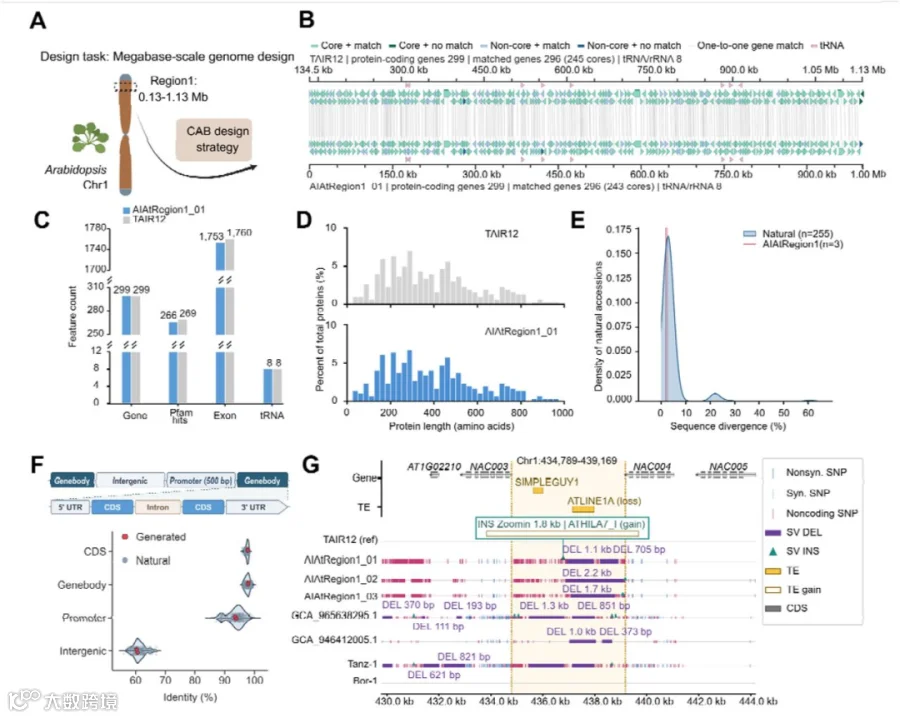
更长尺度的评估,关注生成序列能否维持基因组组织。
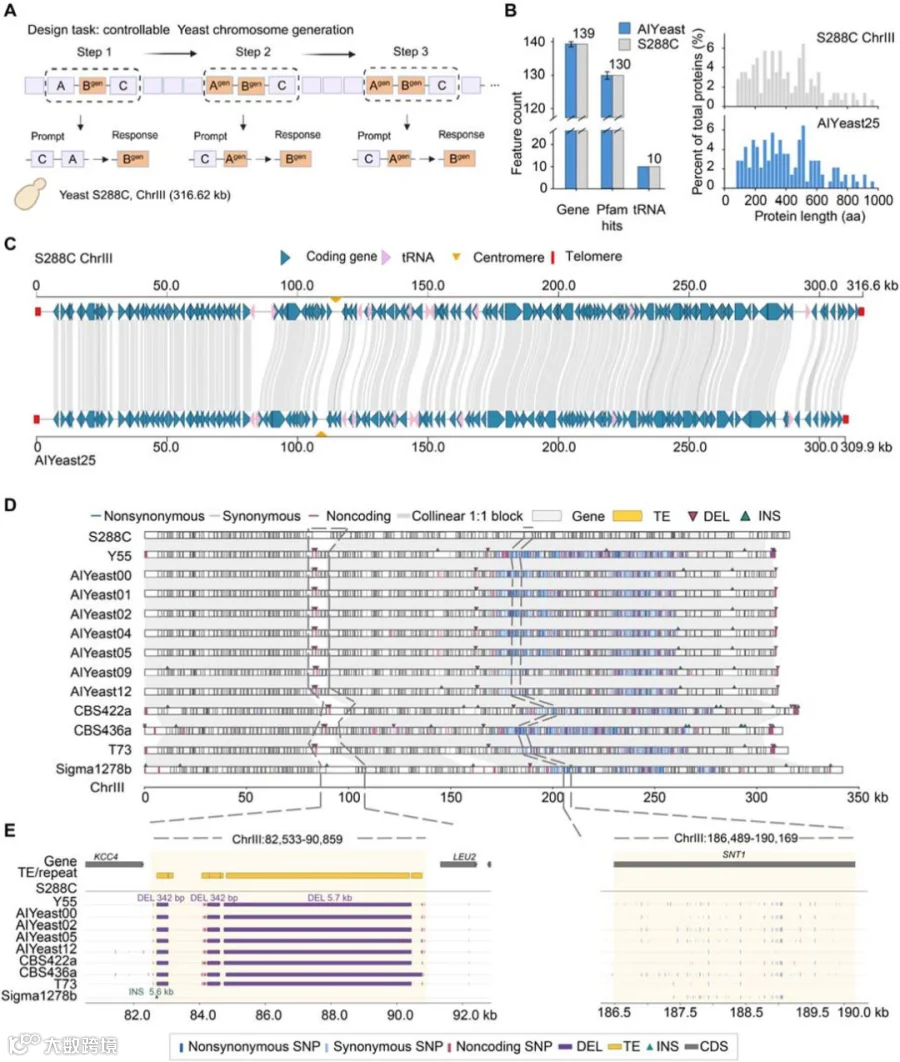
在酵母任务中,模型使用 762 份酿酒酵母基因组进行微调,S288C 参考基因组在这一微调阶段被留出。随后,研究者以 S288C 为骨架,生成了 29 条完整长度的第三号染色体序列,长度约为 309.9—316.6 kb。生成序列包含约 138—140 个编码基因,与参考序列的 139 个接近;tRNA 数量也与参考保持一致。代表序列 AIYeast25 与参考具有广泛的基因共线性,其 SNP 均可在所比较的天然分离株中找到,且未观察到终止获得突变。
这说明,生成结果在所分析的基因结构与变异特征上,能够接近天然群体中的序列。在拟南芥任务中,研究者将生成范围扩展到染色体 1 上约 1 Mb 的区间,并生成了三条独立序列。代表序列 AIAtRegion1_01 的结果包括:

生成序列中的变化更多分布在约束相对较弱的区域,编码区则更为保守,与天然基因组中的部分变异规律相符。但 99.2% 是该代表序列的核心基因恢复率。它不能解释为整段序列具有 99.2% 的功能正确率。作者也指出,部分未完整恢复的基因存在阅读框受损等问题。
4
文章创新
第一,将基因与广泛的基因间区共同纳入预训练。模型学习的范围覆盖编码、调控和重复序列,为理解不同区域的序列规律提供基础。
第二,用系统发育信息辅助专家路由。在跨物种共享参数的同时,引入物种背景,帮助模型处理碱基组成和编码偏好的差异。
第三,结合稀疏计算与长上下文。在扩大模型容量的同时控制激活计算量,并以单碱基分辨率处理百万长度输入。
第四,通过 CAB 持续约束长序列生成。利用待生成区域两侧的信息逐段推进,在生成变化的同时尽量保留参考骨架中的基因结构和排列。
第五,在同一框架中连接预测、解释与设计。评估覆盖功能评分、路由表示分析、启动子实验验证及长序列结构分析,但不同结果所支持的结论层级仍需分别判断。
5
DeepD 距离可靠的基因组设计还有多远?
DeepD 展示了跨物种基因组模型的一条路线:从序列中学习可迁移的规律,再将这些规律用于功能评估和条件生成。不过,DNA 序列只是生物系统的一层信息。细胞类型、染色质状态、环境条件和三维基因组组织,都可能影响一段序列最终表现出的功能。因此,序列模型的预测仍需要放回具体的生物学背景中解释。
长序列生成则需要跨越更大的验证距离。基因数量接近、共线性较好、变异分布类似天然群体,都是有价值的计算证据;但基因表达是否正常、染色体能否稳定维持、序列能否支持预期表型,仍需要实验回答。
DeepD 的实际价值,是为功能变异筛选、调控元件设计和长序列研究提供候选与分析工具。其适用范围,将随着更严格的独立评估和更多功能实验逐步明确。
基于文章中所使用的先进技术,包括深度学习,联川生物为您提供最前沿的生物分析解决方案。联川生物的专业团队将这些先进技术与丰富的经验相结合,为您提供高效、精准的服务。无论您的需求是基础研究还是临床诊断,我们都能够为您提供量身定制的解决方案。选择联川生物,让您的研究获得最新科技的支持,开创更广阔的科学道路。
DeepD 预印本:https://www.biorxiv.org/content/10.64898/2026.10.13.758170v1
DeepD 作者官网与结果展示:https://biomap-research.github.io/DeepD-website/
官方分析代码、使用示例与 API 说明:https://github.com/biomap-research/DeepD
学术研究 API 申请入口:https://biomap-research.github.io/DeepD-website/#api