

过去三年,视频领域出现了三股并行的浪潮。
视频理解:Video-LLaVA、Qwen3-VL 等 Video-LLM 让我们可以用语言和视频对话,上下文已经扩展到 256K token。
视频生成:Sora、Wan、HunyuanVideo、Movie Gen、Seedance 2.0 等模型让分钟级、可控的视频合成成为现实。
理解与生成统一:Emu3、Show-o、UniVideo 等模型试图用共享的 token、潜空间或接口把感知和合成放进同一个框架。
与此同时,另一条线正在升温:世界模型。从 Genie 到 GAIA、Cosmos,再到 V-JEPA 2 和 Dreamer 4,研究者希望模型不只是「看懂」或「画出」视频,而是预测世界如何演化,并支持推理和规划。
这几条线正在汇合。视频世界模型必须先从观测中推断状态,再预测状态如何变化,往往还要把预测渲染回视频;视频生成器越来越多地接受动作和状态作为控制条件;统一模型则显式地把理解和生成耦合起来。
已有综述大多各自覆盖其中一条线(通用世界模型、交互式视频世界模型、3D/4D 世界建模、具身世界模型……),但没有一个框架能把「理解—生成—统一—交互」放在同一张图里解释。
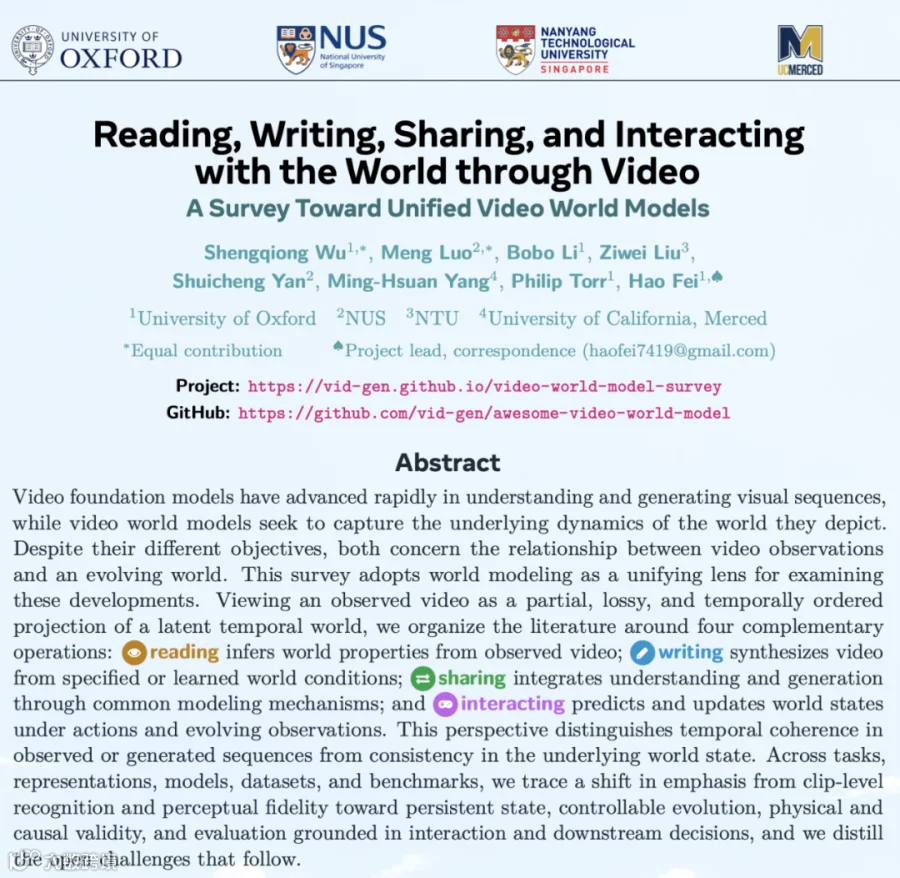
牛津大学联合新加坡国立大学、南洋理工大学这篇综述的目标,就是补上这块拼图。
01
核心框架:一个世界,四种操作
综述把一段视频V看作对一个潜在时序世界W的部分的、有损的、按时间排列的观测。模型内部维护的是一个「表示状态」St,它一般不等于真实世界状态 Wt。
在这个前提下,所有工作被归为四种操作:
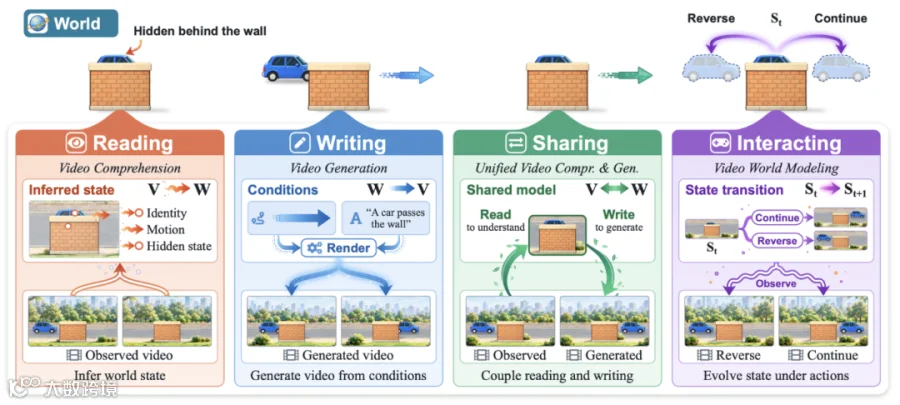

这个划分的关键不是输入输出模态,而是模型与世界建立的关系。同一个系统可以同时执行多种操作:统一编辑器先「读」源视频再「写」修改版;交互式世界模型读历史、写下一帧、更新状态,全在一个骨干网络里完成。
两种一致性,必须分开
综述特别区分了两个经常被混用的概念:
时间连贯性(temporal coherence):相邻帧局部一致,没有闪烁、没有不合理的突变。
世界一致性(world consistency):整段视频能对应到某条合法的世界轨迹——身份、布局、动力学、物理和因果约束都成立。
一个视频可以非常流畅,却在世界层面自相矛盾(墙后的车凭空消失)。只用前者来评价世界模型,是当前评测中最常见的误区。
证据阶梯:你的主张需要多强的证据
为了避免「在单个任务上表现好 = 学到了世界模型」这种过度推断,综述给每种操作定义了四级证据:
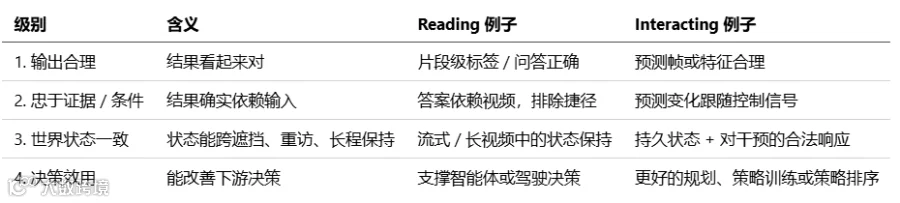
要做更强的世界建模主张,就需要更高一级的证据。
02
全景图:四个领域的知识图谱
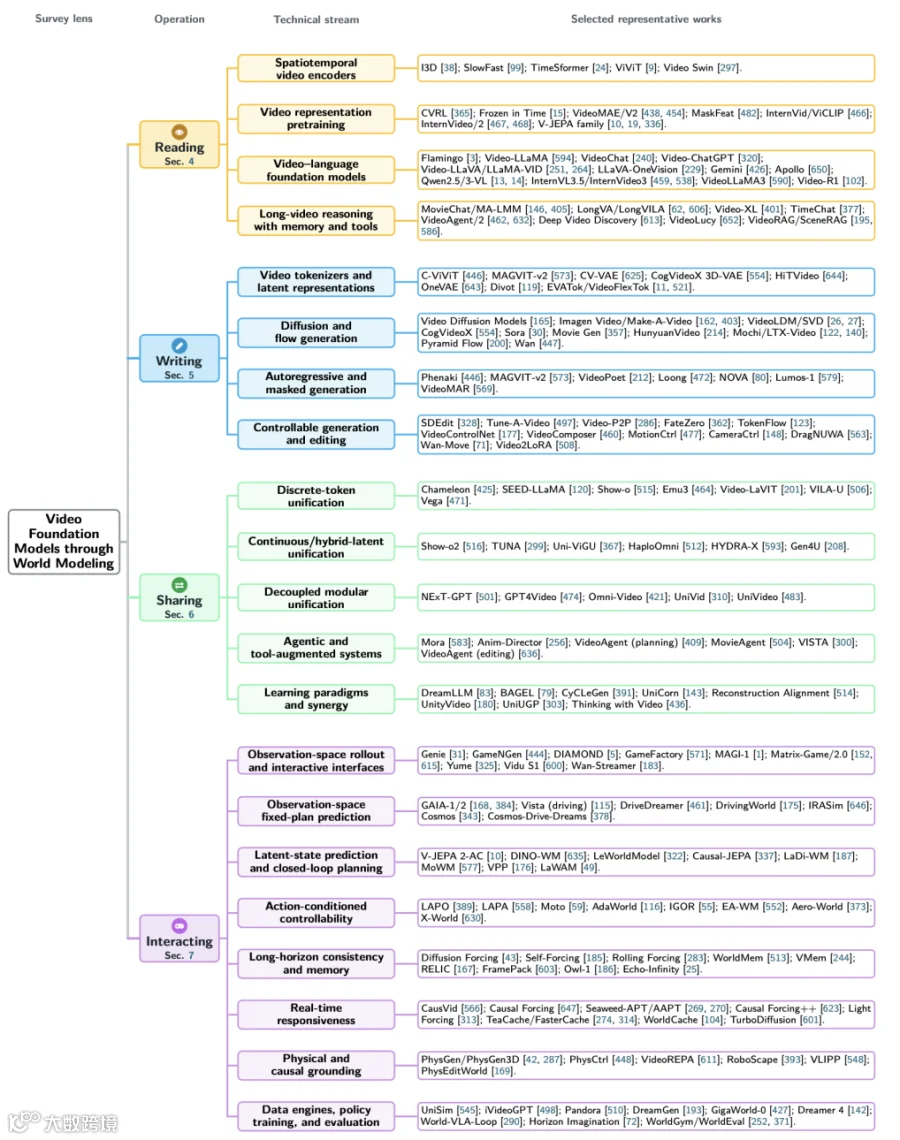
每个操作下再分为若干技术流,并列出代表工作。
Reading 覆盖时空编码器、表示预训练、视频-语言基础模型、长视频推理;
Writing 覆盖 tokenizer 与潜表示、扩散/流生成、自回归/掩码生成、可控生成与编辑;
Sharing 覆盖离散 token、连续/混合潜空间、解耦模块化、智能体式四类统一方案;
Interacting 覆盖观测空间 rollout、固定计划预测、潜状态规划、动作可控性、长程记忆、实时响应、物理因果 grounding、数据引擎与评测。
03
Reading:理解受限于「状态」,
而不是上下文长度

视频表示学习分成四个家族:对比学习(视频-视频、视频-文本)、掩码学习(像素重建、特征重建)、预测学习(在潜空间预测被遮挡的部分,如 V-JEPA)、生成学习(视觉续写、字幕生成)。
在此之上,Video-LLM 把视觉证据映射到语言,视频智能体(VideoAgent 等)决定该看哪里、调用什么工具。综述的一个核心观察是:
编码器压缩观测,Video-LLM 把证据映射成语言,智能体选择看什么——它们共同的瓶颈不是能接受多少帧,而是能保持并 grounding 多少状态。 更长的上下文只有在它能修正或稳定状态估计时才有用。评测应该问:新增的证据是否改善了状态估计、是否可追溯到源片段、是否能经受后续提问的检验。
04
Writing:渲染保真和状态可控
是两条独立的轴

生成的第一步是选择潜表示:连续潜空间(逐帧 VAE、时空 VAE、因果 VAE)、离散 token(VQ、残差量化、无码本量化如 FSQ/LFQ/BSQ)、混合表示,以及和语义对齐的表示(同时服务理解与生成)。
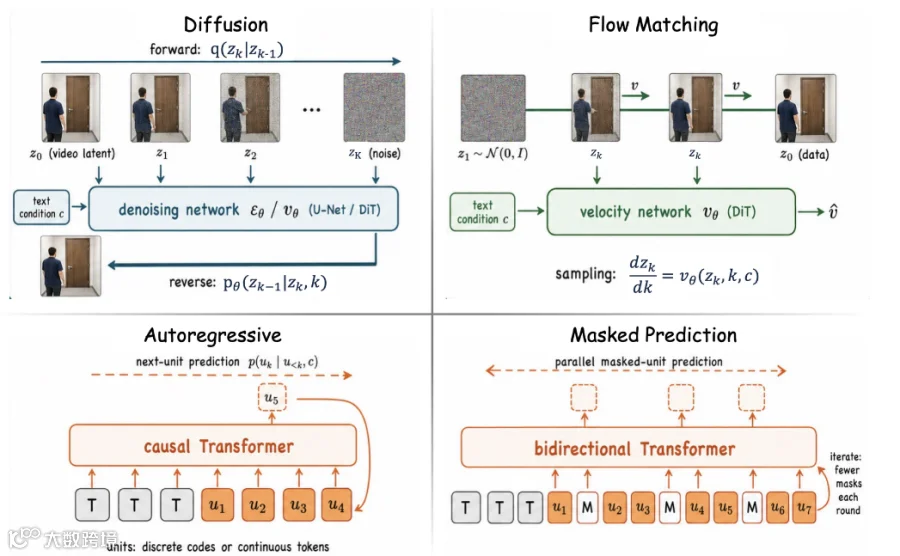
生成范式有四种:扩散、流匹配、自回归、掩码预测。
综述统一了记号(ZK → Zk → Zk-1 → Z0),并讨论了它们在长视频生成中的组合方式(Diffusion Forcing、Self Forcing 等)。

更重要的是控制。综述按「干预发生在哪里」把控制机制分为六类:输入级条件(通道/token/上下文拼接)、注意力操控、潜空间控制(部分加噪、反演、潜条件构造)、适配器/残差注入、参数与嵌入微调、采样引导(如 classifier-free guidance)。
视频先验让每一段片段越来越逼真,但视觉保真和有状态的控制是两个目标。 一个好的控制应该只改变它的目标、让改变随时间保持、并能与其他控制组合而不破坏身份、几何和运动。进展应该通过比较「有控制 vs 无控制」的匹配 rollout 来衡量,而不是单看每段 rollout 的质量。
05
Sharing:「协同」需要
受控的跨向迁移
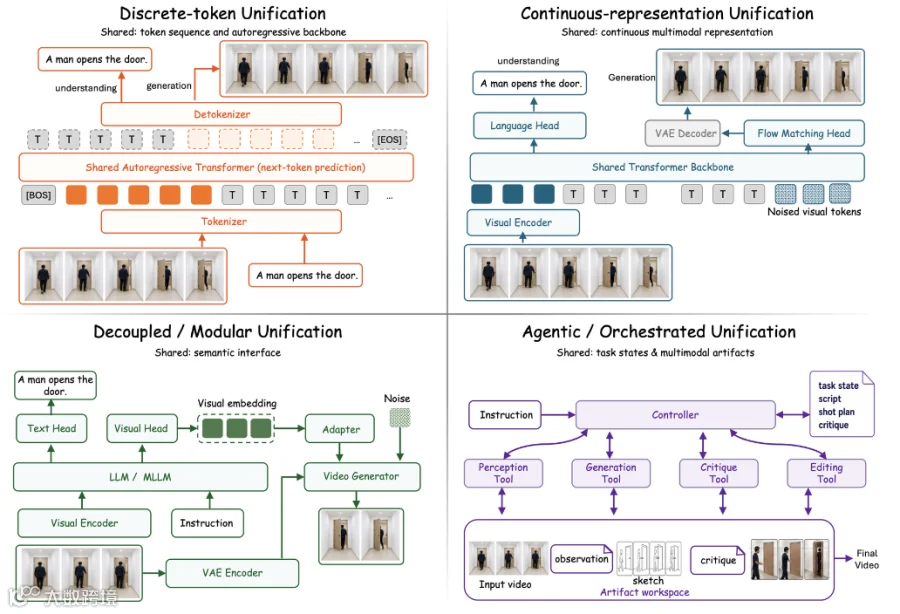
统一模型按「共享的是什么」分为四个家族:离散 token 统一(共享 token 序列和自回归骨干,如 Emu3、Show-o)、连续表示统一(共享连续多模态表示,如 Show-o2、TUNA)、解耦/模块化统一(共享语义接口,如 NExT-GPT、Omni-Video)、智能体/编排式统一(共享任务状态与多模态产物,如 Mora、VISTA)。
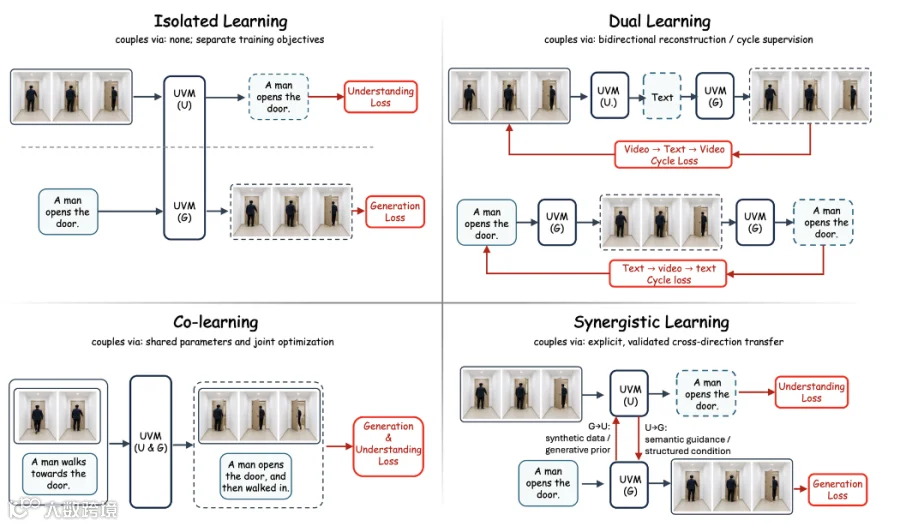
训练方式也分四种:孤立学习、对偶学习(循环监督)、联合学习(共享参数)、协同学习(显式的、经过验证的跨向迁移)。
综述把统一模型的评测分为三层:能力覆盖(两个方向都能做)、架构共享(确实共享了什么)、功能协同(在资源匹配下,一个方向是否真的改善了另一个方向)。
共享 token 或参数只能说明耦合,分开的分数只能说明能力,混合任务只能说明互操作。 要证明协同,需要受控对比:在匹配的数据、容量和算力下消融跨向路径,测量生成、理解或集成任务的变化。
06
Interacting:2×3 的
世界模型分类

综述用两个轴给视频世界模型分类:
预测空间:预测观测(帧、视频 token、可解码的潜变量)还是预测潜状态(视频衍生的特征,不要求渲染)。
转移接口:被动(无动作输入)、动作条件(控制在预测前固定)、交互式(反馈后接受新控制)。
六个格子分别对应:预测视频(SV2P)、预测可控视频(GAIA-1、Vista、IRASim)、推进视觉世界(Genie、DIAMOND、GameNGen)、预测掩码特征(V-JEPA / V-JEPA 2)、rollout 候选特征(DINO-WM、V-JEPA 2-AC)、规划-行动-再规划(MPC 闭环)。
一个模型可以占据多个格子:动作条件的潜预测器既可以给固定候选动作打分,也可以放进「行动—观测—再规划」的闭环。注意力模式并不决定列的归属:只要模型能在输出帧之间接受新控制,它就是交互式的。
在此基础上,这一章逐一讨论了控制、记忆、实时响应、物理/因果 grounding、应用(数据引擎、策略训练、评测)和评测协议。
证据应该与转移协议匹配。 被动模型要展示预测结构;受控模型还要在动作作用处改变世界、在其他地方保持不变;交互系统要在反馈下保持这些后果;决策应用要把它们变成更好的选择。
07
七个开放挑战

综述归纳了跨越四种操作的七个挑战:
(1)长程世界一致性:遮挡期间隐藏状态仍在演化,回放旧观测会错过这种变化(上图:被挡住的冰块在融化)。
(2)物理与因果 grounding:改变重力应该只改变轨迹,不应改变无关的场景属性。
(3)可测量的协同:资源匹配的两个系统,只在「理解和生成之间是否传递信息」上不同。
(4)世界属性的标准化评测:视频预测和特征预测需要不同的探针,但要面对同样的决策测试。
(5)从无标注视频扩展控制:动作效果与相机、背景运动混在一起。
(6)跨场景和跨具身的泛化:留出的「场景—身体」组合,测试熟悉因素能否组合、动作效果能否保持。
(7)随机世界与罕见事件:合法的未来在频率上不同,无效样本和不可读样本要分开计数。

扩展世界模型需要的是干预,而不只是更多片段。 被动视频扩大了覆盖面,但隐藏状态、物理原因、跨向迁移、动作语义和结果概率仍然欠定。观测规模告诉我们什么会共同出现;干预才告诉我们什么改变了什么。
08
结语
这篇综述没有把任何一种架构、任务或模态当作中心,而是把「视频观测与其背后动态世界的关系」作为组织原则。在这个视角下:
理解恢复视频所揭示的内容;
生成从条件构造视频;
统一在二者之间共享信息和机制;
世界建模追问表示状态在条件或动作下如何变化。
下一阶段需要更强的证据:能经受遮挡、重访和长程考验的状态;可控的动作效果;对干预的合法响应;闭环使用下满足控制预算的延迟。满足这些要求,这个领域才会从「渲染出令人信服的视频」走向「建模世界如何变化」。
END
关注+星标,获取AI前沿进展与开源一线动态