

来自普渡大学与 Meshy AI 的研究团队,在arXiv预印本《 Branch-Centric Tokenization and Test-Time Augmentation for Skeleton Generation》中,围绕自回归骨骼生成提出了两项改进(本文简称 BranchTokens):用以分支为中心的编码方式,让同一条骨骼分支上的关节在 token(词元)序列中保持相邻;在推理时旋转输入网格,从多个朝向生成候选,再结合几何覆盖程度与候选之间的一致性选出最终骨骼。
论文链接:https://arxiv.org/pdf/2609.06218
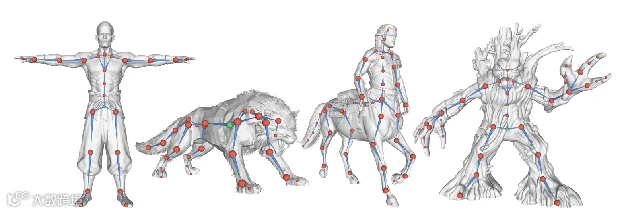
不同类型网格上的骨骼生成结果,涵盖人类、动物和幻想生物,展示方法对多样身体结构的适应能力。
近年来,一类自动骨骼生成方法开始借鉴语言模型的做法:先将输入网格编码为形状特征,再把骨骼表示成由关节坐标和结构标记组成的 token 序列,由 Transformer 逐个预测。这样既可以处理不同的关节数量,也能在同一套生成过程中描述关节位置与连接关系。
但骨骼原本是一棵树,把它展开成序列时,采用什么顺序,以及如何表示连接关系,直接影响模型需要学习的关系。一类方法按空间坐标对关节排序,但这一顺序本身并不直接表达骨骼的父子关系;另一类方法使用广度优先搜索(BFS),从根节点开始逐层遍历骨骼。这个顺序能够保留层级关系,却可能把同一条分支上的节点分散到序列的不同位置。例如,一条手臂上的多个关节,在逐层遍历中可能被另一条手臂或其他分支的节点隔开。模型要继续生成这条手臂,就需要跨过中间的信息,重新接上此前的结构线索。
另外,在当前数据集中,推理阶段还有另一类不确定性:不同来源的 3D 资产未必采用相同的直立方向。同一个模型,在不同坐标朝向下,可能得到质量不同的骨骼预测。
这篇论文分别从这两个问题入手:先让骨骼的序列组织更贴近分支结构,再让推理过程利用不同朝向提供的预测信息。
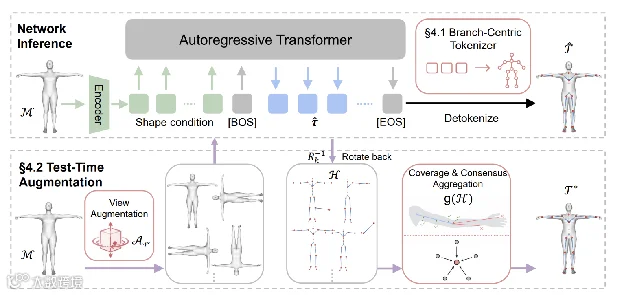
整体框架。上半部分展示网格条件下的自回归生成与分支编码解码;下半部分展示旋转输入、生成候选、逆旋转对齐,以及基于覆盖度与一致性的最终筛选。
同一条分支上的关节,应该在序列里靠近
理解基于分支的 token 编码(Branch-Centric Tokenization,BCT),可以先把骨骼中的节点分成三类:连接三个及以上邻居的分叉节点(junction node),只连接一个邻居的叶节点(leaf node),以及连接两个邻居的中间节点(connection node)。分叉节点和叶节点确定骨骼的分支结构,中间节点则刻画各分支的形状。
据此,研究人员先对骨骼树做结构约简:暂时移除度为 2 的中间节点,把它两侧的边合并,同时始终保留根节点。约简之后,每一条边对应原骨骼中的一段分支。这里的“移除”只是为了确定编码顺序,原有关节会在后续步骤中完整放回。
在序列化过程中,对约简后的骨骼树进行 BFS,以确定分支之间的访问顺序。访问某条分支时,先输出它的子端点,再沿着朝向父端点的路径,依次补回中间节点。编码还通过结构标记记录分支边界与层级关系,使解码时能够恢复骨骼连接。这样,一条分支被连续写入序列,模型可以在相邻的上下文中处理这段结构。
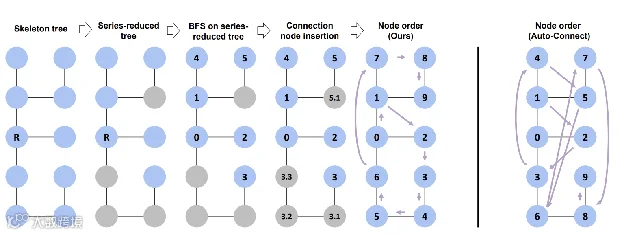
两种节点顺序对比,BCT 通过树约简和节点回插,使同一分支保持连续
分支之间的顺序也经过了专门设计。对于同一个父节点的多个子节点,论文采用距离感知遍历(Distance-Aware Traversal,DAT),按它们到父节点的欧氏距离从近到远排序。由于旋转不会改变这些距离,该规则有助于在不同朝向下保持一致的兄弟节点排序。

token 序列长度分布对比。相比采用 BFS 编码的 Auto-Connect,新编码在绝大多数样本中产生更短的序列。
这一调整还让序列变得更紧凑。在论文的主数据集 上,相比采用 BFS 编码的 Auto-Connect,平均 token 序列长度从 146.3 降至 127.6,缩短约 12.8%;在 94.4% 的样本中,新编码都更短。它在保留原有关节的同时,减少了序列表示的长度,也让同一分支内的信息更加集中。
把网格换个朝向,再判断哪套骨骼更合理
方法第二项改进发生在测试时。研究人员构造了六种旋转,分别将坐标轴的正负方向对齐到标准 z 轴,其中包括保持原方向不变。模型对每个旋转后的网格独立生成一套骨骼,再通过逆旋转把所有预测映射回同一个坐标系。
通过旋转三维网格,模型能够从不同朝向生成候选,缓解资产直立方向不统一带来的预测差异。
困难在于如何合并这些结果。分类模型可以对多次预测的类别概率求平均,但骨骼候选的关节数量、位置和连接关系可能都不相同,很难直接逐关节平均。论文因此采用候选选择:对每套完整骨骼评分,选出其中最合适的一套。
评分由两个部分组成。第一部分衡量骨骼对网格的覆盖程度。系统从网格表面均匀采样 500 个点,计算每个点到最近骨骼线段的距离,再通过指数函数汇总为覆盖分数。直观上,这个指标衡量骨骼对物体各区域的覆盖情况,有助于筛除遗漏细长部件的候选。
第二部分衡量不同候选骨骼的关节分布一致性。系统使用 Sinkhorn 距离比较不同候选的关节集合,衡量一套预测与其余预测的接近程度。这个比较不要求预先给不同骨骼的关节建立一一对应关系,也能够处理关节数量不同的情况。
两项指标相加后,系统选择总分最低的候选。覆盖项提供输入几何的约束,一致性项则帮助抑制偏离其他预测的结果。
精度提升来自编码与推理两端
主实验在一个公开的 3D 骨骼研究数据集 (约5.7 万个样本)进行训练。为便于公平比较,模型的网格编码器与自回归解码器结构与对比基线 Auto-Connect 保持一致,以标准的下一 token 预测方式训练;实现细节见论文。
CD-J2J、CD-J2B 和 CD-B2B 用于衡量预测骨骼与参考骨骼之间的几何差异,分别从关节—关节、关节—骨段和骨段—骨段三个层面进行比较,数值越低越好。
在论文的主基准测试集上,相较于 Auto-Connect,包含测试时增强的 BranchTokens 的完整方法在这三项指标上分别降低误差 8.1%、16.9% 和 14.0%。跨数据集测试也呈现了相同趋势。
编码消融实验进一步评估了 BCT 与 DAT 各自的作用。在同一数据集上,消融基线的 CD-J2B 为 1.864,加入 BCT 后降至 1.798,再加入 DAT 后降至 1.770。这组结果支持了两个设计各自的作用:按分支组织节点有效,稳定分支间的访问顺序还能带来额外收益。
推理消融进一步比较了固定生成六个候选时的不同方案。在原始朝向下,通过随机采样生成候选,再按长度归一化后的序列似然筛选候选,CD-J2B 为 1.779;将网格旋转到六个不同朝向分别生成候选,再结合几何覆盖程度与候选间的一致性择优,该指标降至 1.687。
这项工作的能力边界同样清楚。首先,旋转增强主要针对输入朝向不一致的问题。如果未来能够可靠地把所有资产统一到相同直立方向,这部分增强的必要性可能降低。其次,候选选择最终仍然从已有预测中挑选一套骨骼,无法保证修复所有候选共有的错误。作者也指出,本研究没有探索后训练。将分支编码和基于覆盖度与一致性的候选筛选与已有后训练方法结合,能否获得互补收益,仍需要进一步实验。
BranchTokens 表明,骨骼生成的改进也可以来自表示方式与推理策略:按分支组织序列,让模型更容易学习骨骼结构;结合几何覆盖度与候选一致性进行筛选,则帮助模型选出更合理的预测。两者共同提升骨骼生成质量,为后续蒙皮和动画制作提供基础。
