大数跨境

峰瑞资本李丰:AI越热闹,越要分清技术与资本周期

峰瑞资本李丰:AI越热闹,越要分清技术与资本周期 潮涌AI
2026-10-30
7
导读:资本周期决定估值、财富效应和资源配置,技术周期决定能力最终能走到哪里。
©潮涌AI编辑部
AI到底有没有泡沫?
10月28日,峰瑞资本创始合伙人李丰走上北京大学“AI创业与投资”的讲台,没有直接给出一个简单的“有”或“没有”。
他把问题拆成两条线:资本周期决定估值、财富效应和资源配置,技术周期决定能力最终能走到哪里。两条线恰好叠加,造就了这一轮AI空前的关注度;但资本退潮,并不等于技术停止前进。
李丰的经历横跨创业、投资与北大校友网络。他1991年入读北京大学化学系,之后获美国罗彻斯特大学化学硕士学位,曾在新东方任职七年,联合创办秒针系统,后担任IDG资本合伙人,2015年创立峰瑞资本。早期投资案例包括B站、三只松鼠等,近年来重点关注消费与深科技。
也正因为既创过业、又长期做早期投资,他讲AI时更关心两个问题:钱为什么在此刻涌进来,技术又凭什么在泡沫之后继续落地。
先交代两件事:
1、本文是潮涌AI根据李丰北大演讲整理的口述稿,演讲时间为2026年10月28日,未经讲者审定;以第一人称呈现,部分口语表述有精简和顺句。
2、我们核心收录了资本周期、大模型演进、物理世界的数据难题、AI商业模式,以及圆桌和现场问答中的关键判断;课件翻页、现场寒暄和部分重复表达没有全部保留。
这篇口述稿的核心内容:
  • 李丰从2020年后的全球流动性讲起,解释为什么这一轮AI热潮是技术周期与罕见资本周期的叠加;
  • 用互联网泡沫、新能源车与自动驾驶的反复,说明真正影响深远的技术通常要经历多个周期;
  • 从语料的来源往下推,提出AI进入物理世界的两道坎:高精度数据不足,以及概率模型如何处理确定性因果;
  • 最后落到token成本、端侧模型、传感器、AI for Science与服务业应用,以及他未来一年会重点看的方向。
以下为演讲实录的正文部分——
AI为什么这么热:技术周期叠加了资本周期
今天AI这么受关注,除了它本身是一项重要技术,还因为它叠加了一次资本周期。
往小了说,是叠加了一次比较重要的泡沫。
于是,它爆发出技术之外的巨大财富效应,引起足够多的关注和资源注入,也引起中美两个国家足够多的重视。
怎么判断一个周期有没有泡沫?
我经常用两句话概括:在一个周期的前半段,最典型的特征是所有搞金融的人都在研究技术;到了后半段,非常明显的特点是搞技术的人都在研究金融。
刚开始讨论模型时,懂和不懂技术的人都要搞清楚大模型是怎么回事,新版本有哪些功能,能力外延在哪里。
到了后半段,大家关心的是公司股价还能不能涨、期权还能不能值钱、上市以后到底值一万亿美元还是两万亿美元。
这就是周期的前半段和后半段。
资本周期和技术周期各自发展,有时很凑巧地加在一起,有时也会错峰。
这两件事要分开看。
泡沫之后,技术还要过好几个周期
上一轮最常被拿来类比的,是互联网泡沫。
那一轮最后估值最高的不是今天的“七姐妹”,而是思科。
为什么最后是思科?因为大家觉得,不管那些dot-com公司谁生谁死,互联网要普及,最早都得铺光纤、做交换机。这是不能免的基础设施。
思科的市值一度高到约5700亿美元。今天美国M2与2000年前后相比大了许多倍,全球资金也更多,现在市值最高的公司已经接近6万亿美元。
这个比较,不是说6万亿美元就是顶部,而是给大家一个观察维度。
这轮AI周期引人关注,是因为它叠加了空前的资本周期。把两件事放在一起叙事很简单,但简单叙事不等于事情发生的真实逻辑。
有人说,今天所有AI公司都有长期协议,产品供不应求。
我给两个反例。
芯片和光伏都是周期性行业,每一次接近周期顶部时,市场上都有超过三年的长期购买协议和供不应求,没有一次例外。
互联网泡沫破裂时,思科、北电这些做交换机和光缆基础设施的公司,手里也握有几百亿美元的长期合同。
后来很多合同没有执行,要么买方放弃,要么公司没了。
一级市场在一个技术周期里的叙事,通常有几个阶段:
第一阶段,大家投谁能讲出最有想象力的故事;
第二阶段,投谁能把故事变成最有想象力的应用,但最有想象力的应用,往往也意味着很难落地。
泡沫接近尾声或者破了以后,不管一级还是二级市场,最后都会走向落地。只是很不幸,到真正讲落地时,估值泡沫往往已经不在了。
每一个对人类影响足够大的技术,不管是蒸汽机、电,还是互联网,都不会只经过一个周期。它要在“投入—泡沫—回落—应用扩散”里走好几轮。每一轮靠资本投入推进研发,再靠泡沫退去后的阶段,让技术在应用里生根发芽,证明有人愿意使用、愿意付费。
如果我们在这一个资本周期里就把AGI做完了,通常意味着这个AGI的能力没有那么厉害。真正具有很大能力、影响力和应用范围的技术,最后一定要过好几个周期。
新能源车和自动驾驶已经演示过这种反复。蔚来在低谷时获得合肥战略投资,后来随着新能源车渗透率提升,又进入新的发展阶段。自动驾驶从2014年前后热起来,中间经历多轮起伏,今天走到L3,依然不能说周期已经结束。
特斯拉也很会利用资本市场的叙事。
上海工厂、FSD、机器人、AI、太空算力,不同阶段有不同的故事。马斯克是伟大的企业家,但即便是他,也要受资本市场周期影响。
大模型不是突然出现的,投资也不是追名词
我在大模型上有一段很惨痛的经历。
今天AI各个方向,我们都有排在第一行的被投公司,而且大多从天使轮开始投,唯独没有投到大模型。
2021年,我去看过智谱,当时估值不到5亿元人民币。
为什么去看?
因为BERT出来以后,想看看自然语言处理有没有新模式。
那时智谱还在做知识图谱,商业模式是科技情报分析,为不同需求的客户做信息抽取、检索和归类。
这个商业模式可能太小,犹豫来犹豫去就没投。
所以,至少在2022年底以前,投智谱的人,往光明了说是投人,往我阴暗的小心理上说,是确实运气好。那时的事情,跟今天的大模型还连不成一条直线。

智谱上市

还有一件更残酷的事。
我算是中国比较早投大数据的人,从2010年开始投过几个重要的大数据公司。
回过头看,大模型不是突然蹦出来的。它之前经历过大数据、数据中台、人脸识别等阶段,也有BERT、Transformer这些技术积累。
只是今天投AI有一件很痛苦的事:每三个月就冒出一个新词。好像不讲新名词,就显得不专业。但名词很多,不代表彼此都有显著差别。
真正重要的是往下追:大语言模型在形成所谓Scaling Law之前,借助最多的除了算力和技术能力,还有数据。
互联网文本数据从哪里来?是键盘、鼠标、PC和互联网基础设施普及以后,全世界消费者在过去几十年里共同创造出来的。这才是今天模型最重要的数据基础之一。
从语言走进物理世界,先过数据和因果两道坎
今天大家很着急探索AI模型的上限。但在很多领域,除了技术和能力,还有别的挑战。
机器人最有泡沫的时候,出现了无数做“大脑”的公司。有这么多做机器人大脑的公司,说明一个问题:机器人的脑子现在还不太work。
为什么不太work?先回到互联网文本数据的来源。
键盘、鼠标这些传感器,加上PC和网络,普及到足够多的消费者手里,大家用了足够长的时间,创造出词与词之间几乎所有可能的多样化搭配。
但机器人需要的是带有高精度空间、维度和状态变化信息的数据。
这类数据过去没有同等规模的积累。
你当年在论坛写字、东拼西凑写硕士论文时,并没有想过“我要为将来的大模型贡献语料”。那些数据能够出现,是因为创造数据的传感器先变得便宜、普及,并且对你有用。
我们没有投真人数采,也有可能错过了一些机会。
为什么没投?
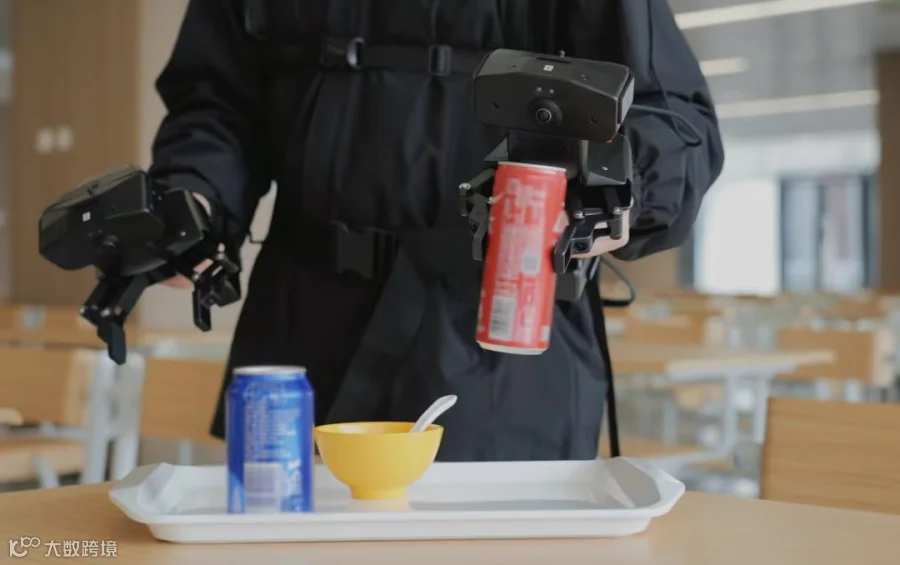
我觉得它们有用,但可以打个比方:为了做语言大模型,因为语料不够,就找一万个人在全世界帮模型写各种各样的小作文。先不考虑成本结构和泡沫变化,这个数据生产过程大概就是这样。

真人数采

如果今天要处理的问题,在高维空间关系上比语言更复杂,就意味着你需要数量级更多的数据。雇一万个人写作文,未必能解决。
第二道坎,是概率与因果。
今天的大语言模型是概率模型,但物理世界的很多问题有确定性的因果关系和绝对约束。
一个东西能不能抓起来,不是“可能抓起来”或者“差不多抓起来”,很多时候就是0和1。手也不能穿过桌子,虽然我很想这么做。
所以到了物理世界,除了缺数据,我们还不确定原来的模型架构,或者说统计上的概率模型,能不能处理绝对约束占比较高的需求。
数字世界里的3D影像和互动世界相对好办,真正进入物理世界,模型在架构、能力和方法论上都可能要变化。
今天能看到几类解决办法。
  • 一类是生成仿真数据,降低数据生产成本,再解决sim-to-real的问题;
  • 一类是尝试zero-shot,没数据直接做,我称之为“用魔法打败魔法”,能不能绕过数据,我不是很确定;
  • 还有一类是在底层加算子、改结构,把物理世界的绝对关系融入模型,甚至尝试不一定基于Transformer的新架构。
模型最后会不会顺着今天这条架构一路演变?我觉得不一定。
自动驾驶已经折腾过很多次,有规则的、纯数据的、白盒的、黑盒的。它还是一个相对简单的物理世界AI场景。
更复杂的问题,最后未必只有一条路,也未必是今天路线的直线延长。
寻找新机会,要往数据产生的地方看
我们还有一个不同的答案:回到历史,看数据到底怎么产生。
为什么会有抖音和快手?因为你把又好、又便宜的光学摄像头放到了手机上,消费者觉得有用,开始大范围制造视频。视频数据足够多以后,又需要不依赖关键词的推荐引擎。这和当年键盘、鼠标带来文本数据,是同一个逻辑。
AI for Science也类似。
今天有AlphaFold,往前追,需要蛋白质结构数据;蛋白质结构数据再往前,需要冷冻电镜等高精度设备。要从基因序列预测结构,还需要大规模基因组数据,而基因组数据又依赖基因测序设备。数据够用了,再叠加上技术和算力,才有可能取得后来的突破。
所以,当你想解决数字世界之外的复杂问题时,除了模型结构,还要问:那类数据从哪里来?是不是需要一种新的设备,先把信息变成数据?
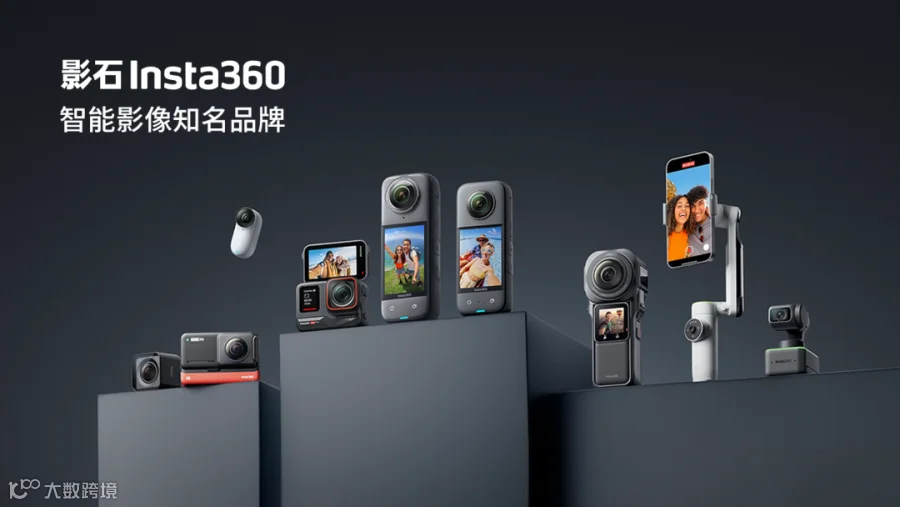
我们2014年投影石时,刘靖康的团队还很小,找我们只花了二十分钟。当时估值2000万元人民币,我们投了400万元。
后来我跟他说,影石和大疆的成功背后,都有一个重要因素:2008年以后,中国精密制造和智能手机产业升级,使摄像头变得又好、又便宜、又小。再叠加图像拼接等技术,才有了全景相机和后来的各类手持影像产品。
把一个特别的传感器做得又小、又便宜、精度又高,再叠加技术,形成能解决新需求的产品,这类产品和数据就会大量产生。回溯大疆、Illumina,以及很多智能硬件的发展过程,都有相似路径。
传感器做的事,就是把信息变成数据。
未来大模型要解决更多问题,一个可能的前提是:人的身上和周边会出现越来越多的传感器。它们以什么产品形态出现,今天很难猜,但数据产生方式的变化,本身就是一个投资方向。
AI被用起来之后,成本和收入怎样算
还有一个common sense的问题,资本市场上很多人选择忽略:今天的AI服务,与互联网时代的单人服务成本不一样。
互联网大部分服务基于数据库或静态数据,除了并发等因素,边际成本即使不是零,也非常低。从服务一万个人到一百万个人,成本不会按人数线性增加。
今天的云端大模型不是。
每一个人提问,都要把问题重新算一遍;如果你像我一样是个话痨,还要把上下文再算一遍。出现第二个话痨,就再算一次。它不是边际成本接近零的生意。
如果有一天资本市场要求基座大模型公司尽快赚钱、减少亏损,会发生什么?一个直接选择是按token收钱。
但按token收钱以后,你还愿不愿意像今天这样,把大模型当搜索引擎用?如果不愿意按次付费,平台要靠广告覆盖成本,又需要加载多少广告?今天的单人服务成本远高于传统搜索,简单多放一点广告未必够。
目前大模型已经明确解决得比较好的问题,是自然语言对话、coding和数学。它们都属于符号表达体系。
自然语言的逻辑相对弱,形式逻辑更严密;编程是给计算机看的形式语言,数学是给数学家看的符号语言。大语言模型在这类问题上已经证明了自己的能力。
但基础设施一旦进入超大规模,就很难长期保持高毛利,否则上面长不出足够多应用。算力基础设施往下追,很重要的成本又是能源。能源竞争过去围绕油、气、煤,运输和区域分布影响了世界格局;如果未来更多价值以token的形式输出,财富和能源的关系也可能改变。
如果token要开始收钱,AI就更容易先进入那些付得起token价格、替代价值足够高的服务。coding可能是其中之一,还有其他场景可以继续探讨。
普通消费者则是另一本账。
想继续用AI搜索,因为一句话就能问,不用挖空心思切关键词,还想用语音输入;但你让我每问一次都付一分钱,我可能就不干。
消费者想保留使用习惯,又希望免费,一个答案就是把模型下放到端侧,至少做到端云协同。
拿智能驾驶打个比方。
如果每一次单独决策都调用云端模型、单独收费——超一次车收一分钱,换一个道收两分钱——你大概就不用了。
今天的智能驾驶更像端侧模型,在本地完成实时决策,停车时再与云端做模型和数据层面的交互。
虽然这个比方绝对化了,但它能说明为什么端云协同会成为一种商业模式。
中国的机会,在应用、产业链和服务业
过去十几年,不管是自动驾驶、人脸识别还是大数据,中国在技术竞争中有一个很典型的特点:从零到一的原创阶段,我们通常在追;一旦到了应用层,技术开始靠具体场景推着走,中国就有机会改变位置。
我在IDG时推过旷视科技。
当时的推理很简单:随着摄像头普及,图像数据会变得极其多;文本数据经历门户网站、垂直门户,最后多到需要搜索引擎来组织,图像数据也会需要新的识别和搜索方式,所以要投人脸识别。
2016年以前,很多人觉得中国的人脸识别技术追不上美国。后来应用迅速普及,再往后,与图像识别相关的学术研究里,中国团队占据了很重要的位置。这就是应用反过来推动技术。
中国到了应用阶段为什么有优势?因为场景多、产业链环节多、链条长,政策也在推动应用。产业链的复杂度和完整度比较高,意味着技术可以尝试的窗口更多。
消费端还有一个更大的beta:服务业。
中国无论生产性服务,还是普通吃喝玩乐,都要继续发展。服务业过去最大的挑战之一,是人均服务成本很难下降,规模化也不容易;很多高附加值服务又高度依赖专业知识,比如金融、教育、健康。
专业知识以自然对话的形式提供服务,理论上很适合语言模型介入。语言模型最有可能帮助的,就是降低专业服务的人均成本,并提高规模化能力。
就像当年淘宝出现时,中国消费零售本身就要发展,只是碰巧赶上了互联网;今天中国服务业要发展,也碰巧赶上了大模型。
新的消费硬件也会出现。
很多新传感器之所以变便宜,是因为先被另一个大产业带起来了。
比如LiDAR的成本下降,很大程度上受新能源车普及推动。传感器降本,再叠加别的需求,就会形成新的应用和硬件形态。这些关系不是直线,但值得顺着往下找。
把问题问具体:企业、普通人和年轻人
未来十二个月重点关注什么?
我会看三类:
第一,必然要解决action问题的方向,而且要从技术上解决,不只是商业模式创新。
第二,新的数据类型和新的数据产生方法,包括进入具体领域的AI for Science。我们过去投过晶泰、剂泰等公司,但AI for Science难投,因为既有模型问题、数据问题,也有最后到底卖什么的问题。卖服务和卖模型可能都很难,最后要交付具体产品。
第三,模型本身的变化,以及端上的机会。消费者和应用习惯一旦形成,就会保留下来;成本与付费方式的变化,会推动新的端侧方案。
中国能不能出现Palantir这样的公司?
坦率来说,比较难。
先略过中美To B企业本身的差异,只看产业链结构:美国保留了较少但高附加值的产业环节,管理工作很大一部分是管理高附加值人群,软件与互联网普及时间也更长,所以To B软件生态较好。
中国产业链很长,其中大量环节是中低附加值或中等附加值,企业最急迫的问题未必都是高教育水平、高人力附加值团队的管理问题。
至于Palantir和SpaceX,它们还带有军工属性。观察这类公司,除了业务,还要把美国政治和资本周期放进去。这不是股票买卖建议,只是宏观如何连接微观的一个角度。
普通人怎样发现AI消费需求?
先把消费硬件放一边,To C上我只有一个怀疑,没有十足把握:中国过去的零售业态与美国、日本都不一样。
零售需求快速增长时,中国赶上互联网普及,却没有先普及信用卡,这些条件共同塑造了今天的电商和支付体系。
同样,AI消费应用也不一定复制海外,要顺着中国自己的需求、产业结构和使用习惯找。中国最大的beta很可能在服务业,尤其是由专业知识驱动、过去难以降低成本和扩大规模的服务。
付不起会员费的人,怎样用上AI?
这里有两个问题。
一个是劳动力技能迁移。
技术进入各个环节后,有些迁移是主动的,有些会被动发生,这是技术发展周期里比较不幸、也很难回避的一面。
另一个还是成本。
大多数人既想用AI,需求又不一定是高附加值、高价值需求。这两件事的夹角,最后只能催生尽量便宜的产品形态,可能是智能硬件,也可能是端侧解决方案。
当年没有包月流量产品之前,很多B站用户先把视频缓存到本地再看。
消费者不是不想用,而是要找到承担得起的使用方式。
AI for Science可以替代一部分高成本研究工作,普通人日常提问却不可能每次都按token单独付高价。
顺着大多数人的需求走,产品就必须更便宜。
模型越来越强,为什么还要弄清它会在哪里失败?
接下来一个很重要的方向,是定义模型的边界,而不只是追逐上限。
AI生成数字化内容会越来越多,速度也会比人快。
短视频和其他平台今天已经需要大量审核,如果AI内容极大增加,不可能只靠人审核,就得用技术解决技术带来的安全问题。
自动驾驶也是一个例子。你知道它能做什么,但那些不能做的事,往往被称为corner case。叫corner case,是因为事先不知道它不能做。不管是L几,如果不知道边界条件,就很难真正建立可靠的系统。
所以,中国和美国都会越来越重视安全治理。模型的上限决定它能走到哪里,边界决定它在哪些地方可能失败,两件事同样重要。
实验室和科研资源越来越强,年轻人创业还有机会吗?
有机会,但要找到属于自己的起点。
2013年投B站以后,我发起过一个“90后的创业者们”活动。那时IC里很多人完全不理解,为什么看不见视频的时候,还要看屏幕上闪过去的字。
后来有了刘靖康做影石、郭列做脸萌,还有映客、B站等一批年轻创业者。他们是互联网native的一代,从初中甚至更早就开始用互联网,使用习惯跟后来才接触互联网的成年人不同。
他们做的事情,往往是自己生活的一部分。
郭列做脸萌,刘靖康做户外运动、极限运动和全景相机,徐逸做B站,都跟自己熟悉的生活方式有关。
所以,年轻人最容易做好的,是属于自己生活方式的东西。
二十岁出头就直接去解决一个非常成熟、非常严肃的科学或模型问题,我不觉得会那么容易。你今天觉得理所当然、上一代人却看不懂的使用习惯,可能就是你的起点。

▹

▹

▹
▹


=▹
👆🏻联系我们 CONTACT US!

转载开白·商务合作·作者招聘·加入社群

请添加微信xingminghui15

【声明】内容源于网络
0
0
潮涌AI
建构AI产业的先进性。
内容 93
粉丝 0
潮涌AI 建构AI产业的先进性。
总阅读3.6k
粉丝0
内容93