文丨李佳晅
智元一直对外说,2026年是机器人进入实际场景的元年。
天凉好个秋。在上海世博中心,智元第四次创新发布日现场,稚晖君率先登台,交出了上半年的成绩单:9700台出货,市场份额全球第一,营收接近20亿;今年9月,第20000台机器人下线。
亮眼的成绩之外,亿邦AI关注到三个更让人印象深刻的看点。
01
硅基牛马的全新度量衡:Worken
机器人真的上岗打工了,工时怎么算才好?
用Worken。
这是稚晖君在演讲中率先抛出的自造词,用来衡量机器人的有效智能工时。他认为,蒸汽时代有“马力”度量机器力量,电力时代有“千瓦时”度量机器能力,AI时代有Token度量机器思考量,物理世界的劳动价值也应该有自己的度量衡。
Worken的由来非常“丝滑”。稚晖君表示,劳动相关,首先想到的词肯定是Work,因为通用机器人在大部分场景里都在像人一样工作。但机器人又不只是传统机器,驱动它的底层代码源于跟大语言模型类似的架构,所以它跟Token也有关系。于是,Work和Token被揉在一起,团队给这个新单位起名叫“Worken”。这意味着机器人既像人一样“上班干活”,又是由模型驱动的智能体。
Worken这个单位由三个乘数共同决定:活跃机器人数量×自主工作时间×产出能效比。这三个变量分别代表着有多少机器人真正被激活、在真实场景中运行,而不是停在仓库里;一台机器人能自主工作多久,是被动工具还是能持续接活的智能体;它的产出能效比,是1:1创造与人等效的价值,还是两台才顶一个人,甚至未来一台能相当于多个人。
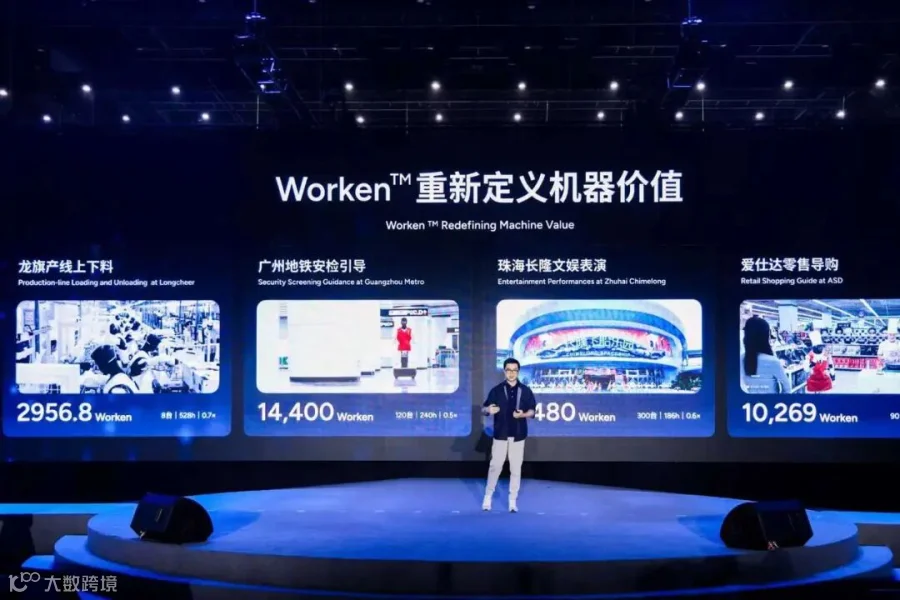
图源:智元
这一概念仍有待细化。智元合伙人、高级副总裁王闯在接受媒体群访时表示,产出能效比,也就是价值密度这个指标当前还是很模糊的。他举了一个酒店场景的例子。使用方认为,一个完整的人要接待住客、帮忙拉行李、引导到前台、送到电梯、送别客人,事情很杂。机器人现在做不到100%,十件事里可能只做到两件;但酒店岗位常常两班倒、三班倒,人站8小时不停工作会很疲惫,机器人却可以一直在岗,和人各有优劣。因此随着更多场景落地,Worken这个概念也会被持续深入挖掘。
不过,一旦Worken成为度量衡,行业谈机器人价值的方式就会变。传统设备出售之后能力基本固定,出厂即巅峰,越用越折旧。但AI机器人不同,硬件本体会折旧,大脑却可以通过模型升级、技能扩展、群体学习不断获得新任务。“硬件会折旧,但智能会升值。”稚晖君说。
02
大模型冲击具身模型,本体公司优势在哪儿
大会现场,智元发布了GO-3 Preview具身基座模型。该模型能做到从预训练、后训练到部署后全链路规模化学习。
这是智元对“具身模型往哪走”交出的答卷。但这场大会并没有只谈自己的模型,Astra直接操控机器人这件事的余韵,也被带到了现场:大模型可以控制机器人之后,具身模型和具身企业该何去何从?
智元合伙人、联席总裁、中央研发部总裁、交互业务体系总裁熊彦在接受媒体群访时表示,不否认Astra在高阶任务规划上的表现,但在实际部署上的短板也很明显。
Astra目前主要走两条路线:一是调用其他模型来生成动作,二是直接Coding生成机器人动作。听起来都可行,但Astra的短板有三个:一是慢,生成动作很慢,一个很简单的动作可能需要分钟级时长;二是贵,调用一次达到上百美元,如果要部署进应用的话,调试成本很高。熊彦直言:“我不相信我们会用5万亿模型做具身部署在机器人身体上的动作,最终落地要有现实性。”
不过他也看到两条路线正在相向而行,即高层用通用模型做规划,最精细的动作、依赖视觉和力触反馈的部分交给专门模型,这种分工“是很可能的”。
智元联合创始人、联席总裁、具身业务体系总裁姚卯青明确表示:用大模型做具身,并不是大模型最擅长、也不是对它最好的利用方式。他认为,尽管大模型可以生成类似CAD的图,但这些能力本质上都停留在“High Level的Reasoning和Planning”。一旦进入高动态、快速、涉及力触和反馈控制的环节,大模型成功率基本为零,因为先天就不具备也没有学习过操作能力。
在他看来,未来的分工是分层的:大模型更多在System2上帮系统提高长程和规划上限;Agentic系统通过Agent、Harness调用工具,而World Model、VLA训练出来的一个个技能和任务操作,就是分层系统里被调用的工具。VLA再往下还有控制层,要做100~1000Hz的实时电机控制,“所有这些和本体、和任务都是非常耦合的,也是需要真正机器人公司不断提升这些层的上限。”
稚晖君则从更长远的角度给出判断,他认为在这种背景下,机器本体将会变得更重要。
他假设了两种未来:第一种,通用AI机器人基础模型越来越强、越来越通用开放,更多开发者都能获得先进智能。“那么谁能够以更低的成本、更高的可靠性把智能装进真实的世界,谁就能够更大规模地把它转化为生产力,这是规模化本体公司的优势。”稚晖君说。
第二种,具身模型长期不那么通用,高度依赖不同本体、不同场景的数据来训练,模型能力长期存在差异,不存在万能大模型。那么,谁拥有大规模真实部署、能够稳定获取高质量数据的渠道和平台,谁就会更具备竞争力。这同样是本体厂商的优势。
但他也表示,不是所有本体厂商都会因此受益,只有真正具备高可靠性、低成本、高性能,同时供应链和规模部署能力都过硬的本体公司,才接得住这个机会。
03
同质化场景的数据泛滥,双目触觉需求强劲
今年以来,说到具身总离不开“数据”。
具身模型要迎来“ChatGPT时刻”至少需要千万小时级有效真机数据,而全球现有高质量真实数据只有数十万~百万小时级,差距以数量级计。于是开源数据集、建训练场和“机器人学校”成为行业普遍选择。智元在2024年底开源百万真机数据集AGIBOT World,2026年初成立数据公司觅蜂科技,预计全年产出数百万小时高质量数据。
行业数据荒尚未解决,但有些场景的数据已经泛滥。
姚卯青在群访中直言,一些非常同质化、没有太多附加值的数据,比如单目、室内场景的裸手数据,尤其是家居叠衣服这类数据,太容易获取了,也很泛滥。供给多,再加上有些人卖过一遍以后低价去市场上复卖,这类数据的价格自然一路下行。
泛滥的另一面,是低质量运营在放大泡沫。很多人盲目进场,先按自己预设的场景、设备、人员管理方式采出一批库存,真正被用户验收时才发现有效率很低。“网上会有人说某某家今年上半年买了100万小时数据,最后只有10%、20%是能用的,这是事实,很多家还是在盲采。”姚卯青说。
低质量数据也不只是场景问题:动作画面会掉帧、过曝、手不在画面里;预处理做不到多摄像头毫秒级时间同步;3D、6D轨迹重建精度差到几厘米,这种数据完全不可用,却非常常见。设备路线同样在分化,姚卯青表示,行业内不少玩家还在跟进单目、Pico采集,但市场主流需求已经往多目、双目、立体、触觉、全身数据转移。
“但细分真实场景的双目、触觉、手套、腕部相机数据的需求非常强劲,且支付能力也很强,因为供应商数量没那么多,单一供应商的整体交付能力也有上限,所以价格还是比较坚挺的。”姚卯青说。