来源|亚马逊研究团队论文《Learning to Bid with AuctionGym》,AdKDD '22 作者 Olivier Jeunen、Sean Murphy、Ben Allison(Amazon, Edinburgh)。
开篇
十多年前做广告出价,逻辑很简单:你愿意承受多少成本,就报多少价。
当时主流是二价拍卖。比如你出价1.00,竞价成功,最后只需要按第二名的报价结算,假设对方是0.72,你就付0.72。报高了纯属浪费,报低了拿不到流量,如实出价就是最优选择。
但这套规则早就变了。现在绝大多数主流平台,都换成了一价拍卖:你报1.00,竞价拿下,就要实打实支付1.00。
旧的标准答案不再适用。出价变成一场权衡:既要尽量保证竞价能赢,又不想多花冤枉钱。这也是现在所有广告调价的底层难点。
亚马逊专门发过一篇论文,研究这套规则下该怎么出价,得出的结论并不乐观。
论文里提到两个关键点:
广告主看不到那些自己没有提交的出价对应的竞价结果。
而高手玩家,会持续跟着对手的出价动态调整策略。
把两点放在一起就能明白:单纯依靠历史数据去学习、评估出价,本身就很难跑通。 不是你的判断或者调价思路有问题,而是用来分析的数据,本身就是残缺的。
这篇内容,主要聊三件事:这个数据缺口是怎么来的、为什么很难补上、以及我们实际可以怎么做。
一、调价其实一直在做两件事
在讲那个洞之前,先说清一件常被忽略的事:调价不是「选一个数字」。
它同时在做两件事。
一件是学,这次展示值多少钱、我该出多少;
另一件是评,我上次调对了没有、下次往哪调。
你每天说的「优化」,就是这两件事在循环:学一次、评一次、再学一次。而它们用的是同一份数据——你的后台报表。
问题就出在这。论文整篇在论证一件事:这份数据缺了一块,而缺的那块恰好是判断对错最需要的。
顺带说清它的立场,免得你误会。它算的是广告主自己的账:赢下这次展示的价值,减去你付的价格,剩下的就是你的剩余。
它研究你该出多少钱,不是平台该收多少钱。论文自己也承认:出价策略把剩余做到最大,会不可避免地让拍卖方收入下降。
对卖家来说,它现在还不能直接当工具用,连广告主预算都还没模拟进去。但它给了三样东西。
一个解释:你调不准,因为数据缺一块。
一套标签:把每次没调好的调价分成四类。
一个预期:调价效果有保质期。

二、两个「看不见」
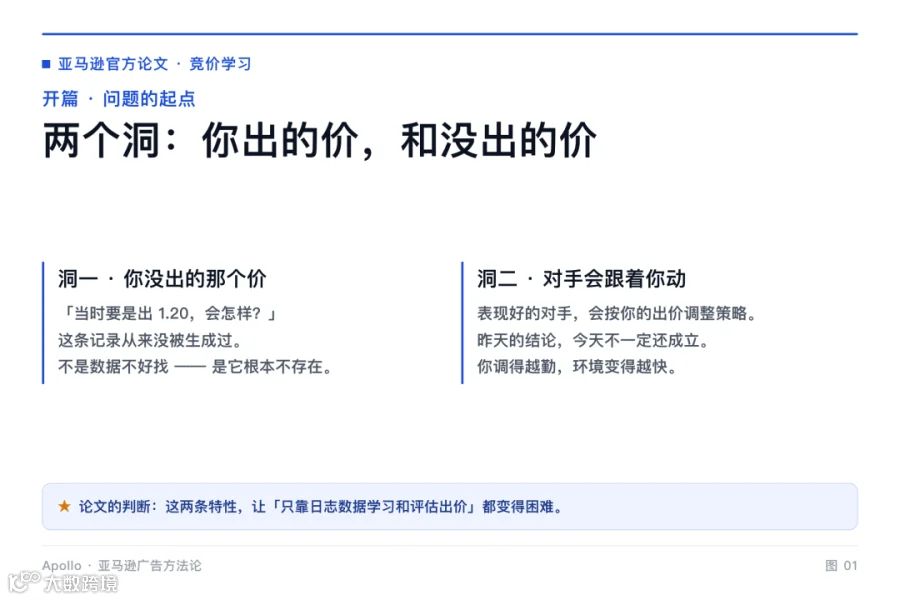
第一个洞:你没出的那个价,结果永远不会出现。
举个例子:你出价1.00,拿下这次曝光,实际结算0.72。后台会清清楚楚记下这条记录:时间、花费、转化订单,一应俱全。 但你当时心里考量过的另一个出价1.20,因为最终没有提交,对应的结果就不存在。不是数据丢了,也不是平台没保存——它从一开始就不会产生。
如果当时报1.20,能不能抢到更多曝光、单次成本又会变成多少?系统不知道,你也无从得知。 报表只能还原你实实在在走过的路。至于旁边其他选择的那条路是什么结果,它看不见,也不可能看见。
论文里把这个叫做反事实问题。这点分量很重:这不只是数据量不足、样本太少,而是这部分结果根本就没有发生过。哪怕你把投放预算放大十倍,拉满三年的历史报表,这些缺失的信息依旧不会凭空出现。
落到卖家实操上,这件事很扎心:我们所有调价判断,都只能基于“我当初选了什么、发生了什么”。 可我们永远无法知道,如果当初不这么选,结局会如何。但恰恰是后者,才是检验出价到底对不对的标尺。
第二个洞,会更加棘手:竞争对手会跟着你的出价动态调整。
你8月测试出来,这个关键词出价1.00性价比最好,等到9月沿用这套出价,却发现效果不对。原因很简单:竞价环境早就变了。 变化的源头就是你自己。对手观测到你的出价动作,随之调整他们的策略;而对手的改动,又直接融进了你9月拿到的数据里。 你8月摸索出来的最优出价,适配的是8月那一批对手的竞价行为。到了9月,对局环境早就换了模样。 好比拿着8月的行情价,去谈9月的房子——市场早就被前面的买家带动,水涨船高了。
论文的说法是:这种反应效应,光靠历史数据不足以捕捉。
两个洞叠加在一起,困境就很清晰了: 学习出价学不准,因为缺少那些没有发生的出价结果;评估效果评不准,因为你的调价行为本身,已经改变了竞价环境。
我们日常口中的复盘,说到底,只能看见“调整出价之后发生了什么”。它回答不了最关键的问题:假如我不做这次调整,又会是什么局面。 说白了,你手里的报表,仅仅是你已经走过的那条路;其余备选路径的数据,从始至终都不会生成。

你手上的报表 = 你走过的那条路;旁边那几条从来没被生成过
三、为什么这两个洞补不上
上一节我们聊了两个洞,这一节来说说:为什么这两个洞根本补不上。
可以把每一次广告曝光想象成打靶。靶子就是一次曝光机会,你打出的那一枪,就是提交的出价;打中靶子,代表竞价获胜、广告成功展示,你付出的成本就是CPC。
一轮射击结束之后,靶场只会反馈你有没有打中、花了多少钱。那些你扣扳机前犹豫过、最终没有打出的子弹,对应的位置一片空白——这就是第一个洞。
而更棘手的一点是:靶子会跟着你的枪口移动。你打得越准,它躲得越快。 昨天反复打磨出来的手感,到今天,面对的已经是另一个位置的靶子。这就是第二个洞。
它不只是数据少了一块那么简单,而是缺失的这一块一直在变形。你每调一次价,竞价环境就跟着变一分;变化后的环境,又会变成你下一次判断的依据。
这也是为什么调价学来学去,始终稳不住。本质原因很直白:你打的不是固定靶。
这里记住一个核心结论就够了:目前所有用来估算「没发生过的出价结果」的办法,都藏着同一个默认前提——对手不会因为你的操作而调整。
但论文直接点明,这个假设放到真实投放里并不成立,原话分量很重:不可救药地有偏。
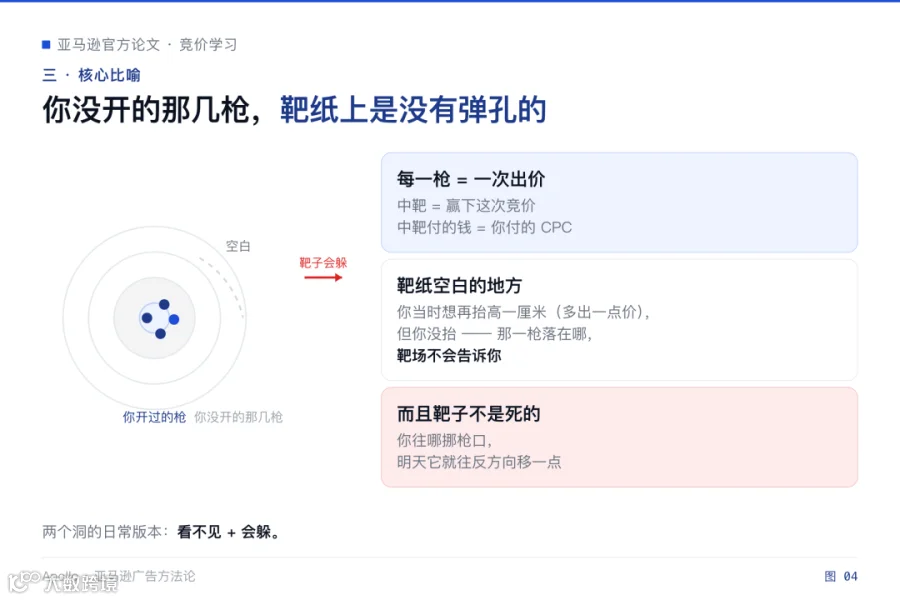
靶纸空白的位置是「你没出的价」,靶子还会跟着你的枪口移动
四、三条路都堵了,只剩造一个靶场
看清这两个洞之后,大家自然会问:有没有办法绕过去?论文逐一推翻了三条看似可行的路子。
第一条,靠复盘历史数据,用过往记录倒推:
当初如果换一个出价,结果会如何。这条路有两个硬伤。
首先是古德哈特定律:任何可观测到的统计规律,一旦拿来当成调控指标,规律本身就很容易失效。 你依靠数据算出一套出价策略,再用这套策略指导投放动作;而你的动作,又会改变后续数据的生成逻辑。到头来,好不容易推算出来的规律,下一轮就不再管用。 还有一个更底层的矛盾:所有反事实估算,都默认对手不会变动。而上一节我们已经讲过,这个前提在真实竞价里站不住脚。
第二条,直接在真实市场里做实验。
听着最靠谱,代价却高得吓人,论文列出了三重成本。
新策略先要打磨到能上线投产的工程标准;A/B测试起码要跑上好几天,数据才有统计价值。 最让人头疼的是:主动去测试一套明知道不是最优的方案,相当于拿真实生意主动亏钱。 “道理上我知道该测,但实在不敢测。”这句话,很多做广告投放的人应该都深有体会。
第三条,等着别人把现成答案送上门。
这点论文没有提到,是我补充的。行业里没人有义务公开自己踩过的坑、沉淀出来的有效打法。
三条路全都走不通,最后剩下唯一方向:搭建一块可以自由试错的模拟场。想测试多少次都行,就算试错失败,也不会产生真实花费。

日志有偏、线上太贵,论文用三个理由否掉了两条路
五、靶场里怎么练,和实验证明的三件事
论文自己就搭建了这么一个模拟环境,而且已经开源,名字叫 AuctionGym。
整套模拟循环一共五步:曝光机会产生 → 推送给一众竞价广告主 → 各方分别选定广告、给出出价 → 平台判定竞价赢家并结算费用 → 赢家拿到曝光,有机会产生转化。
重点看最后一步:转化数据只有竞价成功的人才能看见;输掉竞价的人,永远不知道自己本来可能拿到什么结果。这正是前面说到的两个洞,在模拟环境里原样复刻了出来。
这套循环还有一处贴近真实投放的细节:要累积多轮竞价才算一次迭代,出价方必须等上一批结果返回之后,才能更新策略。这就是延迟批量反馈。 放到现实里很好理解:我们不可能刚调完出价,马上就能看到这次调整的全部效果。
AuctionGym 支持模拟一价拍卖、二价拍卖、硬底价、软底价,这几种竞价模式都附带了可运行代码。 但论文也坦诚列出了它的三大局限:无法模拟广告主预算、多物品拍卖、学习型拍卖机制。
连预算变量都没有加入,足以说明它本质是研究工具,不是拿来直接用的自动调价插件。这点一定要先跟卖家讲明白,别以为装个代码包,隔天就能实现全自动调价。
模拟靶场搭好了,那该怎么在里面练习出价?论文给出了三种思路。
第一种,先搭建模型再决策,论文称之为基于价值的方法,也叫直接法。
先训练模型,判断每一次曝光机会到底值多少钱;面对每一次流量,直接选择预估收益最高的出价。好比先把射击手册背熟,再举枪瞄准。 它的优势是稳定,但会带着固定偏差。一旦底层模型本身就有问题,每一枪都会往同一个方向偏;同时它不会主动去尝试新的出价。 放到卖家的日常投放里,就是一套固定调价逻辑:ACoS高于阈值就降价,低于阈值就加价。 执行起来稳稳当当,可如果这套规则本身不对,你就会持续、稳定地做错。
第二种,依托真实投放的样本比例计算,论文叫基于策略的方法,依靠重要性采样实现。
用历史真实数据,按照新旧两种出价策略的概率差做加权计算,理论上可以抵消偏差。 它的特点刚好和第一种相反:理论上更准,但波动很大。有些在旧策略里很少出现、但转化不错的出价,会被赋予过高权重。 一个偶然的极端情况,就足以带偏整体判断。 对应卖家场景:只拿短短3天的数据做决策,某天碰巧爆了一单大订单,就判定这个关键词潜力极强。数据本身不假,但推导出来的结论是错的。
第三种,把前两种方案结合在一起,也就是双稳健方法:
用模型结果作为基准,再通过采样权重去修正模型自带的误差。理论上只要模型、权重二者之中有一个是靠谱的,估算结果就能做到无偏。 不过论文特意补充了一句:这不代表落地到业务里就一定能拿到更好的效果。很多算法论文里亮眼的“理论保证”,落到真实生意里,效果都会打折扣。

整套流程就是:流量机会出现、分配竞价、各方出价、判定赢家、曝光转化;多轮竞价结束后,才会收到一批反馈。
这次实验的设置是:每一轮从6个出价方里选出2人参与竞价,每个出价方持有12条广告;一共跑了5组随机种子,输出95%置信区间,累计完成超3700万场模拟拍卖,测试了36000套出价策略。
实验核心调整的变量,是策略更新频率,放到实操里,就是我们多久重新核算一轮出价。一共测了三档:2000轮、5000轮、10000轮,还有一组拉长到20000轮对照。
这个变量很戳日常投放的痛点:更新太频繁,等于跟着随机噪声追涨杀跌;更新太慢,靶子早就挪位置了,你还对着旧目标开枪。
实验得出三个核心结论:
第一种“背手册”的基于价值法,收敛速度最快,但最终只会卡在次优解。动作很稳,却带着固定偏差——稳,从来不等于准。
第二种纯基于策略的方法,方差大到难以驾驭。它需要巨量的学习步数才有可能追上第一种方案;而且波动不定的出价选择,会持续污染后续用来训练的数据,越学越偏。
第三种双稳健的组合方案,两边优势都拿到了:收益剩余更高,波动远小于第二种,ROAS和出价过高的问题都能持续优化。
图表里还有一处值得留意:第二种方法跑到大约100万次拍卖之后,出价太高带来的损失(后悔值)降下来了,但出价太低的损失反而小幅上涨。 压低出价,确实能避免报高亏钱,代价就是容易出价保守、拿不到流量。这里藏着一个没有标准答案的取舍:你更害怕多花钱,还是更害怕丢曝光?
论文没法替你做这个选择,最终怎么权衡,完全取决于你自己的利润结构。

低方差高偏差、高方差、双稳健
六、四类后悔:把「没调好」拆成四个问题
前面一直在拆解出价这件事为什么难做,这一节落到实处:我们该怎么办。
论文把出价失误分成四类后悔,每一类对应的调整动作完全不一样。这也是整篇内容里,对卖家最有落地价值的部分。
很多人看到调价效果不好,只会笼统一句“没调好”,本质是把四种问题混在了一起,自然找不到真正要改的地方。
分配后悔:预算放错了关键词,钱投在了不该投的地方。
估计后悔:对流量价值判断出错,底层估算本身就带着偏差。
出价过高后悔:报价抬太高,拿下流量的时候多花了冤枉钱。
出价过低后悔:报价太保守,本该拿到的曝光和订单白白流失。
具体怎么用?
每次调价复盘的时候,先给这次的问题打上对应的标签。 如果是出价过高,你缺的是克制抬价、及时压价的纪律;如果是出价过低,就要警惕持续降价正在不断吃掉你的流量。 如果是分配后悔,问题根本不在出价数字,而是预算在各个关键词之间的分配不合理;如果是估计后悔,说明从最开始对这次流量价值的判断就歪了。
这四类的边界很清晰:前两类,调整的是预算怎么分配;后两类,调整的才是出价高低。一旦方向判断错了,越是使劲调,偏差就越大。

把「没调好」拆成四类,对应四种完全不同的动作
七、你自己账户里能做的四件事
这一部分是我们落地转化的思路,不属于论文原文。
先讲一句实在话:论文里这套算法,普通人很难直接跑起来。AuctionGym需要你从零搭建一整套竞价模拟环境,里面的实验配置,和你亚马逊后台账户本来就不是一回事。
但这不代表论文对我们没用,我们要的不是复现算法,而是它指明的行动方向。
第一点,主动去创造那些「你没有出过的出价」。
同一个商品、同样的搜索意向,搭建两套结构一致的投放计划,用不同出价策略同步跑足够久,再拿来对比。 其中一组数据大概率会跑得不好。但这条表现偏弱的计划,恰恰是你花钱换来的、最稀缺的信息——它就是原本不可能自动生成的对照组。 很多卖家第一反应都是关掉差的计划,这点刚好反直觉:在这里,那条跑得不好的计划,才是帮你看清真相的答案。
第二点,调价之前先留存数据快照。
把调价前7天的花费、订单、ACoS、CPC全部记录下来;调整完成之后,固定在第7天、第14天分别复盘核对。 重点是一定要在调价前存档。事后凭着印象补的数据不算数。这件事看着简单,却最容易偷懒,而一旦偷懒,后面所有的效果判断都会失真。
第三点,给每一次调价打上对应的后悔标签,用上一节说的四类标准持续记录。
连续记录8到10次,你就能看清自己的调价问题集中在哪一类。 如果十次里面有六次都是出价过高,本质问题就是你缺少果断压价的定力;大部分记录都是出价过低,则说明一味降价,正在持续损失你的流量。
第四点,不要盯着单一指标做优化。
只拿一个指标当目标,你越盯着它优化,这个指标就越容易失真、失去参考价值。 每次调价复盘,至少同步跟踪花费、订单量、ACoS,同时记下曝光和点击。有时候你看着ACoS变好看,其实只是单量缩水了;单量下滑和成本优化,在ACoS报表上看起来可以完全一样。

存快照、设定固定回看节点、给调价打上后悔标签。
最后再划清边界。
论文本身也写明了三处局限:它没有模拟广告主预算、不支持多物品拍卖,也没有纳入学习型拍卖机制。
缺少预算约束,就意味着这套模拟里不存在“预算不够花”的困境。可预算吃紧,恰恰是卖家日常投放里最核心的现实枷锁。
守住两条纪律:
第一,所有实验数据都来自仿真环境,不等于你真实账户里就能跑出同等收益,如果拿它当收益保证,就是曲解了原文。
第二,前面分享的四条落地动作,都只是近似的实操办法,目的是把论文的思路转化成日常习惯,并不是论文本身得出的结论。
总结
竞价优化走到最后,困住大家的从来不是操作技巧,而是信息本身。
一价拍卖把曾经那个标准答案彻底取消,出价变成一场猜测;猜不准的根源,就是我们前面聊的两个洞:你没提交过的出价不会产生结果,而且对手会跟着你的出价持续调整。
评估,甚至比学习出价更难。历史数据可以用来摸索出价,但没法帮你准确判断对错——因为我们在用数据复盘时,总会下意识假定对手保持不变。
论文给出的思路,是搭建模拟靶场做测试,实测里双稳健方案综合表现最好。但也要清楚它的局限:它只是理论上可以做到无偏,并不代表落到你的账户里就一定能拿到更好的结果。
对卖家而言,整篇内容最值钱的其实是两个副产品:把调价失误拆成四类后悔的复盘框架,以及认清一个现实——调价的效果是有保质期的。
落到今天可以马上动手的三件小事:
调价前留存数据快照;
提前定好第7天、第14天两个复盘节点;
复盘的时候,给这次调价打上对应的后悔标签。
但有一点值得思考:如果连目标ACoS都定不合理,AI调价再精准,又能帮你解决多少问题?
工具可以替你执行,却不能替你决定哪些流量值得争取、哪些预算应该收回来。这些判断,才是真正影响广告利润和增长的关键。


首个AI全链路跑通案例:新品14天从0到日销100单
2026-04-27
运营花几天搭建的关键词库, Codex不到1小时完成:亚马逊运营效率正在被重新定义
2026-08-04

提升自然订单,不是多开广告:4步搭建正确广告架构
2026-08-21

亚马逊新规:变体评论不再全部共享,哪些产品会受影响?
2026-08-22

新品一上架就开大预算广告,真的能快速推起来吗?
2026-08-13
亚马逊Listing进入CDQ时代?关于评分、属性和排名,官方到底怎么说
2026-08-12
[案例分享]断货30天 我如何几天做回到日出200单
2026-07-22